AI không chỉ học Internet: NASA cho một model học 17 năm dữ liệu để “đọc” bề mặt Mặt Trăng
NASA và IBM vừa mở mã một foundation model dành riêng cho khoa học Mặt Trăng, được tiền huấn luyện trên gần 2 triệu “ô” dữ liệu từ LRO cùng nhiều lớp địa hình, nhiệt, radar và khoáng vật học. Model có thể được tinh chỉnh để tìm hố va chạm, khoanh vùng cấu trúc núi lửa trẻ và ước tính nơi băng có khả năng ổn định — nhưng nó không phải một LLM và các đầu ra khoa học vẫn cần được kiểm chứng bằng dữ liệu quan sát.

Phần lớn cuộc trò chuyện về foundation model hiện nay xoay quanh văn bản, ảnh trên Internet và chatbot. NASA và IBM vừa đem cùng ý tưởng đó sang một loại dữ liệu khác hẳn: 17 năm quan sát Mặt Trăng từ tàu Lunar Reconnaissance Orbiter, kết hợp với dữ liệu địa hình, nhiệt, radar, trọng lực và khoáng vật học từ nhiều sứ mệnh.
Kết quả là NASA-IBM Lunar Foundation Model, một model mã nguồn mở được thiết kế cho viễn thám Mặt Trăng. Nó không trò chuyện và cũng không “hiểu” Mặt Trăng theo nghĩa của một trợ lý ngôn ngữ. Thứ model học là các quan hệ giữa nhiều kiểu phép đo về cùng một vùng bề mặt, để sau đó có thể được tinh chỉnh với tương đối ít dữ liệu gán nhãn cho những nhiệm vụ như phát hiện hố va chạm, phân đoạn cấu trúc núi lửa hoặc ước tính khu vực có điều kiện thuận lợi để băng tồn tại.
NASA công bố model ngày 10/9/2026 và phát hành trọng số trên Hugging Face, cùng code phục vụ fine-tuning trên GitHub. Đây là một ví dụ khá rõ về hướng AI for science: thay vì để model học cách dự đoán từ tiếp theo trong một kho văn bản khổng lồ, người ta cho nó học cấu trúc của một kho dữ liệu khoa học được thu thập bằng các thiết bị vật lý.
17 năm dữ liệu không phải là 17 năm ảnh giống nhau
Lunar Reconnaissance Orbiter (LRO) bay quanh Mặt Trăng từ năm 2009. Trong thời gian đó, nhiệm vụ đã tạo ra lượng dữ liệu mà NASA mô tả là lớn hơn tổng dữ liệu của tất cả các sứ mệnh hành tinh khác của cơ quan cộng lại. Riêng tập tiền huấn luyện của Lunar Foundation Model chứa gần 2 triệu tile: khoảng 1 triệu tile từ Narrow Angle Camera ở độ phân giải xấp xỉ 1 mét mỗi pixel và 963.609 tile từ Wide Angle Camera ở khoảng 100 mét mỗi pixel.
Điểm khó nằm ở chỗ một “ảnh Mặt Trăng” không có nghĩa duy nhất. Camera quang học nhìn thấy độ phản xạ của bề mặt. Dữ liệu địa hình cho biết độ cao, độ dốc và hướng sườn. Diviner đo các đặc tính nhiệt. Mini-RF cung cấp radar. GRAIL đo trường hấp dẫn. Lunar Prospector góp dữ liệu hydrogen, còn sứ mệnh SELENE/Kaguya của JAXA bổ sung thông tin khoáng vật học.
Model card của dự án gom các sản phẩm này thành 11 modality, trong đó chín modality là các lớp dữ liệu dạng ảnh, cộng thêm metadata quan sát và ngữ cảnh từ các bản đồ tĩnh. Nói cách khác, model không chỉ học xem một miệng hố “trông như thế nào” trong ảnh chụp; nó có cơ hội học mối liên hệ giữa hình dạng, độ dốc, nhiệt độ, phản xạ, radar và các phép đo khác trên cùng khu vực.
Ánh sáng trên Mặt Trăng là một biến số mà model phải học cách không bị đánh lừa
Một trở ngại lớn của thị giác máy trên Mặt Trăng là ánh sáng. Không có khí quyển dày để tán xạ ánh sáng như Trái Đất, bề mặt Mặt Trăng có những vùng chói mạnh nằm sát bóng tối sâu. Góc Mặt Trời thay đổi cũng có thể khiến cùng một miệng hố trông rất khác trong hai lần chụp.
NASA-IBM Lunar Foundation Model xử lý vấn đề này bằng cách đưa hình học thu nhận ảnh vào đầu vào của model. Các thông tin như góc tới của ánh sáng Mặt Trời, góc quan sát, pha, phương vị, tọa độ điểm dưới Mặt Trời và độ phân giải mặt đất được mã hóa cùng dữ liệu ảnh.
Đây là một khác biệt quan trọng so với việc đơn giản ném hàng triệu ảnh vào một mạng thị giác. Nếu model không biết ánh sáng chiếu từ hướng nào, nó có thể nhầm bóng đổ do góc chiếu với đặc điểm địa chất thật. Nhóm phát triển chọn cung cấp trực tiếp biến vật lý này thay vì buộc mạng phải tự suy ra nó từ pixel.
Model học bằng cách che dữ liệu rồi bắt mình đoán phần bị thiếu
Kiến trúc của model là một ViT-B encoder–decoder, tức một Vision Transformer cỡ base, được huấn luyện từ đầu trên dữ liệu Mặt Trăng. Phương pháp tiền huấn luyện dựa trên TerraMind — foundation model viễn thám do IBM và ESA phát triển — với mục tiêu masked-token.
Cách hiểu trực quan là model được đưa cho một phần thông tin và phải dự đoán phần đã bị che. Ví dụ, từ một số modality còn lại, nó học biểu diễn giúp tái tạo hoặc dự đoán cấu trúc của modality mục tiêu. Qua rất nhiều ví dụ, model hình thành một không gian biểu diễn chung cho các quan sát khác nhau của bề mặt.
Một chi tiết kỹ thuật đáng chú ý là model được huấn luyện đồng thời với hai họ dữ liệu cách nhau khoảng 100 lần về độ phân giải không gian: NAC ở cỡ 1 m/pixel và WAC ở cỡ 100 m/pixel. Hai loại tile không bị ép về cùng một thang vật lý trước khi học; một bộ trọng số được dùng cho cả hai họ dữ liệu.
Quá trình pre-training theo model card sử dụng 16 GPU H100, 150.000 bước và khoảng 1.100 GPU-giờ. Đây không phải quy mô của một LLM thương mại khổng lồ, nhưng đủ để tạo một backbone chuyên dụng mà các nhóm nghiên cứu khác có thể lấy về rồi tinh chỉnh cho nhiệm vụ riêng.
“Đọc” Mặt Trăng ở đây nghĩa là gì?
NASA và IBM thử model trên một số bài toán mà nhà khoa học hành tinh thực sự quan tâm. Với hố va chạm, model được fine-tune để phát hiện các cấu trúc hình tròn trên ảnh ở cả thang 100 m/pixel và 1 m/pixel. Đếm và đo crater là một công cụ quan trọng để suy ra tuổi tương đối của bề mặt vì khu vực càng lâu không bị tái tạo thường tích lũy càng nhiều dấu vết va chạm.
Một nhiệm vụ khác là phân đoạn irregular mare patches (IMP), những cấu trúc núi lửa có hình thái bất thường và được quan tâm vì một số có vẻ trẻ hơn kỳ vọng đối với lịch sử hoạt động núi lửa của Mặt Trăng.
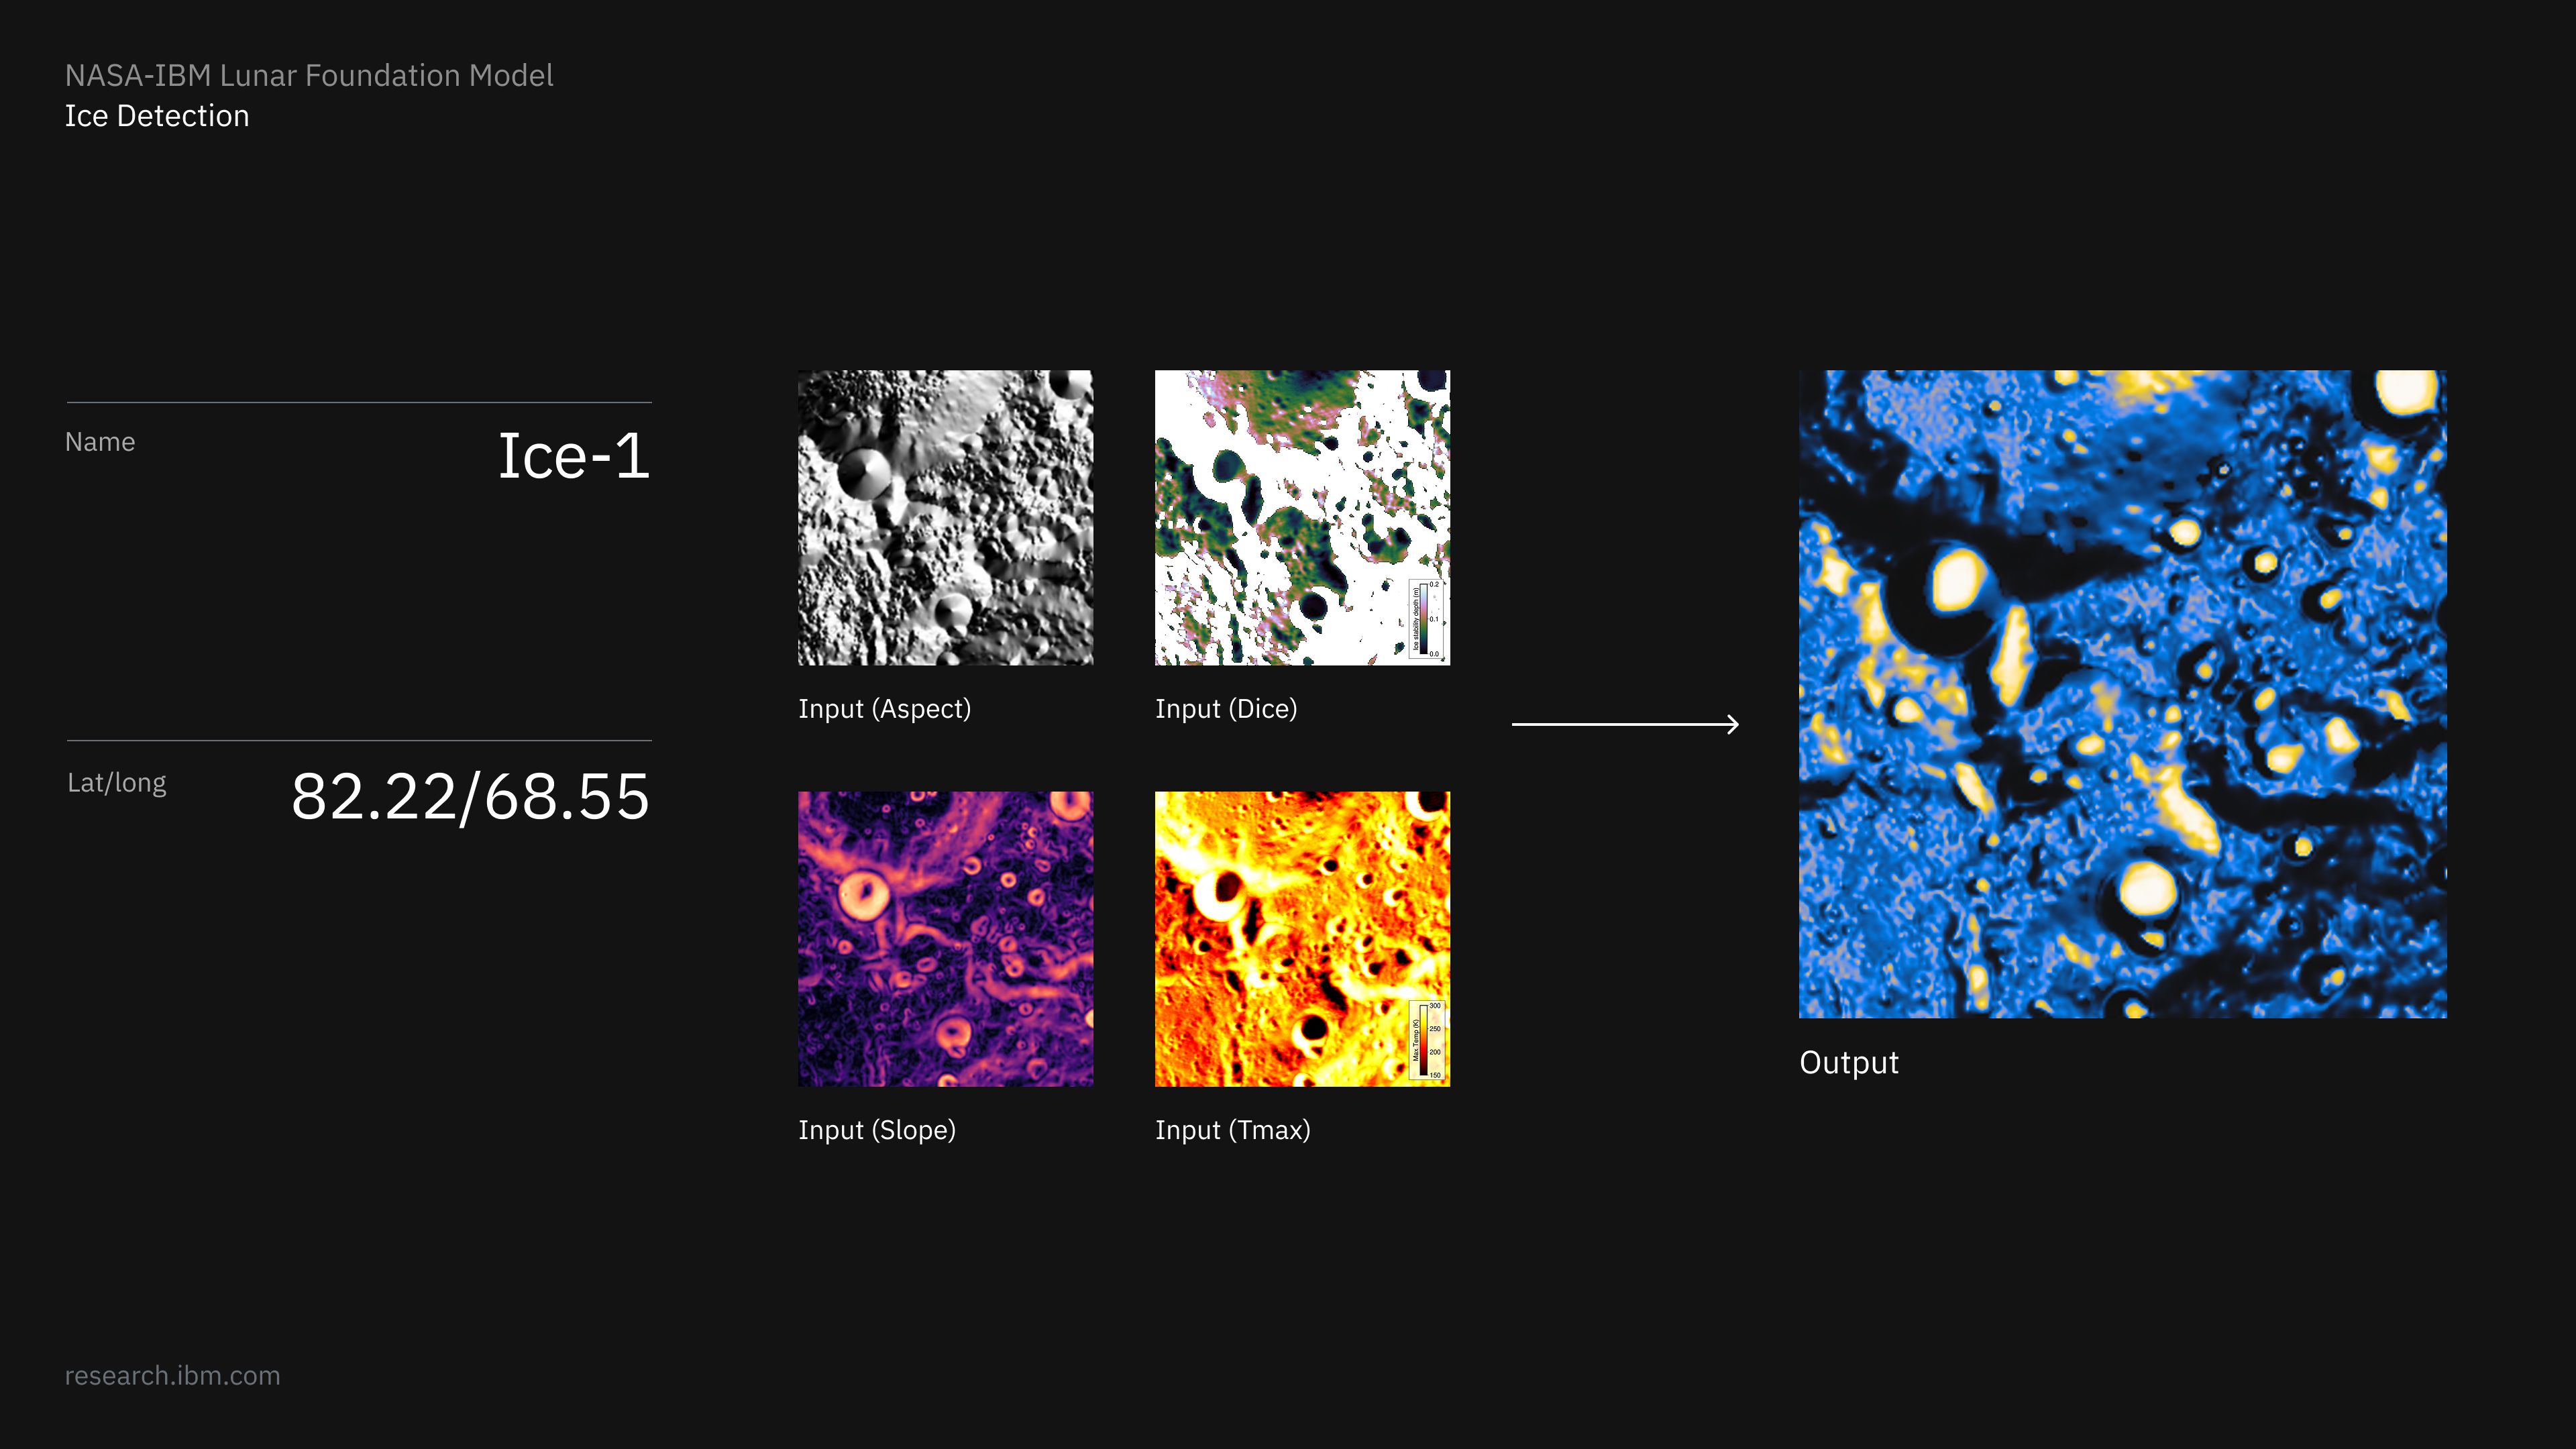
Bài toán thứ ba là ice prospectivity ở vùng cực. Ở đây model kết hợp các lớp như độ dốc, hướng sườn, nhiệt độ bề mặt tối đa và độ sâu ổn định của băng để dự đoán một bản đồ mức độ thuận lợi cho băng tồn tại. Trên benchmark này, RMSE tốt nhất của Lunar Foundation Model là 0,0293 so với 0,0377 của baseline SwinV2-B tốt nhất — mức giảm lỗi khoảng 22%.
Nhưng cần đọc đúng con số đó. Model không trực tiếp phát hiện băng. Model card nói rõ đầu ra ice prospectivity đang học lại một bản đồ tham chiếu được xây dựng từ mô hình và các quy tắc khoa học, chứ không phải bản đồ đo trực tiếp lượng băng dưới đất. Vì vậy màu vàng trên ảnh dự đoán không đồng nghĩa “ở đây chắc chắn có nước”.
Foundation model hữu ích nhất khi dữ liệu gán nhãn đắt
Điểm mạnh mà NASA muốn khai thác không nhất thiết là đạt một kỷ lục benchmark. Trong khoa học hành tinh, dữ liệu thô có thể rất nhiều nhưng dữ liệu được chuyên gia gán nhãn lại ít và tốn công. Một foundation model đã học trước cấu trúc chung của dữ liệu Mặt Trăng có thể giảm lượng ví dụ cần thiết khi chuyển sang một nhiệm vụ mới.
Trên benchmark crater ở dữ liệu WAC, các biến thể đã pre-train với chỉ 50% dữ liệu huấn luyện vẫn đạt hoặc vượt một số baseline được huấn luyện với toàn bộ tập. Với crater ở độ phân giải 1 mét, Lunar Foundation Model và baseline mạnh nhất gần như ngang nhau; nhóm tác giả cũng không tuyên bố một chiến thắng rõ ràng vì chênh lệch nhỏ hơn biến thiên giữa các lần chạy.
Sự thận trọng này quan trọng. Foundation model khoa học có giá trị nếu nó giúp tái sử dụng kiến thức giữa nhiều bài toán, chứ không phải vì mọi benchmark đều phải thắng với khoảng cách lớn.
Nó chưa phải “phi công AI” chọn chỗ hạ cánh
Model card đặt ra những giới hạn khá cụ thể. Lunar Foundation Model không duy trì một hệ quy chiếu trắc địa tuyệt đối: nó có thể học hình dạng địa hình cục bộ nhưng giá trị độ cao tuyệt đối có thể bị lệch, còn tọa độ được sinh ra trong chế độ generative thậm chí có thể sai hàng chục độ.
Nhóm phát triển cũng nói rõ các trường sinh ra từ model không phải dự đoán khoa học đã được hiệu chuẩn và không thể thay cho thiết bị đo, stereo photogrammetry hay nghiệm trắc địa. Model chưa được xác nhận cho những quyết định vận hành như chứng nhận bãi đáp hoặc đánh giá an toàn địa hình.
Phạm vi dữ liệu cũng không đồng đều. Dữ liệu NAC độ phân giải cao dùng cho pre-training chỉ xuất hiện tại những vùng có ảnh và mô hình địa hình stereo đồng đăng ký phù hợp; nó phân bố trên toàn cầu nhưng không phủ dày toàn bộ Mặt Trăng. Một model học từ kho dữ liệu như vậy sẽ mang theo chính những khoảng trống của kho quan sát.
Từ Internet sang kính thiên văn, vệ tinh và tàu thăm dò
Lunar Foundation Model nằm trong một chuỗi dự án NASA–IBM đang thử cùng một công thức trên các miền khoa học khác nhau. Prithvi học dữ liệu quan sát Trái Đất; Surya học dữ liệu Mặt Trời; model mới chuyển ý tưởng đó sang khoa học Mặt Trăng.
Điều đáng chú ý không phải AI bắt đầu “thay nhà khoa học đọc Mặt Trăng”. Vai trò thực tế hơn là nén một kho quan sát khổng lồ thành một representation có thể tái sử dụng, rồi để các nhóm khoa học xây detector, segmentation model hoặc regression model chuyên biệt ở phía trên.
NASA và IBM đã mở trọng số, dữ liệu benchmark và code fine-tuning để cộng đồng có thể kiểm tra điều đó thay vì chỉ dựa vào demo. Bài kiểm tra tiếp theo sẽ là liệu các nhóm độc lập có dùng backbone này để giải quyết những câu hỏi khoa học mới — trên dữ liệu mà model chưa được tối ưu sẵn — và vẫn giữ được độ chính xác đủ để kết quả có ý nghĩa khoa học hay không.