Bác sĩ vẫn lái dụng cụ bằng X-ray phẳng: AI MIT ghép nó với CT/MRI thành “GPS 3D” trong vài giây
Hệ thống xvr của MIT không dựng cơ thể 3D từ X-ray đơn lẻ. Nó học từ CT hoặc MRI 3D có sẵn của chính bệnh nhân, rồi tự động căn ảnh X-ray fluoroscopy trong lúc can thiệp vào đúng vị trí trong không gian 3D với độ chính xác dưới milimet trong các thử nghiệm của nhóm.

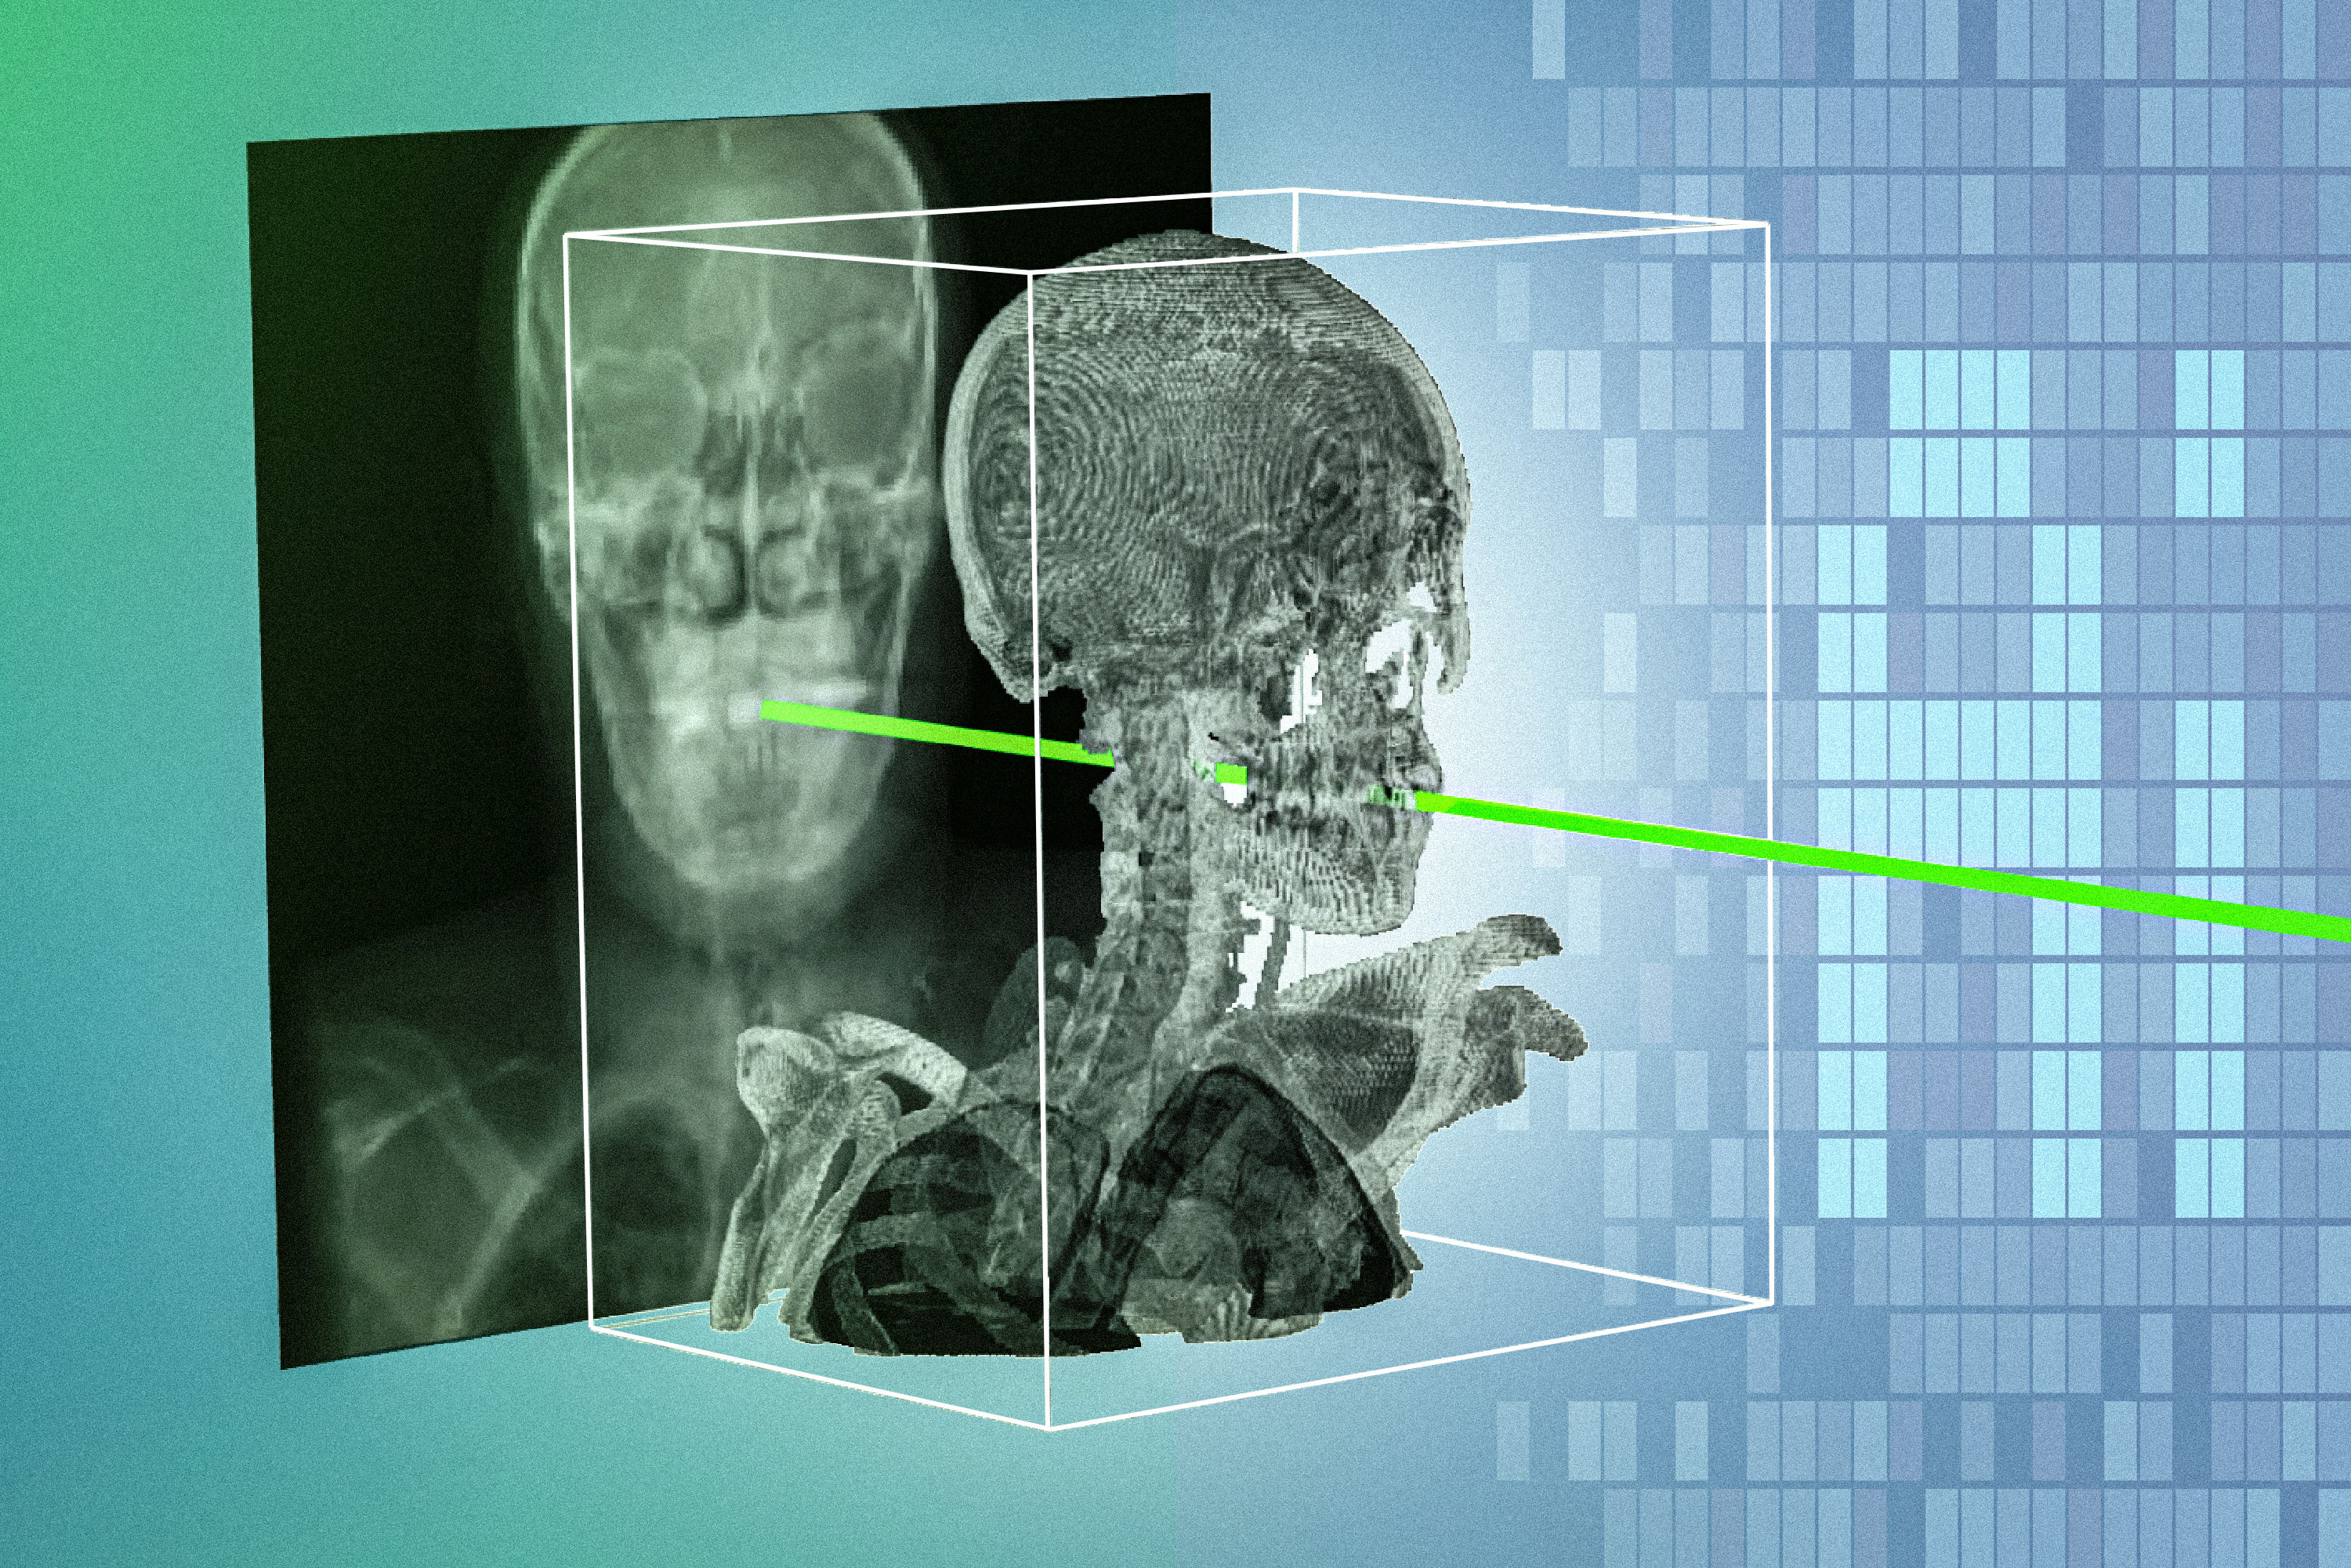
Trong nhiều thủ thuật xâm lấn tối thiểu, bác sĩ đưa catheter, endoscope hoặc dụng cụ khác qua một đường rạch rất nhỏ rồi theo dõi chúng bằng fluoroscopy — X-ray tốc độ cao hiển thị gần như theo thời gian thực. Vấn đề là màn hình vẫn chỉ cho một hình chiếu 2D của một cơ thể 3D. Kinh nghiệm của bác sĩ phải bù vào phần chiều sâu bị mất đó.
Một nhóm tại MIT cùng các bác sĩ từ nhiều bệnh viện vừa công bố một cách tự động hóa phần việc khó này. Hệ thống mang tên xvr, viết tắt của X-ray volume registration, có thể căn ảnh X-ray chụp trong lúc làm thủ thuật với CT hoặc MRI 3D đã chụp trước đó của chính bệnh nhân. Sau bước chuẩn bị mô hình khoảng năm phút, việc registration cho một ảnh có thể hoàn thành trong vài giây; MIT cho biết hệ thống đạt độ chính xác dưới milimet trong các bài đánh giá.
Nghiên cứu được công bố trên Nature ngày 16/9/2026. Điểm cần phân biệt ngay từ đầu là xvr không “biến một ảnh X-ray thành CT 3D”, cũng không tự tạo ra giải phẫu mà nó chưa từng nhìn thấy. Hệ thống cần một volume 3D có sẵn của bệnh nhân và giải bài toán ngược: xác định ảnh X-ray hiện tại tương ứng với góc nhìn, vị trí và hướng nào trong volume đó.
X-ray cho hình ảnh nhanh, nhưng làm mất chiều sâu
Fluoroscopy phù hợp với phòng can thiệp vì máy C-arm có thể chụp nhanh khi dụng cụ đang di chuyển. Bác sĩ có thể thấy guidewire hay catheter thay đổi vị trí gần như ngay lập tức mà không cần chụp lại một CT hoàn chỉnh.
Đổi lại, một ảnh X-ray là phép chiếu. Nhiều cấu trúc nằm ở các độ sâu khác nhau bị chồng lên cùng một mặt phẳng. Một đầu catheter nhìn như đang ở sát mạch máu hoặc đốt sống trên màn hình chưa chắc đã nằm đúng độ sâu trong không gian thực.
CT và MRI chụp trước thủ thuật lại chứa thông tin 3D chi tiết hơn. Nếu đặt được ảnh fluoroscopy mới vào đúng tọa độ của volume 3D này, hệ thống có thể cho bác sĩ biết dụng cụ đang nằm ở đâu so với xương, mạch máu hoặc các cấu trúc cần tránh. Đây là nguyên lý gần với một “GPS 3D”: không phải tạo bản đồ mới, mà xác định vị trí hiện tại trên một bản đồ đã có.
Công việc đó được gọi là 2D/3D registration. Nó đã tồn tại từ lâu, nhưng các phương pháp truyền thống thường cần bác sĩ hoặc kỹ thuật viên chọn landmark, thử tham số hoặc điều chỉnh thủ công. Những mô hình deep learning trước đây có thể tự động hơn, nhưng lại gặp một vấn đề khác: giải phẫu giữa bệnh nhân quá khác nhau, trong khi dữ liệu X-ray được gắn nhãn chính xác rất khó thu thập ở quy mô lớn.
xvr không cố học một mô hình duy nhất cho tất cả mọi người
Thay vì huấn luyện một mạng neural rồi buộc nó phải hoạt động tốt trên mọi cơ thể, nhóm MIT chọn cách cá nhân hóa mô hình cho từng bệnh nhân.
Đầu vào là CT hoặc MRI 3D đã có trước can thiệp. Từ volume này, xvr sử dụng mô phỏng vật lý của quá trình tạo ảnh X-ray để sinh hàng nghìn ảnh X-ray tổng hợp từ nhiều góc nhìn khác nhau. Theo MIT, hệ thống có thể tạo khoảng 1.000 ảnh tổng hợp mỗi giây.
Mỗi ảnh tổng hợp đi kèm một đáp án mà hệ thống biết chính xác: vị trí và hướng của “máy X-ray ảo” đã tạo ra nó. Nhờ vậy, xvr có thể tự tạo lượng lớn dữ liệu huấn luyện cho chính bệnh nhân mà không cần bác sĩ ngồi đánh dấu thủ công từng ảnh.
Về mặt kỹ thuật, đây là một quy trình self-supervised dựa trên mô phỏng vật lý. Mạng neural học cách dự đoán pose ban đầu của C-arm từ X-ray. Sau đó một bước tối ưu hóa dựa trên differentiable X-ray rendering tiếp tục tinh chỉnh pose bằng cách so sánh ảnh thật với những hình chiếu có thể tạo ra từ volume 3D.
Cách kết hợp này quan trọng vì mạng neural không phải tự giải quyết toàn bộ registration. Nó đưa hệ thống đến gần đáp án; trình tối ưu hóa sau đó làm phần căn chỉnh chính xác hơn.
Từ 12 giờ huấn luyện xuống khoảng năm phút
Một mô hình được huấn luyện từ đầu cho từng bệnh nhân có thể đạt độ chính xác tốt, nhưng nhóm nghiên cứu cho biết quá trình này mất khoảng 12 giờ. Con số đó khiến cách tiếp cận patient-specific gần như không dùng được cho các ca cấp cứu.
Để rút ngắn thời gian, nhóm xây dựng một foundation model từ các bộ dữ liệu whole-body 3D của hơn 2.000 bệnh nhân, trải rộng nhiều độ tuổi, vùng giải phẫu và loại hình ảnh. Foundation model không thay thế bước cá nhân hóa; nó cung cấp một điểm khởi đầu đủ tốt để fine-tune cho bệnh nhân mới nhanh hơn rất nhiều.
Theo MIT, bước thích nghi cho một bệnh nhân mới mất khoảng năm phút và đạt độ chính xác tương đương mô hình được huấn luyện từ đầu. Sau đó, quá trình căn một ảnh X-ray với volume 3D diễn ra trong vài giây.
Đây là hai khoảng thời gian khác nhau. Nói rằng “AI tạo GPS 3D trong vài giây” chỉ đúng với bước registration sau khi hệ thống đã có scan 3D và đã hoàn tất khoảng năm phút fine-tuning cho bệnh nhân đó.
Độ chính xác dưới milimet không đồng nghĩa đã thành hệ thống dẫn đường lâm sàng
Nhóm đánh giá xvr trên dữ liệu fluoroscopy thực từ năm bệnh viện, bao gồm nhiều cấu trúc xương và hệ cơ quan ở cả bệnh nhân người lớn lẫn trẻ em. Bài báo Nature mô tả đây là đánh giá lớn nhất của 2D/3D registration trên fluoroscopy thực mà các tác giả biết tới.
Trong các tác vụ được thử nghiệm, nhóm báo cáo độ chính xác registration dưới milimet và cho biết xvr cải thiện độ chính xác so với các phương pháp AI đối chứng khoảng một bậc độ lớn. Điểm mạnh khác là cùng một framework có thể thích nghi với nhiều vùng giải phẫu thay vì phải xây riêng một model cho từng bộ phận cơ thể.
Tuy nhiên, đây vẫn chủ yếu là kết quả về registration, không phải một thử nghiệm lâm sàng chứng minh bệnh nhân được phẫu thuật nhanh hơn, ít biến chứng hơn hoặc nhận ít bức xạ hơn khi dùng xvr. Hệ thống cho biết hai bộ ảnh đã được căn chính xác đến mức nào; từ đó tới một sản phẩm navigation được bác sĩ sử dụng thường quy còn cần tích hợp workflow, đánh giá độ tin cậy trong phòng mổ và kiểm chứng tác động lên kết quả điều trị.
Ngay chính nhóm nghiên cứu cũng chưa gọi xvr là hệ thống thời gian thực hoàn chỉnh. MIT cho biết một mục tiêu tiếp theo là làm nó nhanh hơn cho real-time deployment và mở rộng sang các tình huống khó hơn, đặc biệt là những bộ phận cơ thể đang chuyển động.
Vấn đề khó tiếp theo là khi “bản đồ” cũng chuyển động
Phương pháp hiện tại tập trung vào rigid registration: về cơ bản, hệ thống tìm phép xoay và tịnh tiến để khớp X-ray với volume 3D. Cách này rất phù hợp với nhiều cấu trúc cứng như xương, nơi hình dạng không thay đổi đáng kể trong thủ thuật.
Nhưng cơ thể không phải vật thể cứng. Tim đập, phổi nở và xẹp, mạch máu có thể biến dạng khi catheter đi qua, còn mô mềm thay đổi vị trí khi bệnh nhân hít thở hoặc khi dụng cụ tác động lên nó. Khi đó, CT hoặc MRI chụp trước thủ thuật không còn là một bản đồ hoàn toàn tĩnh và chính xác.
Đó là lý do việc xử lý các cấu trúc chuyển động và biến dạng nằm trong kế hoạch tiếp theo của nhóm. Một “GPS 3D” thực sự hữu ích trong can thiệp phải không chỉ biết máy X-ray đang nhìn từ đâu, mà còn phải cập nhật khi chính giải phẫu đã thay đổi so với lúc chụp CT hoặc MRI.
Nhóm MIT cho biết hiện họ đang làm việc với các công ty surgical robotics và các nhóm lâm sàng để biến xvr thành công cụ navigation hoặc deployment thực tế. Mã nguồn của framework cũng đã được công bố mở, cho phép các nhóm khác thử nghiệm và tái lập kết quả.
Nếu hướng này đi được tới sản phẩm lâm sàng, lợi ích không nằm ở việc loại bỏ X-ray hay thay CT/MRI. Nó nằm ở việc nối hai loại hình ảnh vốn mạnh ở hai thời điểm khác nhau: volume 3D giàu thông tin trước ca can thiệp và fluoroscopy 2D nhanh trong lúc bác sĩ đang thao tác. Phần AI đứng giữa, cố trả lời câu hỏi mà bác sĩ hiện vẫn phải giải bằng kinh nghiệm không gian: hình ảnh phẳng này đang nằm chính xác ở đâu trong cơ thể 3D của bệnh nhân?
Nguồn
- Nature: Rapid patient-specific neural networks for X-ray to volume registration
- MIT News: New AI technique could make minimally invasive surgeries safer and more precise
- MIT CSAIL: X-ray to Volume Registration (xvr)
- GitHub: xvr open-source implementation
Ảnh: Courtesy of the researchers; MIT News.