DeepSeek mở mã DeepInfer, nhưng chưa cung cấp trọn bộ dịch vụ suy luận
Framework hỗ trợ V4.1-Flash trên NVIDIA SM100 và Huawei Ascend 950. Thành phần quản lý KV cache và cân bằng tải vẫn là phần đội triển khai phải bổ sung.

DeepSeek ngày 20/10/2026 mở mã DeepInfer, framework suy luận mà hãng dùng cho dịch vụ mô hình quy mô lớn. Bản phát hành hỗ trợ DeepSeek-V4.1-Flash trên GPU NVIDIA SM100 và NPU Huawei Ascend 950, với giấy phép Apache 2.0.
Thông tin thực dụng nhất nằm ngay trong README chính thức: mã công bố hiện cung cấp suy luận ngoại tuyến. Một dịch vụ hoàn chỉnh còn cần hệ thống KV cache, phân tách các giai đoạn xử lý và cân bằng tải. Vì vậy, tải kho mã về chưa tương đương dựng được một bản sao dịch vụ API của DeepSeek.
Động cơ suy luận và dịch vụ phục vụ người dùng là hai lớp khác nhau
Framework suy luận tổ chức việc chạy mô hình trên phần cứng: gom yêu cầu, thực thi phép tính và lấy token đầu ra. Dịch vụ trực tuyến còn phải nhận yêu cầu, quản lý tài nguyên và duy trì hoạt động khi tải thay đổi hoặc máy gặp sự cố.
DeepInfer công bố các khả năng như suy luận phân tán, speculative decoding, điều phối bất đồng bộ và đầu ra có cấu trúc. Trong khi đó, phần quản lý cache và điều phối giữa các bản sao xử lý chưa được phát hành đầy đủ cùng mã nguồn.
Giới hạn này quan trọng với doanh nghiệp muốn tự vận hành. Lựa chọn framework chỉ là một phần của quyết định; đội hạ tầng còn phải đánh giá phần tích hợp, công cụ quan sát và năng lực xử lý sự cố mà mình cần tự xây dựng.
Vì sao hệ thống tách prefill khỏi decode?
Tài liệu triển khai của DeepSeek mô tả kiến trúc tách bộ mã hóa thị giác, prefill và decode, kèm các nút lưu trữ riêng. Prefill xử lý đầu vào để chuẩn bị trạng thái; decode tiếp tục sinh đầu ra. Tách hai phần cho phép bố trí tài nguyên theo đặc tính công việc khác nhau.
DeepSeek cũng giải thích việc giữ KV cache để tái sử dụng phần ngữ cảnh đã tính. Cache giúp giảm việc lặp lại, nhưng đổi lại cần dung lượng, chính sách quản lý và đường truyền đủ phù hợp.
Ở đây, tối ưu không chỉ nằm trong một kernel GPU. Suy luận biên tập: nếu cache không đến kịp hoặc một nhóm máy quá tải, cải tiến phép tính có thể không chuyển thành trải nghiệm tốt hơn. Cần đo cả hành trình yêu cầu để tìm nút thắt, thay vì chỉ nhìn thời gian chạy một toán tử.
Hỗ trợ hai nền tảng không bảo đảm mọi chế độ giống nhau
README nêu rõ một số khả năng, như batch-invariant inference và cấu hình lấy mẫu xác định, hiện có ghi chú riêng cho NVIDIA. Khi lập kế hoạch chuyển phần cứng, nhà phát triển cần đọc phạm vi từng tính năng thay vì hiểu “hỗ trợ NVIDIA và Huawei” là tương đương tuyệt đối.
Batch-invariant hướng tới giữ kết quả ổn định khi thành phần batch thay đổi. Điều đó có giá trị khi điều tra sai khác giữa hai lần chạy, nhưng vẫn phải đi cùng điều kiện cấu hình và lấy mẫu cụ thể.
phu.lt chưa triển khai DeepInfer trên hai nền tảng để kiểm tra mức tương đương. Bài viết cũng không suy ra mức giảm chi phí điện toán của một doanh nghiệp từ cấu hình vận hành nội bộ mà DeepSeek mô tả.
Benchmark cần đọc cùng phần cứng và dữ liệu
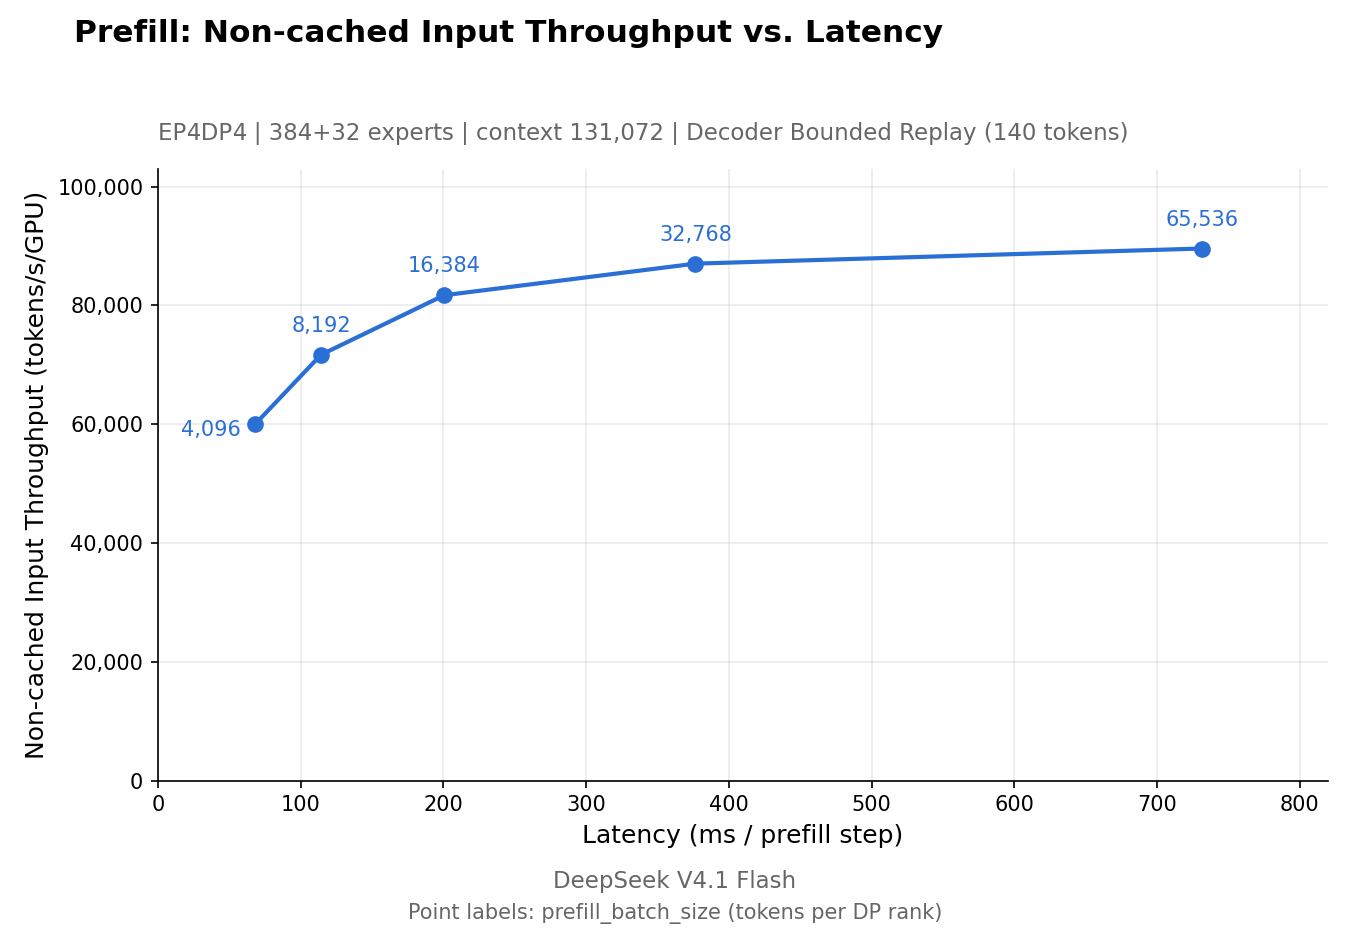
Biểu đồ prefill trong kho mã thể hiện quan hệ giữa thông lượng đầu vào chưa có cache và độ trễ. README cho biết benchmark prefill dùng 4 GPU SM100, còn decode dùng 64 GPU trong miền scale-up tương ứng. Hai cấu hình đó không nên bị gộp thành một con số tốc độ chung.
Tài liệu đánh giá có các luồng cho AIME, HLE và GPQA. Người chạy phải tự lấy dữ liệu từ nguồn phù hợp, chuẩn bị định dạng và đáp ứng điều kiện truy cập của bộ dữ liệu. Công cụ không tự tải mọi dữ liệu để biến một lệnh chạy thành kết quả có thể so sánh ngay.
Về phương pháp, thử nghiệm phục vụ sản xuất nên phân biệt độ trễ đến token đầu, tốc độ sinh tiếp và thông lượng tổng. Cùng một mô hình có thể đáp ứng tốt một yêu cầu đơn lẻ nhưng xếp hàng lâu khi nhiều người dùng cùng truy cập.
Mốc mới của DeepInfer là mở thêm phần động cơ và tài liệu hệ thống cho cộng đồng kiểm tra. Bước tiếp theo cần theo dõi là mức hoàn thiện của thành phần còn thiếu, khả năng tái lập phép đo và công sức tích hợp thực tế trên hạ tầng của bên thứ ba.
Ảnh: DeepSeek-AI, biểu đồ prefill do dự án công bố trong kho DeepInfer, giấy phép Apache 2.0 của kho mã. Đây là số đo của tác giả, không phải benchmark do phu.lt thực hiện.