SEO, AIO và GEO từ Beginner đến Senior: thuật toán tìm kiếm, AI Search và chiến lược tăng trưởng website quy mô lớn
Phân tích toàn diện SEO, AIO và GEO từ cơ chế crawl, indexing, thuật toán xếp hạng, E-E-A-T, Core Web Vitals đến AI Overviews, RAG, đo lường và vận hành website hàng triệu URL.

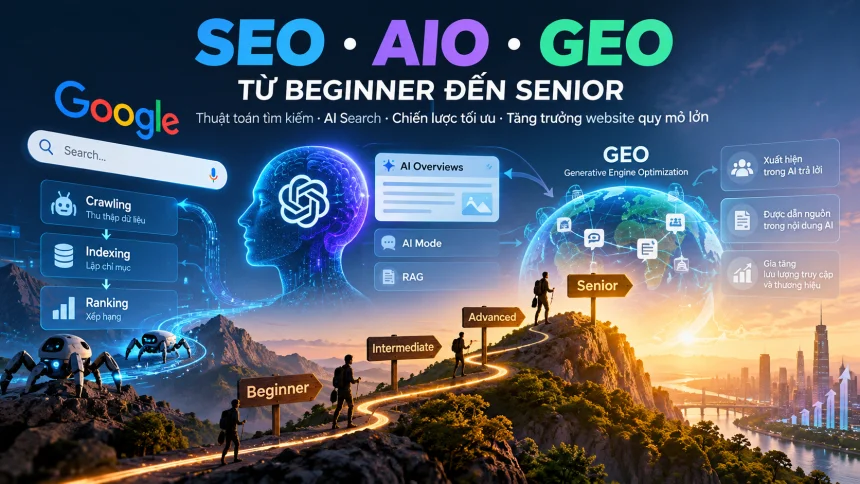
Cẩm nang thực hành dành cho SEO Specialist, biên tập viên, lập trình viên và người quản lý website quy mô lớn. Cập nhật 20/10/2026. Bài viết đi từ kiến thức nền tảng tới phân tích thuật toán, kiểm toán kỹ thuật, tối ưu trải nghiệm AI Search và tổ chức vận hành theo mức độ trưởng thành của đội ngũ.
1. SEO, AIO và GEO: ba lớp của một chiến lược tìm kiếm
SEO (Search Engine Optimization) giúp nội dung được phát hiện, thu thập, lập chỉ mục và hiển thị với truy vấn phù hợp. AIO (AI Optimization), theo nghĩa rộng được sử dụng trong bài này, là tối ưu thông tin để các hệ thống ứng dụng AI có thể đọc và diễn giải chính xác. AIO cũng có thể là cách viết tắt của AI Overviews, nên cần nêu rõ ngữ cảnh để tránh nhầm lẫn. GEO (Generative Engine Optimization) tập trung vào khả năng nội dung được lựa chọn, trích dẫn và diễn giải chính xác trong câu trả lời sinh tạo.
Ba hướng tiếp cận giao nhau chứ không phải ba cuộc chơi độc lập. Một website chặn bot, trả HTML rỗng hoặc không có dữ liệu đáng tin sẽ khó đạt kết quả ổn định ở cả tìm kiếm truyền thống lẫn AI Search. SEO tạo nền tảng tìm thấy, AIO nâng tính dễ hiểu và GEO thử nghiệm khả năng xuất hiện trong câu trả lời. Mục tiêu cuối cùng không phải chỉ là lượt hiển thị: doanh nghiệp cần lượng truy cập phù hợp, nhận diện đáng tin và chuyển đổi có giá trị.
Người mới nên hiểu rõ các thuật ngữ trước khi mua công cụ. Người có kinh nghiệm cần phân tách sự thật đã được nhà cung cấp xác nhận, diễn giải kỹ thuật có căn cứ và các giả thuyết chưa kiểm định. Đặc biệt không có công thức chung bảo đảm website được ChatGPT, Google AI Overviews hay công cụ AI khác trích dẫn.
2. Chuỗi giá trị từ URL đến người dùng
Một nội dung phải đi qua nhiều bước: được phát hiện qua liên kết hoặc sitemap; được crawler truy cập; máy chủ phản hồi đúng; trang được xử lý; hệ thống quyết định có lập chỉ mục; truy vấn được phân tích; tài liệu được truy xuất và xếp hạng; người dùng thấy kết quả; cuối cùng diễn ra lượt truy cập hoặc hành động kinh doanh. Đây là mô hình tư duy hữu ích, không phải sơ đồ bí mật của Google.
Mỗi bước đều có thể thất thoát. URL mới không có liên kết nội bộ sẽ khó được tìm thấy. Trang trả 200 nhưng nội dung chính cần JavaScript lỗi có thể bị hiểu thiếu. Mười URL gần trùng nhau có thể khiến công cụ tìm kiếm chọn một canonical không mong muốn. Trang được index vẫn có thể không xếp hạng vì không phục vụ ý định tìm kiếm. Trang đứng cao vẫn có thể ít click khi câu trả lời đã hiện ngay trên trang kết quả.
Cần tách khả năng đủ điều kiện và hiệu quả thực tế. Sitemap không bảo đảm index. Structured data hợp lệ không bảo đảm rich result. Xuất hiện trong một phiên thử AI không bảo đảm mọi người dùng đều nhìn thấy. Với website lớn, đo từng chặng bằng log, Search Console, analytics và dữ liệu chuyển đổi.
3. Thuật toán tìm kiếm: hiểu mô hình, tránh thần thoại
Công cụ tìm kiếm hiện đại không sử dụng công thức công khai kiểu H1 cộng hai điểm, backlink cộng năm điểm. Có thể mô tả về mặt khái niệm các lớp truy xuất ứng viên, hiểu truy vấn, đánh giá ngữ nghĩa, xếp hạng lại và trình bày kết quả. Các bước trên giúp phân tích kỹ thuật, nhưng không được khẳng định là chính xác cấu trúc thuật toán nội bộ Google.
Truy xuất từ vựng như BM25 và truy xuất vector đều là kỹ thuật nền tảng của ngành information retrieval. Dense retrieval giúp phát hiện nội dung gần nghĩa dù không khớp từng từ. Reranking cân nhắc sự phù hợp trên tập kết quả ứng viên. Hệ thống thương mại có thể kết hợp nhiều cơ chế, tín hiệu và cách đánh giá khác nhau. Không có cơ sở cho lời hứa rằng tạo embedding hoặc lặp từ đồng nghĩa sẽ tự động đẩy hạng.
Intent matching xác định người dùng tìm định nghĩa, hướng dẫn, so sánh hay mua hàng. Freshness quan trọng với tin tức, giá cả và phiên bản phần mềm; độ chính xác ổn định quan trọng với nhiều chủ đề kiến thức nền. Link analysis giúp đánh giá mối liên hệ, nhưng không thay thế nội dung. Độ dài cố định, keyword density và điểm Lighthouse 100 đều không phải công thức bảo đảm đứng đầu.
4. E-E-A-T, sự tin cậy và nội dung có bằng chứng
E-E-A-T bao gồm Experience, Expertise, Authoritativeness và Trustworthiness: trải nghiệm, chuyên môn, thẩm quyền và độ tin cậy. Google giải thích đây là cách suy nghĩ về nội dung hữu ích, không phải một con số xếp hạng đơn lẻ mà chủ website có thể đo trực tiếp. Yếu tố tin cậy giữ vị trí đặc biệt quan trọng, nhất là với thông tin liên quan đến sức khỏe, tài chính và an toàn.
Một bài kỹ thuật thể hiện kinh nghiệm khi cung cấp phiên bản, môi trường chạy, lỗi từng gặp, log trước và sau và phương án rollback. Một bài đánh giá phần mềm nên mô tả đã thử sản phẩm thật hay chỉ tổng hợp tài liệu. Một hướng dẫn kinh doanh cần nêu giả định và nguồn số liệu. Tạo hồ sơ tác giả chuyên gia hư cấu hoặc tự nhận đã thử nghiệm khi chưa thử là hành vi làm giảm độ tin cậy.
Hãy chia chứng cứ thành dữ liệu trực tiếp, tài liệu gốc, phân tích độc lập và quan điểm cá nhân. Với mỗi khẳng định quan trọng, đánh dấu lớp nguồn và thời điểm đối chiếu. Biên tập viên cần nhận diện câu nào đang vượt quá bằng chứng. Khi dùng nội dung AI, luôn kiểm tra URL, con số, tên nghiên cứu và kết luận trước khi đăng.
5. Search intent và kiến trúc chủ đề
Truy vấn 'Redis là gì' cần phần giải thích nền tảng, còn 'Redis cluster Kubernetes failover' cần manifest, sơ đồ topology và kịch bản kiểm thử. 'Redis managed pricing' lại hướng tới lựa chọn dịch vụ. Nếu tạo một bài cho mọi biến thể từ khóa, website có nguy cơ trùng lặp, cannibalization và khiến người đọc khó chọn đúng trang.
Các nhóm intent phổ biến gồm informational, navigational, commercial investigation và transactional. Đây là khung phân loại, không phải các ô tuyệt đối. Người tìm 'VPS Laravel tốt nhất' có thể vừa học tiêu chí kỹ thuật vừa muốn mua. Hãy đọc kết quả tìm kiếm, quan sát người dùng và xác định nhiệm vụ mà mỗi URL phải hoàn thành.
Topic cluster tốt thường có trang tổng quan và các trang chuyên sâu liên kết tự nhiên với nhau. Một bài giải thích căn bản dẫn tới bài triển khai; bài triển khai dẫn tới tài liệu vận hành, troubleshooting và benchmark. Anchor text cần mô tả đích đến. Breadcrumb và menu phải tạo đường đi rõ. Đừng xây hàng trăm tag rỗng chỉ để tăng số URL.
6. Technical SEO: HTTP, robots, sitemap và canonical
Technical SEO bắt đầu từ mạng và hệ thống phân phối: DNS, TLS, reverse proxy, CDN, WAF, origin, cache và phản hồi HTTP. Nếu Googlebot bị Cloudflare challenge, redirect vòng lặp hay nhận 5xx, tối ưu nội dung không giải quyết được vấn đề. Trước khi sửa metadata hãy xác nhận trang thực sự truy cập được, trả trạng thái chính xác và hiển thị nội dung.
Mã 200 nghĩa thành công; 301 và 308 dùng chuyển hướng vĩnh viễn trong những trường hợp phù hợp; 302 và 307 là tạm thời; 404 báo không tìm thấy; 410 báo tài nguyên không còn; 429 cho biết giới hạn truy cập; nhóm 5xx phản ánh lỗi phía máy chủ. Trang hiển thị 'không tìm thấy' nhưng trả 200 có thể thành soft 404.
Robots.txt là chỉ dẫn crawl, không phải cơ chế bảo mật và không đồng nghĩa xóa khỏi index. Noindex phải được crawler nhìn thấy để xử lý. Không nên đồng thời Disallow một URL và kỳ vọng Google đọc meta noindex trong URL đó. XML sitemap chỉ nên liệt kê URL canonical, có thể index và có giá trị. lastmod phản ánh cập nhật thực chất, không nên thay đổi hàng đêm một cách giả tạo.
Canonical là tín hiệu đề xuất URL đại diện cho nội dung trùng hoặc gần trùng; Google có thể chọn khác. Sitemap, internal links và canonical nên nhất quán. Khi URL đã chuyển vĩnh viễn sang trang tương đương, redirect thường phù hợp hơn giữ nhiều bản giống nhau.
7. JavaScript SEO và lựa chọn SSR, SSG, CSR
React, Vue hay ứng dụng SPA không mặc nhiên kém SEO. Rủi ro phát sinh khi bot cần thực thi JavaScript nặng mới nhìn thấy phần nội dung cốt lõi, liên kết và metadata. Google hỗ trợ xử lý JavaScript nhưng quá trình rendering có thể gặp độ trễ, giới hạn hoặc lỗi. Đánh giá bằng HTML trả từ server, kết quả DOM sau render và công cụ URL Inspection.
SSR trả HTML nội dung từ server, SSG tạo sẵn HTML, còn CSR chủ yếu dựng giao diện ở phía trình duyệt. Trang báo, sản phẩm, danh mục và landing page thường dễ kiểm soát hơn khi trả văn bản chính ngay ở phản hồi HTML. Dashboard sau đăng nhập có thể ưu tiên tương tác client-side. Chọn kiến trúc theo loại trang thay vì ép toàn bộ ứng dụng về một mô hình.
Kiểm tra title và canonical không bị hydration ghi đè hoặc sinh trùng. Liên kết điều hướng nên có href thật. Nếu nội dung quan trọng chỉ xuất hiện sau cú click hay API bị chặn, bot có thể không khám phá được. Senior cần cân nhắc hiệu năng SSR, cache invalidation, tải máy chủ và tính nhất quán dữ liệu trước khi thay đổi kiến trúc.
8. Core Web Vitals và hiệu năng người dùng thật
Core Web Vitals hiện tập trung vào Largest Contentful Paint (LCP), Interaction to Next Paint (INP) và Cumulative Layout Shift (CLS). web.dev đưa ra ngưỡng trải nghiệm tốt là LCP không quá 2,5 giây, INP không quá 200 ms và CLS không quá 0,1 ở phân vị 75 của dữ liệu thực. Chỉ số phòng thí nghiệm giúp tìm nguyên nhân nhưng không thể thay thế số liệu người dùng.
LCP có thể bị ảnh hưởng bởi TTFB, CSS chặn render, ảnh hero chưa được ưu tiên hoặc cache origin yếu. Tránh lazy-load hình lớn nhất ở khu vực nhìn thấy đầu tiên. Dùng ảnh đúng kích thước, định dạng phù hợp và CDN hợp lý. INP xấu thường liên quan JavaScript chiếm main thread, callback dài, DOM nặng và quá trình render lại quá nhiều. CLS liên quan ảnh không đặt kích thước, quảng cáo chèn muộn và font làm thay đổi bố cục.
Phải chia dữ liệu theo mobile/desktop, địa lý, loại template và nhóm mạng. Lighthouse 100 không bảo đảm thứ hạng. Mục tiêu của cải thiện hiệu năng là trải nghiệm và kết quả kinh doanh, không phải chạy theo điểm số công cụ.
9. Nội dung SEO: chiều sâu thay vì số chữ
Một bài hữu ích phải xác định rõ đối tượng, câu hỏi cần trả lời, điều kiện áp dụng và cách đọc tiếp. Tiêu đề nên phản ánh đúng lời hứa; sapo nêu vấn đề và giá trị; các tiểu mục tạo trình tự lập luận; kết luận cho thấy người đọc nên làm gì. Keyword giúp định vị chủ đề chứ không phải yêu cầu lặp trong từng đoạn.
Meta title cần phân biệt bài với nội dung gần giống. Meta description là đoạn tóm tắt có tính thuyết phục, nhưng công cụ tìm kiếm có thể tạo snippet khác. H1 mô tả nội dung chính; H2/H3 phục vụ người đọc và cấu trúc văn bản. Không có độ dài từ hay keyword density được Google công bố là ngưỡng tối ưu chung.
Information gain trong thực hành nghĩa là bổ sung giá trị thật: phép đo độc lập, sơ đồ tự xây, bộ dữ liệu minh bạch, ví dụ có điều kiện, phản ví dụ, hướng dẫn xử lý lỗi hoặc trải nghiệm triển khai. Một bài 1.500 từ có kiểm chứng thực tế có thể hữu ích hơn bài 8.000 từ lặp ý. Khi cập nhật bài cũ, phải chỉnh sửa thông tin thực chất, không chỉ thay năm trong tiêu đề.
10. Liên kết nội bộ, backlink và digital PR
Internal linking giúp crawler phát hiện URL và giúp người đọc chuyển tới kiến thức liên quan. Các trang quan trọng cần được dẫn từ vị trí dễ tiếp cận, không chỉ nằm sâu trong phân trang hoặc hộp tìm kiếm. Anchor text rõ nghĩa tốt hơn cụm 'xem thêm' lặp hàng trăm lần nếu người đọc không biết đích đến.
Backlink có giá trị khi là sự công nhận tự nhiên từ nguồn độc lập: bài nghiên cứu, công cụ hữu ích, tài liệu gốc hoặc đánh giá có căn cứ. Mua liên kết hàng loạt, mạng PBN và trao đổi liên kết thao túng có thể vi phạm chính sách spam. Đừng đánh giá backlink chỉ theo một điểm số do bên thứ ba tự xây.
Digital PR nên gắn với tài sản thông tin khó sao chép: dữ liệu gốc, nghiên cứu có phương pháp, chuyên gia thật và báo cáo chuyên ngành. Những tín hiệu này có thể giúp thương hiệu được người khác nhắc đến, đồng thời tạo khả năng được các hệ thống tìm kiếm AI sử dụng như nguồn tham khảo. Tuy nhiên không có cơ sở bảo đảm mọi lượt nhắc tên đều tác động trực tiếp tới thứ hạng.
11. Structured data và JSON-LD đúng mục đích
Structured data mô tả thực thể và thuộc tính để máy dễ diễn giải. JSON-LD thường được dùng cho Article, NewsArticle, Product, Organization, BreadcrumbList và nhiều loại khác theo ngữ cảnh. Nội dung đánh dấu phải khớp với trang người dùng thấy. Không nên thêm giá, đánh giá sao hay tác giả giả để cố tạo rich result.
Schema.org là bộ từ vựng rộng; danh sách rich result mà Google hỗ trợ là tập con có hướng dẫn riêng. Schema hợp lệ không bảo đảm giao diện hiển thị đặc biệt. Ngày xuất bản, ngày sửa đổi, tác giả và tên tổ chức phải có dữ liệu thật. Rich Results Test giúp kiểm tra các loại kết quả được hỗ trợ; schema validator kiểm tra cấu trúc theo nghĩa rộng.
Google nói không cần schema dành riêng cho AI Overviews hoặc AI Mode để đủ điều kiện xuất hiện trong các trải nghiệm AI Search. Lợi ích thực hành của dữ liệu có cấu trúc là tính nhất quán và rõ nghĩa, không phải nút bật một thứ hạng. Kiểm tra schema ngay trong pipeline deploy và khi cập nhật bài viết.
12. AI Search, RAG và query fan-out
Một hệ thống Retrieval-Augmented Generation (RAG) có thể nhận câu hỏi, truy xuất tài liệu liên quan, chọn đoạn ngữ cảnh rồi sinh câu trả lời dựa trên những đoạn đó. Có sản phẩm tra cứu web trực tiếp, có hệ thống chỉ dùng dữ liệu nội bộ, có mô hình trả lời không truy xuất nguồn. Không thể giả định mọi chatbot có cùng pipeline.
Google đã mô tả cách AI Mode và AI Overviews có thể phát sinh nhiều truy vấn liên quan (query fan-out) nhằm thu thập góc nhìn rộng hơn. Vì vậy câu hỏi dài có thể khiến hệ thống truy xuất nhiều trang chuyên sâu hơn so với một truy vấn ngắn. Một trang trả lời đúng vấn đề nhỏ có thể được nhắc dù không đứng đầu từ khóa rộng.
Đừng suy diễn rằng chỉ cần đặt đoạn 'answer-first' là AI chắc chắn trích dẫn. Khả năng xuất hiện còn phụ thuộc hệ thống, thị trường, thời điểm, truy vấn, tài liệu nguồn và cách trình bày kết quả. Tối ưu cần hướng tới câu trả lời chính xác, có điều kiện và có nguồn, thay vì thao túng cách diễn đạt.
13. Nghiên cứu GEO và giới hạn của kết quả
Công trình 'GEO: Generative Engine Optimization' của Aggarwal và cộng sự đề xuất phương pháp cải thiện mức độ hiển thị nội dung trong câu trả lời của generative engine. Nghiên cứu báo cáo mức cải thiện lên tới 40% trong một số thiết lập thực nghiệm và thước đo được định nghĩa trong công trình. Không được chuyển con số này thành lời hứa tăng 40% traffic, doanh thu hoặc lượt dẫn nguồn cho mọi website.
Những hướng đáng thử bao gồm dẫn chứng rõ, số liệu xác minh, trích nguồn chính xác và viết nội dung dễ tổng hợp. Tuy nhiên trích dẫn vô nghĩa hay chèn thống kê bịa là phản tác dụng. Những thử nghiệm trên tài liệu đã được đưa vào ngữ cảnh không chứng minh website sẽ được crawl thường xuyên hơn hoặc luôn được chọn đưa vào prompt.
GEO hiện thiếu một chuẩn KPI thống nhất giữa mọi nền tảng. Khác biệt về câu hỏi, mô hình, ngôn ngữ và thời điểm khiến kết quả biến động. Hãy xây tập câu hỏi kiểm chứng, nhóm đối chứng và quy trình chấm độ chính xác thay vì mua 'gói citation' theo cam kết thiếu bằng chứng.
14. Viết để được hiểu và trích dẫn đúng
Mỗi phần quan trọng nên bắt đầu bằng kết luận hoặc định nghĩa rõ ràng, sau đó giải thích lý do, ngoại lệ và dữ liệu hỗ trợ. Câu 'SSR thường giúp bot nhận nội dung cốt lõi sớm hơn' chính xác hơn 'SSR luôn tăng thứ hạng'. Mô hình AI có thể tóm tắt bỏ mất ngữ cảnh, nên điều kiện quan trọng cần đặt gần khẳng định tương ứng.
Bài nghiên cứu cần giải thích số mẫu, nguồn dữ liệu, thời gian đo, tiêu chí so sánh, giới hạn và xung đột lợi ích. Bài kỹ thuật cần ghi phiên bản, cấu hình, lệnh, kết quả dự kiến và dấu hiệu thất bại. Một bảng so sánh nên nêu đơn vị đo và tình huống áp dụng. Các tài liệu gốc có cấu trúc dễ đọc thường có giá trị lâu dài hơn những trang quảng cáo nhiều khẩu hiệu.
Chất lượng GEO không chỉ là có tên xuất hiện. Một câu trả lời gắn nhầm giá, mô tả sai sản phẩm hoặc gán tuyên bố cho nguồn không phù hợp có thể gây hại. Hãy đánh giá answer fidelity, citation correctness và khả năng cập nhật thông tin sai trên các tài liệu gốc.
15. AI crawler, quyền truy cập và chính sách
Crawler phục vụ tìm kiếm, crawler phục vụ huấn luyện và tác nhân duyệt trang theo yêu cầu người dùng không nhất thiết có cùng mục đích. Chính sách của từng nhà cung cấp cần được xem trong tài liệu cập nhật. Trước khi cấu hình CDN hoặc WAF, hãy phân biệt bot thực sự với User-Agent tự khai, và hiểu bạn muốn mở quyền truy cập cho hoạt động nào.
Các điều khiển robots, noindex, nosnippet, max-snippet và data-nosnippet có ý nghĩa khác nhau. Google giải thích cách những điều khiển Search này ảnh hưởng tính đủ điều kiện và phần trích dẫn trong AI features. Google-Extended không phải một công tắc riêng để loại trừ nội dung khỏi AI Overviews. Đừng dùng robots như cơ chế bảo mật dữ liệu cá nhân hoặc nội dung trả phí.
Tệp llms.txt có thể hữu ích cho các thử nghiệm tác nhân riêng, nhưng Google không yêu cầu tệp đặc biệt này để xuất hiện trong AI Overviews. Hãy ưu tiên HTML dễ truy cập, canonical, internal linking và nội dung chính xác. Đồng thời giám sát rate limit, cache và tài nguyên để bot không làm giảm chất lượng phục vụ người dùng.
16. Crawl budget với website nhiều triệu URL
Website lớn thường phát sinh URL explosion từ sort, filter, search params, phân trang, session ID, lịch lưu trữ và các bản trùng lặp. Bot có thể tiêu tốn thời gian vào hàng nghìn địa chỉ ít giá trị thay vì phát hiện trang quan trọng. Google phân biệt crawl capacity limit và crawl demand: khả năng phục vụ của hệ thống và nhu cầu quay lại thu thập URL.
Hãy phân loại mẫu URL theo mục đích. Danh mục có nhu cầu tìm kiếm riêng và nội dung độc đáo có thể cần index; tổ hợp tham số tùy ý thường không. Đặt chính sách cho URL hợp lệ, canonical, noindex, robots và điều hướng theo đúng trường hợp, tránh áp dụng một quy tắc chung cho toàn bộ hệ thống.
Với sàn tuyển dụng, tin hết hạn phải được xử lý đúng vòng đời: cập nhật trạng thái, đề xuất công việc tương tự hoặc trả 404/410 nếu tài nguyên thực sự không còn. Không redirect mọi tin cũ về homepage. Với báo điện tử, ưu tiên phát hiện bài mới, lưu trữ ổn định, sitemap đúng và taxonomy không sinh vô hạn trang tag trống.
Crawl budget là vấn đề tài nguyên và chất lượng tập URL, không phải chỉ số do công cụ SEO tự gán. Việc loại URL rác nên được kiểm chứng bằng log, Search Console và số lượng trang quan trọng thực sự được crawl.
17. Phân tích Nginx và CDN logs để ra quyết định
Log trả lời các câu hỏi bot nào đã yêu cầu URL nào, vào lúc nào, nhận HTTP status nào và mất bao lâu. Nếu CDN trả dữ liệu từ edge, chỉ xem origin log sẽ thiếu yêu cầu không chạm origin. Hãy kết hợp edge log, reverse proxy, ingress và dữ liệu Search Console để nhìn đủ hành trình.
Các trường cần thiết gồm thời điểm, hostname, normalized path, method, status, cache status, response time, loại template và bot đã xác minh. User-Agent không đủ để kết luận Googlebot thật. Dùng phương pháp xác minh IP hoặc DNS theo hướng dẫn nhà cung cấp. Bảo vệ thông tin nhạy cảm trong log và đặt thời hạn lưu trữ phù hợp.
Metric có ích: khoảng thời gian publish đến lần crawl đầu tiên, tỷ lệ request vào canonical pages, crawl 4xx/5xx, tốc độ phản hồi theo template, tỷ lệ bot vào filter pages và nhóm URL ít được phát hiện. Một đợt tăng request chưa chắc tốt nếu phần lớn là vòng lặp redirect.
Khi traffic giảm, hãy đối chiếu mốc deploy, thay đổi WAF, robots, HTML template, CDN, internal linking và chất lượng nội dung trước khi quy kết cho 'Google update'. Đo lường tốt giúp loại bỏ phỏng đoán.
18. KPI cho SEO, AIO và GEO
SEO cần theo dõi impressions, clicks, CTR, vị trí theo nhóm truy vấn, landing pages tạo giá trị, conversions và doanh thu hoặc lead. Phân khúc branded và non-branded, mobile và desktop, quốc gia, chủ đề, template. Vị trí trung bình tổng thể có thể gây hiểu lầm khi cơ cấu truy vấn thay đổi.
Technical SEO cần các chỉ số riêng: nhóm URL đủ điều kiện index, canonical mismatch, HTTP errors, thời gian crawl bài mới, Core Web Vitals và chất lượng internal linking. Đừng tính tỷ lệ index bằng cách chia số trang index cho mọi URL hệ thống bao gồm cả URL cố ý noindex.
GEO có thể đo answer presence, citation presence, citation correctness, độ đúng thông tin sản phẩm, tần suất được đề cập theo nhóm câu hỏi, referral traffic quan sát được và hành động sau truy cập. Không phải công cụ AI nào cũng truyền referral rõ ràng. Đừng tự gán tăng trưởng direct traffic cho AI nếu không có bằng chứng.
Dùng bộ câu hỏi đại diện theo hành trình khách hàng, chạy lặp ở nhiều thời điểm, lưu câu trả lời và nguồn trích, chấm thủ công một mẫu và đánh dấu thay đổi mô hình. Khi báo cáo tác động, phân biệt tương quan và nguyên nhân, kết hợp nhóm đối chứng nếu khả thi.
19. SEO audit: ưu tiên theo ảnh hưởng thay vì số lỗi
Một audit hữu ích bắt đầu bằng mục tiêu kinh doanh và nhóm URL quan trọng, không phải việc in ra 500 cảnh báo từ crawler. Lớp hạ tầng xem DNS, HTTP, WAF, cache, tốc độ phản hồi. Lớp index xem robots, canonical, sitemap, rendering và liên kết nội bộ. Lớp nội dung xem intent, trùng lặp, nguồn, chuyên môn, thông tin cũ. Lớp AI xem câu trả lời và độ chính xác dẫn nguồn.
Phải ưu tiên các sự cố có tác động lớn: noindex hàng loạt, canonical sai diện rộng, lỗi 5xx kéo dài, HTML rỗng, trang mới không được liên kết. Vấn đề nhỏ như alt text icon trang trí có thể xử lý sau. Cân nhắc tác động, độ tin cậy của chẩn đoán, chi phí triển khai và rủi ro vận hành.
Mỗi ticket nên có giả thuyết, phạm vi URL, bước tái hiện, owner, chỉ số trước/sau, test nghiệm thu và điều kiện rollback. Đây là khác biệt giữa SEO dùng checklist và chương trình tối ưu có kỷ luật kỹ thuật.
20. Laravel và kiến trúc website dễ kiểm soát SEO
Với Laravel, Blade hoặc giải pháp SSR phù hợp có thể đảm bảo trang public trả tiêu đề, nội dung chính, canonical và internal links ngay trong HTML. Livewire hỗ trợ tương tác nhưng trang cần index không nên phụ thuộc vào việc client tải thành công mới hiện văn bản. Metadata nên được sinh qua một lớp dùng chung và có automated tests.
Canonical nên lấy từ route chuẩn thay vì ghép nguyên query string. Hãy xây whitelist cho nhóm filter URL thực sự được phép index. Không canonical mọi trang phân trang về trang đầu một cách máy móc khi các trang sau chứa tài nguyên khác có giá trị. Kiểm tra cache invalidation để HTML, Open Graph và schema không lệch phiên bản.
Sitemap có thể được tạo qua queue nhưng phải phản ánh nội dung đã publish. Khi bài đổi hoặc xóa, cập nhật sitemap, trạng thái HTTP và liên kết nội bộ. Dùng kiểm thử CI cho title, canonical duy nhất, status 200, robots và structured data. Nếu cập nhật hàng loạt, cần rollback plan và kiểm tra mẫu.
Hệ thống biên tập tự động cần idempotency key cho thao tác tạo bài, ngăn sinh trùng khi retry. Trạng thái nội dung, fact-check và xử lý hình ảnh phải độc lập để một lỗi tải ảnh không khiến bốn bài đã thành công bị tạo lại.
21. AI trong hệ thống biên tập: hiệu suất đi cùng trách nhiệm
AI có thể giúp nghiên cứu từ khóa, tóm tắt nguồn, gợi ý cấu trúc, kiểm tra thuật ngữ, phát hiện mâu thuẫn và tạo bản nháp. Nhưng nội dung sản xuất hàng loạt chủ yếu để thao túng ranking có nguy cơ vi phạm chính sách scaled content abuse, bất kể tạo bằng AI hay con người.
Một pipeline có thể gồm candidate, source verified, duplicate checked, outline approved, draft created, factual review, image verified, SEO review, published và monitored. Mỗi bước cần log lỗi và trạng thái riêng. Không nên tự lấy ảnh có bản quyền không rõ rồi gắn vào bài.
Với tin nóng, phân biệt ngày công bố nguồn, ngày diễn ra sự kiện và ngày cập nhật nội dung. Nếu một hãng tự công bố benchmark, nói rõ ai là bên đánh giá; không biến claim quảng cáo thành kết luận khoa học. Tránh tạo tên chuyên gia, trích dẫn, URL và số liệu không tồn tại.
Người duyệt cuối cần xác nhận bài cung cấp điều mới, làm đúng lời hứa, không đánh lừa người đọc và có thể truy nguyên nguồn. Sản xuất ít hơn nhưng có chất lượng và cập nhật tốt thường bền vững hơn kho nội dung khổng lồ trùng lặp.
22. Roadmap SEO và GEO trong 90 ngày
Ngày 1–15: lập baseline. Kiểm kê template, nhóm URL, Search Console, analytics, conversion, crawl data, HTTP errors và Core Web Vitals. Chọn mẫu trang đại diện; chụp lại trước khi thay đổi. Phân tách phần đã xác minh và phần nghi ngờ.
Ngày 16–30: xử lý lỗi nền tảng. Ưu tiên noindex nhầm, canonical sai, redirect hỏng, 5xx, WAF chặn bot, nội dung HTML rỗng và sitemap không khớp URL published. Test từng thay đổi trên staging và theo dõi production.
Ngày 31–45: tăng chất lượng nội dung. Hợp nhất bài trùng, sửa bài cũ lỗi thời, bổ sung nguồn chính thức, dữ liệu thực nghiệm, trải nghiệm người viết và chuỗi liên kết chủ đề. Đừng thay toàn bộ tiêu đề chỉ vì một báo cáo gợi ý công thức chung.
Ngày 46–60: tối ưu kiến trúc và hiệu năng. Chuẩn hóa internal linking, URL parameters, xử lý crawl budget, ảnh LCP, JavaScript tải thừa và schema chính xác. Tạo regression tests cho mỗi template quan trọng.
Ngày 61–75: xây benchmark AI Search. Chọn 30–100 câu hỏi đại diện theo ngôn ngữ và mục tiêu khách hàng, đo presence, citation và thông tin sai. Cải thiện tài liệu nguồn, trang thực thể, dữ liệu bảng và mô tả sản phẩm với nhóm đối chứng khi có thể.
Ngày 76–90: tổng kết tác động. So sánh với baseline, chu kỳ mùa vụ, nhóm truy vấn và mốc thay đổi sản phẩm. Giữ biện pháp hiệu quả, rollback biện pháp gây lỗi và ưu tiên backlog quý sau theo kết quả thực đo.
23. Lộ trình năng lực Beginner, Middle và Senior
Beginner cần thành thạo HTTP status, HTML cơ bản, title, meta description, H1, internal linking, robots, noindex, canonical, sitemap và cách đọc Search Console. Mục tiêu đầu tiên là hiểu đường đi của một URL, phân biệt trang không crawl được với trang không có thứ hạng. Kiểm tra 20 URL quan trọng đúng cách hữu ích hơn học thuộc '200 yếu tố xếp hạng' vô căn cứ.
Middle phải biết phân nhóm intent, xây topic map, dùng crawler và log, đọc dữ liệu Core Web Vitals, xử lý trùng lặp, kiểm chứng lỗi rendering và làm việc với developer. Khả năng viết ticket rõ ràng, triển khai thử nghiệm và báo cáo giới hạn kết quả rất quan trọng.
Senior cần quản trị hệ thống website quy mô lớn: chiến lược URL, migrations, international SEO, bot management, CDN, structured data, automation, chất lượng nội dung và AI Search. Senior biết cách đánh đổi tác động với rủi ro, sử dụng số liệu để chọn dự án và phản biện đề xuất nghe hấp dẫn nhưng thiếu bằng chứng.
Tiến bộ nghề nghiệp không đo bằng số lượng công cụ có thể sử dụng mà bằng chất lượng quyết định, khả năng giải thích nguyên nhân và trách nhiệm với kết quả kinh doanh. Khả năng nói 'chưa đủ dữ liệu' là một kỹ năng chuyên nghiệp.
24. Những ngộ nhận phổ biến cần loại bỏ
'Có sitemap là Google index hết' là sai; sitemap hỗ trợ khám phá. 'Disallow tức là xóa khỏi Google' là sai; crawl và index khác nhau. 'Canonical là mệnh lệnh tuyệt đối' là sai; đó là tín hiệu. 'E-E-A-T là một điểm số Google hiển thị' cũng sai. Đừng điều hành SEO bằng những giả định tiện lợi.
'Bài càng dài càng đứng cao' không đúng nếu phần lớn độ dài là lặp. 'Nội dung AI luôn bị phạt' là diễn giải sai: điều cần kiểm tra là giá trị, độ tin cậy và mục đích thao túng. 'Core Web Vitals tốt chắc chắn lên top' bỏ qua mức liên quan và nhu cầu tìm kiếm.
'Chèn llms.txt hoặc AI schema sẽ được AI Overviews ưu tiên' hiện không được Google xác nhận. 'GEO tăng 40% traffic' là diễn dịch sai một kết quả nghiên cứu visibility trong điều kiện riêng. 'Mua 100 citation' không bảo đảm AI sẽ dẫn đúng nguồn hoặc người dùng sẽ click.
Câu hỏi quan trọng hơn mọi thủ thuật là: liệu trang có cung cấp dữ liệu đúng, đủ sâu, dễ truy cập và khó thay thế hay không? Nếu câu trả lời là không, tối ưu kỹ thuật chỉ giúp bot tìm một nội dung chưa đủ tốt.
25. Kết luận: tăng trưởng tìm kiếm bền vững trong kỷ nguyên AI
SEO, AIO và GEO nên được quản trị như một chiến lược thông tin thống nhất. Technical SEO đảm bảo nội dung có thể được truy cập và xử lý; biên tập có trách nhiệm tạo thông tin gốc, chính xác và hữu ích; AI Search mở ra cách phân phối nơi thương hiệu có thể được nhắc trước cả khi người dùng ghé website.
Ở quy mô nhiều triệu URL, ưu thế cạnh tranh nằm ở hạ tầng ổn định, taxonomy có chủ đích, dữ liệu gốc, trải nghiệm đáng tin và khả năng thực nghiệm theo thời gian. Một dashboard đẹp không thay thế conversion; một lần chatbot nhắc thương hiệu không thay thế sự đo lường có đối chứng.
Người làm SEO thế hệ mới cần kết hợp kỹ năng nội dung, engineering, phân tích dữ liệu và tư duy sản phẩm. Đừng theo đuổi các 'bí mật thuật toán' thiếu nguồn. Hãy xây một hệ thống biết phát hiện lỗi, kiểm chứng thay đổi và làm cho thông tin đáng đọc, đáng trích dẫn và đáng sử dụng.
Tài liệu tham khảo
- Google Search Central — Creating helpful, reliable, people-first content
- Google Search Central — AI features and your website
- Google Search Central — Succeeding in AI Search
- Google Search Central — Managing crawl budget
- Google Search Central — JavaScript SEO
- Google Search Central — Canonicalization
- Google Search Central — Structured data
- Google Search Central — Spam policies
- web.dev — Web Vitals
- Aggarwal et al. — GEO: Generative Engine Optimization
Ghi chú: các giải pháp triển khai và roadmap là khuyến nghị thực hành, không phải tuyên bố về công thức xếp hạng bí mật của các nền tảng tìm kiếm.