SGLang thử tách tạo rollout trên Trainium khỏi huấn luyện GPU
Plugin beta công bố ngày 22/10 đưa ra một cách tổ chức hạ tầng RL khác: phần sinh dữ liệu và phần cập nhật chính sách không nhất thiết dùng cùng cụm máy.

SGLang đang thử một cách phân bổ hạ tầng hậu huấn luyện: dùng AWS Trainium để sinh rollout, còn GPU thực hiện bước cập nhật chính sách. Plugin beta được nhóm công bố ngày 22/10/2026 cho phép hai phần công việc chạy trên phần cứng khác nhau, thay vì mặc nhiên đặt toàn bộ vòng lặp trên một cụm GPU.
Đây là bài phân tích công bố trong tuần, không phải tin phát hành mới ngày 25/10. Nhóm SGLang cho biết beta ban đầu dành cho một nhóm nhỏ tham gia; khả năng truy cập plugin này cần được phân biệt với beta công khai của nền tảng TorchNeuron.
Hai giai đoạn RL đặt ra hai loại tải
Trong mô tả của SGLang, rollout generation là phần chạy suy luận để tạo đầu ra phục vụ quá trình học tăng cường. Sau đó, bước cập nhật chính sách điều chỉnh mô hình từ dữ liệu và mục tiêu huấn luyện. Cả hai cùng nằm trong một quy trình nhưng không làm cùng loại phép tính ở cùng nhịp độ.
Từ góc độ tổ chức hệ thống, chia hai giai đoạn cho phép đánh giá riêng nhu cầu tài nguyên. Một đội có thể cần tăng khả năng sinh đầu ra mà chưa cần tăng tương ứng cụm cập nhật mô hình. Tuy nhiên, tách công việc cũng tạo ra yêu cầu phối hợp giữa các phần.
Vì vậy, “chạy được trên phần cứng khác” và “vận hành hiệu quả hơn” là hai kết luận khác nhau. Kết luận thứ hai cần số đo trên quy trình đầy đủ, bao gồm thời gian chờ và dữ liệu trao đổi, chứ không chỉ tốc độ một bước suy luận.
TorchNeuron là lớp đưa Trainium vào PyTorch
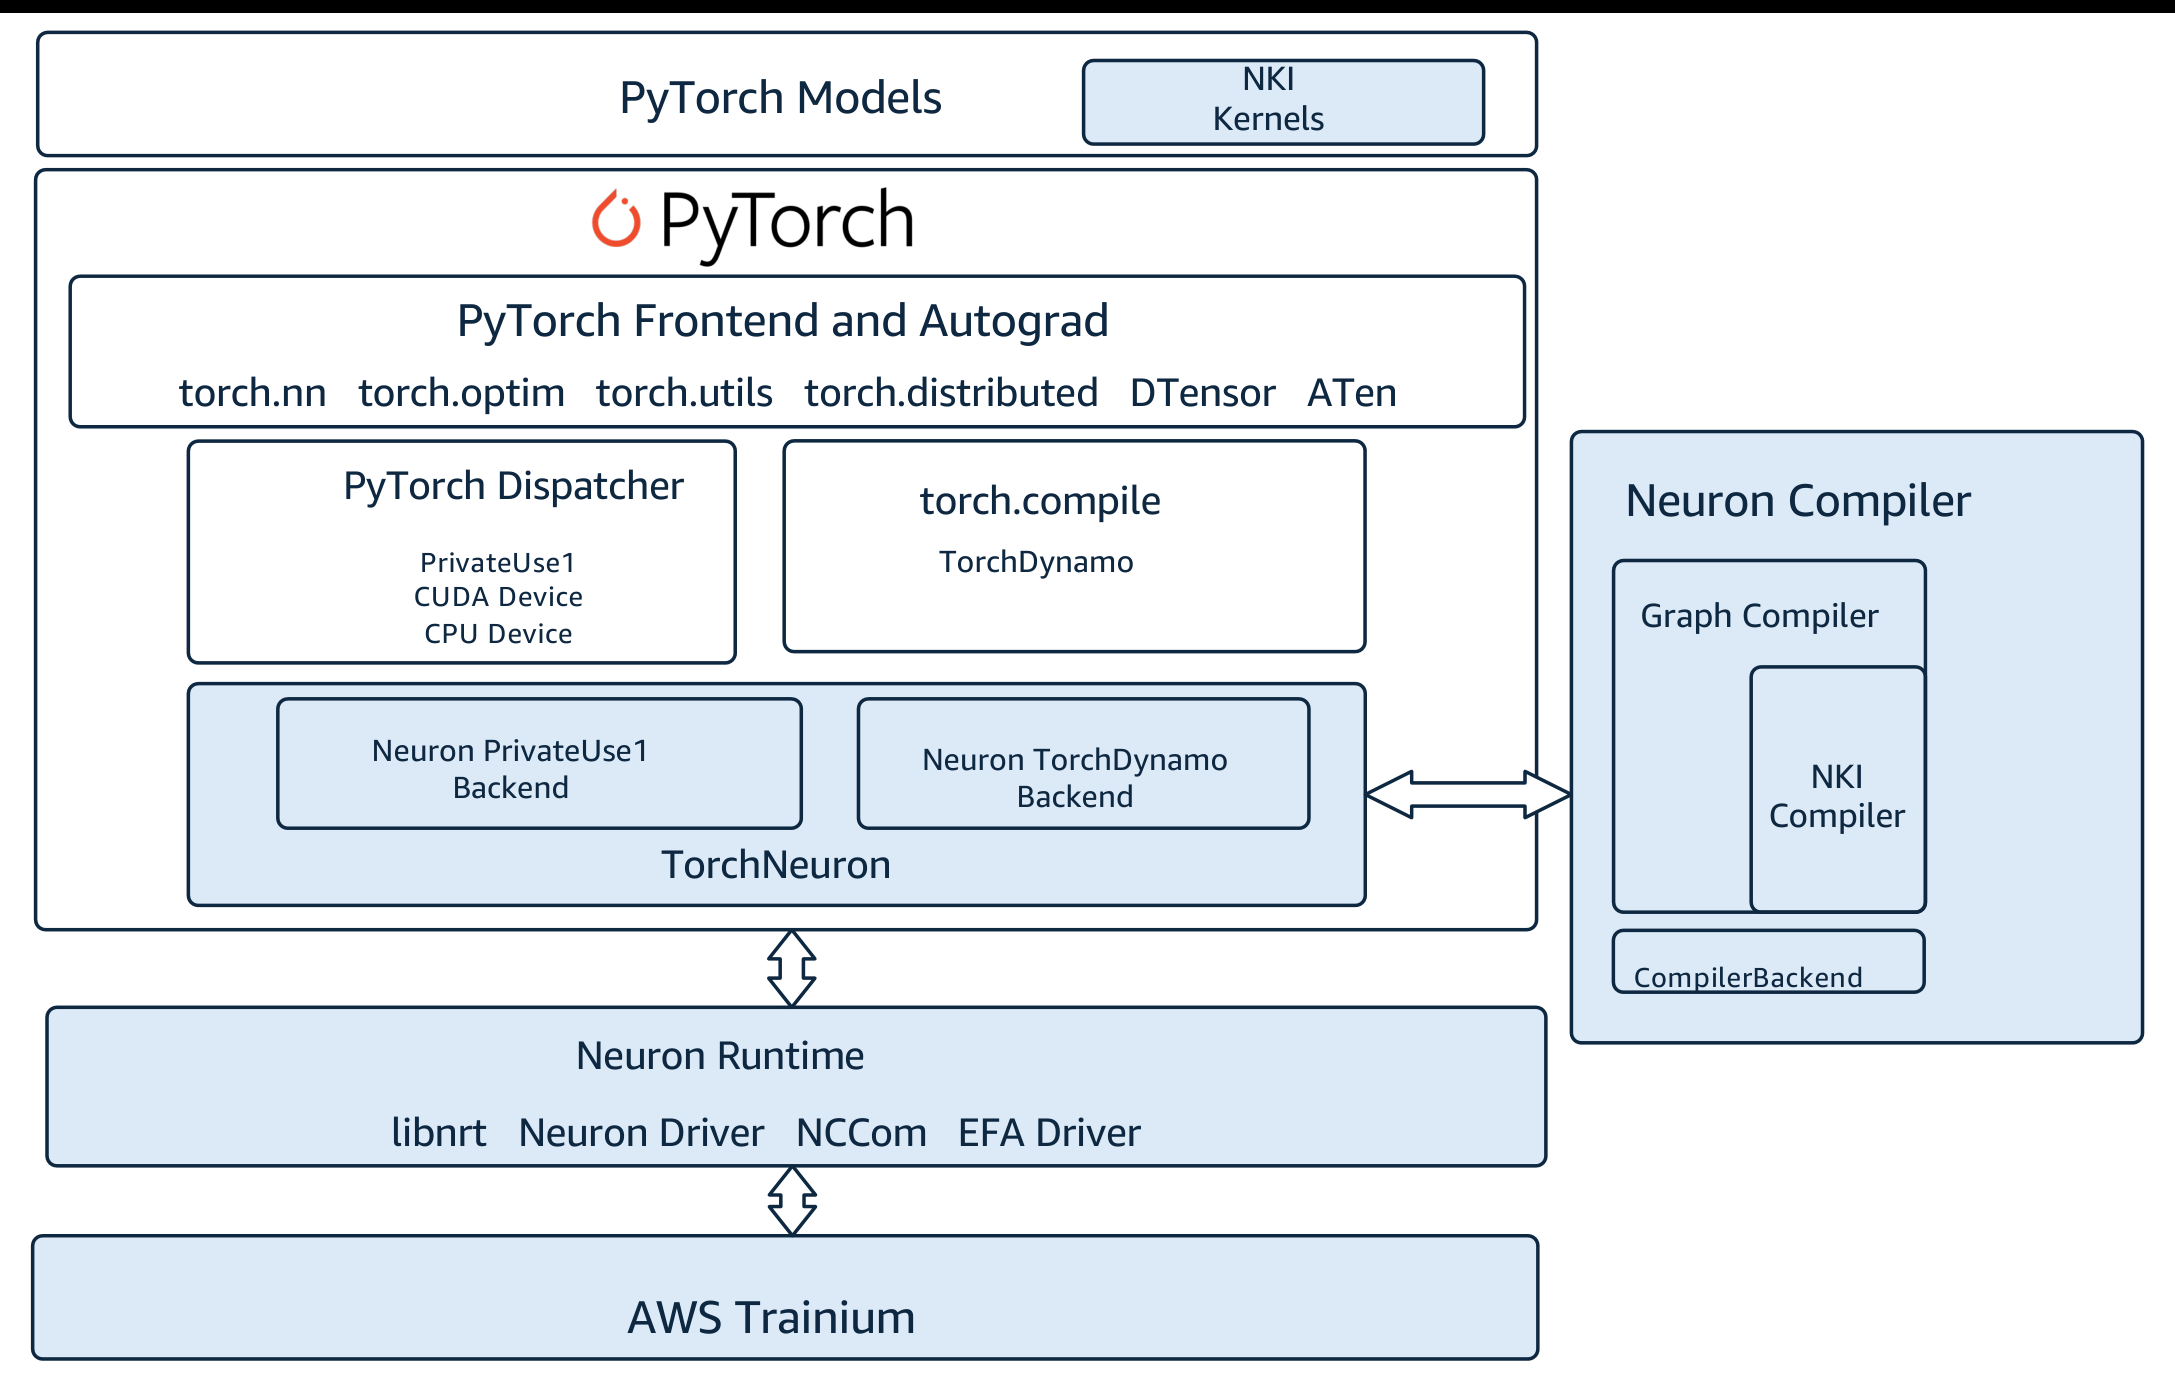
Bài giới thiệu trên PyTorch nêu TorchNeuron đăng ký Trainium qua PrivateUse1, điểm mở rộng cho phần cứng tùy biến. Nó hỗ trợ cách thực thi eager và torch.compile, cùng giao diện kernel NKI cho phần cần tối ưu thấp hơn.
Điểm thay đổi về trải nghiệm lập trình là mô hình và nhiều giao diện PyTorch quen thuộc có thể được sử dụng với thiết bị Neuron. Điều đó giúp giảm nhu cầu duy trì một cách mô tả mô hình hoàn toàn khác chỉ để chuyển nền tảng tính toán.
Nhưng tương thích giao diện không đồng nghĩa mọi chương trình có thể chuyển mà không cần kiểm tra. Bài giới thiệu liệt kê những tính năng chưa hỗ trợ trong lần đầu, trong đó có một số kiểu dữ liệu và hành vi động. Vì thế, trạng thái hỗ trợ phải được xem theo đúng mô hình và tác vụ.
Beta hỗ trợ gì, và chưa cho biết điều gì?
Thông báo SGLang nêu hai nhóm công việc là phục vụ suy luận LLM và sinh rollout trên Trainium2, Trainium3. Danh sách ban đầu có một số mô hình Qwen, DeepSeek và GLM; đây là phạm vi nhóm công bố, không phải bảo đảm mọi phiên bản hay biến thể đều hoạt động giống nhau.
Nhóm cũng báo cáo một lần chạy đầu cuối với rollout từ Qwen3-MoE-30B-A3B trên Trainium3, trong khi Miles phối hợp huấn luyện GRPO bằng Megatron trên một node H200. Đây là kết quả do dự án mô tả, chưa phải phép tái lập độc lập của phu.lt.
Thông báo không cung cấp một bảng đối chiếu đầy đủ để kết luận chi phí hoặc thời gian huấn luyện tốt hơn bao nhiêu cho mọi đội. Cách diễn giải phù hợp là dự án đã trình bày một cấu hình khả thi ban đầu, còn lợi ích định lượng phải được đo theo nhu cầu sử dụng.
Tách năng lực mở rộng cũng tạo thêm việc tích hợp
Tài liệu AWS Neuron đặt TorchNeuron trong một ngăn xếp gồm giao diện PyTorch, backend, trình biên dịch và runtime trên Trainium. Đổi thiết bị tính toán vì vậy không làm các tầng biên dịch và vận hành biến mất.
Với hệ RL dị thể, đội triển khai cần kiểm tra các phiên bản có phối hợp được, đầu ra có đúng định dạng và các bước có dùng đúng trạng thái mô hình hay không. Đây là yêu cầu biên tập rút ra từ việc chia một quy trình thành nhiều thành phần, không phải sự cố đã được xác nhận trong beta.
Một bài thử hữu ích nên đo cả vòng lặp, chất lượng kết quả và khả năng lặp lại. Nếu chỉ tối ưu phần sinh token rồi để phần khác chờ lâu hơn, mức cải thiện cục bộ chưa chắc trở thành cải thiện của cả quy trình.
Phân biệt hai cánh cửa beta
Bài PyTorch ghi TorchNeuron bắt đầu beta công khai từ ngày 20/10/2026. Trong khi đó, thông báo SGLang ngày 22/10 yêu cầu liên hệ để tham gia nhóm beta ban đầu. Không nên gộp hai mốc thành lời khẳng định plugin SGLang đã mở rộng rãi cho mọi người.
Trước khi chuyển một tác vụ quan trọng, đội kỹ thuật cần đối chiếu danh sách mô hình, tính năng và tài liệu cài đặt đúng phiên bản. Bản phân tích này không cung cấp một lệnh cài cố định vì các phụ thuộc beta còn có thể thay đổi.
Ý nghĩa của công bố nằm ở lựa chọn kiến trúc: sinh dữ liệu và học từ dữ liệu có thể được lên kế hoạch tài nguyên riêng. Bước tiếp theo cần theo dõi là phạm vi hỗ trợ, kết quả đo đầu cuối và bằng chứng vận hành ổn định khi có thêm đội tham gia.
Nguồn và sơ đồ
Nguồn: SGLang, công bố 22/10/2026; PyTorch, giới thiệu TorchNeuron; AWS, kiến trúc TorchNeuron. phu.lt chưa chạy benchmark hoặc tái lập cấu hình RL.
Sơ đồ ngăn xếp TorchNeuron: Amazon.com, Inc. hoặc các đơn vị liên kết, từ AWS Neuron SDK, giấy phép tài liệu CC BY-SA 4.0 theo tuyên bố giấy phép; sử dụng nguyên bản. Hình mô tả nền tảng TorchNeuron, không phải sơ đồ toàn bộ pipeline SGLang–Miles.