AI developer có thể thuê GPU theo giờ: Physical AI vẫn thiếu một “AWS cho robot”
Cloud đã biến GPU thành tài nguyên có thể thuê theo nhu cầu, nhưng thử một model điều khiển robot vẫn thường đòi hỏi mua phần cứng, dựng lab, hiệu chuẩn và vận hành tại chỗ. Datakin đang thử biến robot thật thành tài nguyên có thể đặt lịch từ xa — một ý tưởng đã có tiền lệ trong nghiên cứu, nhưng khó hơn rất nhiều so với cho thuê compute.

Một developer muốn thử model AI mới hôm nay có thể thuê GPU trên cloud, dựng container và bắt đầu chạy trong vài phút. Với Physical AI, vòng lặp đó thường dừng lại ngay khi code phải chạm vào thế giới thật: cần một cánh tay robot hoặc humanoid, camera và cảm biến đã hiệu chuẩn, không gian an toàn, người vận hành, quy trình reset sau mỗi lần chạy và thời gian lab.
Khoảng cách này đang tạo ra một câu hỏi hạ tầng khá tự nhiên: nếu AWS đã biến compute thành tài nguyên có thể gọi theo nhu cầu, liệu robot thật có thể trở thành một loại tài nguyên tương tự?
Datakin là một startup đang thử xây đúng lớp đó. Công ty gọi sản phẩm của mình là “Real-Robot Testing Cloud”: developer chọn robot từ một catalog, đặt lịch, cấu hình bài test, chạy từ xa, nhận video và telemetry rồi tải về báo cáo cùng dữ liệu của phiên thử nghiệm. Trên website, Datakin thậm chí dùng thẳng cụm “AWS for Robotics”.
Ý tưởng nghe đơn giản, nhưng điểm đáng chú ý nằm ở phần phía sau giao diện đặt lịch. GPU có thể được ảo hóa và nhân bản tương đối dễ. Robot thì không. Mỗi lần chạy có thể làm pin tụt, gripper lệch, vật thể đổi vị trí, camera mất calibration hoặc chính phần cứng bị hỏng. Một “cloud robot” vì thế phải giải quyết cả bài toán vật lý mà cloud computing gần như không gặp.
Cloud compute đã giải quyết phần dễ hơn của Physical AI
Phần tính toán của robotics ngày càng giống AI software thông thường. Model perception, vision-language-action model, reinforcement learning và world model đều có thể được train trên GPU cluster thuê từ AWS, Google Cloud, Azure, Nebius hoặc các AI cloud chuyên dụng. AWS hiện đã có kiến trúc Physical AI for Robotics, trong đó NVIDIA Isaac Sim và Isaac Lab chạy trên EC2 để mô phỏng và huấn luyện trước khi policy được đưa sang hardware thật.
Nhưng simulation chỉ giải quyết được một phần vòng lặp. Chính AWS cũng mô tả sim-to-real gap là một trong những trở ngại cứng nhất của Physical AI: ma sát, độ trễ actuator, camera noise, độ mềm của vật liệu, ánh sáng và những va chạm ngoài dự kiến luôn khác ít nhiều so với simulator. Một policy có thể đạt kết quả đẹp trong thế giới ảo rồi thất bại ngay ở lần chạy đầu tiên trên robot thật.
Đây là phần mà một “AWS cho robot” muốn bổ sung. Thay vì buộc mỗi nhóm phải mua và tự vận hành một fleet phần cứng, hạ tầng chung sẽ cho họ thuê thời gian trên robot thật giống như thuê thời gian trên GPU.
Datakin muốn biến robot thành một tài nguyên có thể đặt lịch
Theo mô tả công khai hiện tại, Datakin đang onboarding các pilot partner trong quý III/2026. Workflow mà công ty đề xuất có năm bước: chọn robot, tạo bài test, chạy trực tiếp, nhận báo cáo và lưu dữ liệu sinh ra từ phiên thử nghiệm.
Lớp điều khiển được mô tả sử dụng ROS 2, gRPC và WebRTC; camera, depth và telemetry được stream về người dùng. Phía dưới còn có các cơ chế an toàn như emergency stop, giới hạn vùng hoạt động và giới hạn chuyển động. Datakin quảng bá mức telemetry dưới 50 ms, nhưng đây hiện là số liệu do công ty tự công bố, chưa phải benchmark độc lập.
Roadmap trên website liệt kê giai đoạn pilot với 12 robot tại châu Âu, sau đó mới tới paid validation và mục tiêu mở rộng hơn 100 robot trên ba châu lục. Vì vậy cần phân biệt khá rõ giữa kiến trúc mà Datakin muốn xây và một mạng lưới robot cloud đã được triển khai ở quy mô lớn. Tại thời điểm viết bài, đây vẫn là hạ tầng ở giai đoạn pilot.
Điểm thú vị hơn bản thân việc điều khiển robot từ xa là cách Datakin nhìn mỗi lần chạy như một đơn vị dữ liệu. Camera frame, trạng thái joint, action, latency, kết quả task và failure đều có thể được đóng gói thành một episode có provenance rõ ràng. Nếu nhiều nhóm cùng chạy những bài test chuẩn hóa, hạ tầng robot không chỉ cho thuê hardware; nó còn trở thành một nhà máy tạo dữ liệu thực tế.
Ý tưởng “robot cloud” không bắt đầu từ Datakin
Remote access tới robot thật đã được giới nghiên cứu thử nghiệm từ trước. Một ví dụ rõ là CloudGripper tại KTH Royal Institute of Technology ở Thụy Điển.
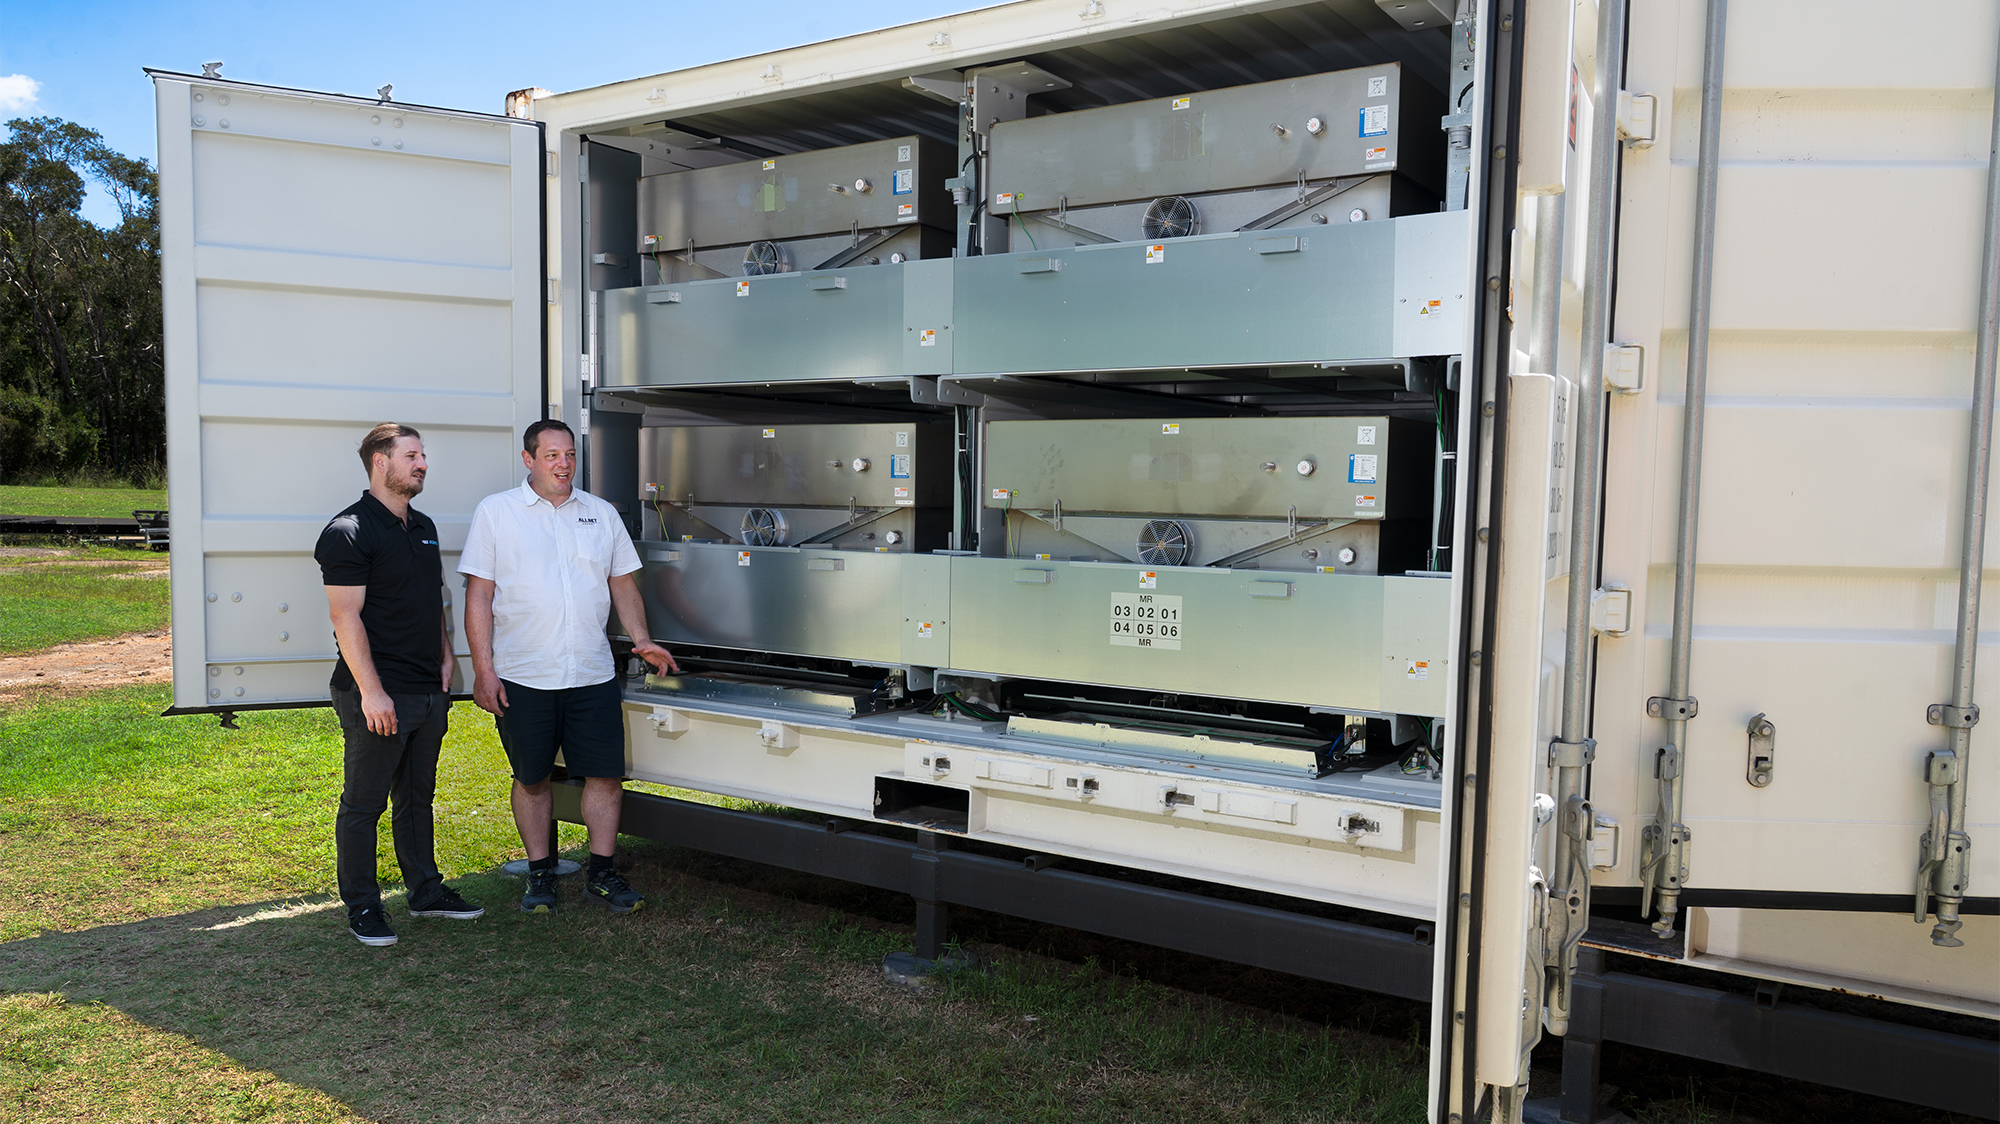
Hệ thống này gồm 32 cell robot nhỏ đặt trong rack, mỗi cell có một cánh tay 5 bậc tự do, gripper, camera và enclosure riêng. Paper được công bố tại IEEE ICRA 2024 mô tả mạng 10 Gbit/s và API cho phép các nhà nghiên cứu điều khiển từ xa. Một dataset proof-of-concept từ hệ thống chứa hơn 100 giờ robot đẩy dây và khoảng 4 triệu ảnh camera.
Năm 2026, CloudGripper còn được dùng cho một track của Robotic Grasping and Manipulation Competition tại ICRA. Các đội có 10 tuần truy cập robot từ xa theo slot đặt trước, gửi command qua Python API và nhận video về để phát triển thuật toán. Đây gần như là phiên bản học thuật của ý tưởng “thuê robot qua Internet”: hardware nằm ở Stockholm nhưng người viết code có thể ở nơi khác.
Khác biệt mà các startup như Datakin muốn tạo ra là chuyển mô hình đó từ testbed nghiên cứu sang một dịch vụ chung: nhiều loại robot hơn, scheduling, observability, dataset pipeline, repeatable test và cuối cùng là billing như một sản phẩm hạ tầng.
Vì sao cho thuê robot khó hơn cho thuê GPU?
GPU cloud được hưởng lợi từ một thuộc tính quan trọng: cùng một workload có thể được chạy lại trên một instance gần như giống hệt instance trước. Với robot, “cùng một test” không bao giờ hoàn toàn giống.
Một cốc có thể lệch 3 mm. Tay gắp có thể nóng hơn. Miếng cao su trên gripper mòn thêm sau 5.000 lần đóng mở. Ánh sáng phòng thay đổi. Một camera vừa bị rung khỏi góc ban đầu. Pin có điện áp khác. Những khác biệt nhỏ này có thể đủ làm thay đổi kết quả của policy.
Do đó hạ tầng phải cung cấp nhiều thứ hơn API điều khiển:
- Reset vật lý: sau một lần robot làm rơi đồ vật, ai hoặc cái gì sẽ đưa scene về trạng thái ban đầu?
- Calibration: hệ thống phải biết camera, gripper, joint và sensor vẫn nằm trong tolerance nào.
- Safety: code của khách hàng không thể được phép gửi bất kỳ trajectory nào tới một cỗ máy có thể va vào người hoặc tự phá hỏng.
- Versioning: model, firmware, gripper, payload, scene và calibration đều phải được ghi lại nếu muốn kết quả có thể tái lập.
- Embodiment: cùng một policy không thể mặc nhiên chạy trên Franka, UR, humanoid hay mobile manipulator mà không có lớp chuyển đổi.
Nói cách khác, EC2 chủ yếu quản lý tài nguyên số. Robot cloud phải quản lý tài nguyên số lẫn entropy của thế giới vật lý.
“AWS cho robot” có lẽ sẽ bắt đầu bằng testing, không phải training
Có một lý do Datakin tự định vị là testing cloud thay vì hứa cung cấp hàng triệu giờ training ngay từ đầu. Training robot thật ở quy mô lớn rất tốn thời gian và gây hao mòn phần cứng. Testing cần ít episode hơn, nhưng giá trị của mỗi episode cao hơn vì nó trả lời một câu hỏi cụ thể: policy mới có thực sự tốt hơn bản cũ trên cùng hardware và cùng protocol hay không?
Đây cũng là nơi robotics hiện thiếu tiêu chuẩn chung. Một nhóm có thể báo success rate 90%, nhưng con số khó so sánh nếu robot, vật thể, cách reset, ánh sáng, số lần thử và tiêu chí thành công khác với nhóm khác. Một hạ tầng vật lý dùng chung có thể giúp đóng băng nhiều biến số đó.
Các nỗ lực học thuật mới như ManipulationNet cũng đang đi theo hướng xây hạ tầng benchmark robot thật có khả năng tái lập. Điều này cho thấy nhu cầu không chỉ nằm ở “có robot để chạy”, mà ở khả năng đo cùng một model theo cùng một chuẩn.
Vẫn chưa có EC2 instance type cho thế giới vật lý
Ẩn dụ AWS rất hữu ích để hình dung sản phẩm, nhưng nó cũng dễ che mất khác biệt lớn nhất của robotics. Compute đã được chuẩn hóa quanh CPU, GPU, memory, storage và network. Robot chưa có một abstraction tương đương.
Một model điều khiển cánh tay 7-DOF với parallel gripper cần input/output khác robot hình người có hai tay, tactile sensor và bàn tay nhiều ngón. Thậm chí hai robot cùng model cũng có thể khác nhau vì wear, calibration và end-effector. Nếu muốn robot trở thành tài nguyên cloud thực sự, ngành sẽ cần các chuẩn không chỉ cho API, mà còn cho mô tả embodiment, task, scene, safety envelope, episode format và chất lượng calibration.
Đó có thể mới là “moat” thật sự của một nền tảng như Datakin nếu mô hình này thành công: không phải sở hữu nhiều robot nhất, mà làm cho phần cứng khác nhau đủ chuẩn hóa để developer có thể gửi cùng một experiment tới nhiều embodiment và nhận lại kết quả có thể so sánh.
Hiện chưa có bằng chứng rằng Datakin đã giải quyết được phần khó đó ở quy mô production. Website công ty mới cho thấy kiến trúc, pilot roadmap và các chỉ số do họ tự công bố. Các câu hỏi thực tế — giá mỗi giờ robot, tỷ lệ uptime, tốc độ reset, số loại hardware, quy trình xử lý sự cố và mức độ tái lập giữa các site — vẫn cần dữ liệu vận hành.
Nhưng nhu cầu mà ý tưởng này nhắm tới là có thật. Cloud đã làm cho một developer nhỏ có thể thử model lớn mà không cần sở hữu datacenter. Nếu Physical AI muốn có vòng lặp thử nghiệm tương tự, phần còn thiếu không chỉ là thêm GPU. Nó là một lớp hạ tầng biến robot, phòng lab và dữ liệu thế giới thật thành tài nguyên có thể đặt lịch, đo lường và dùng lại.