Gimlet ghép GPU với Cerebras, đặt mục tiêu tới 3.000 token/giây
Đám mây suy luận mới phân chia công việc theo thế mạnh từng loại chip. Quy mô 100 MW và tốc độ tối đa vẫn là kế hoạch cần kiểm chứng khi triển khai.
Ngày 28/9/2026, Gimlet Labs và Cerebras công bố hợp tác đưa bộ xử lý quy mô wafer vào Gimlet Cloud, bên cạnh GPU. Hai công ty đặt mục tiêu tốc độ tới 3.000 token/giây cho các ứng dụng AI tương tác và agent. Đây là mức do nhà cung cấp công bố, chưa phải kết quả đo độc lập cho mọi mô hình.
Ý tưởng đáng chú ý nằm ở cách chia việc. Một yêu cầu AI có thể đi qua nhiều loại phần cứng, được điều phối bằng phần mềm, thay vì buộc toàn bộ quá trình chạy trên cùng một kiến trúc. Người dùng cuối vẫn nhận câu trả lời qua giao diện của dịch vụ.
Tốc độ tạo token phụ thuộc cả đường đi của dữ liệu
Trong bài giải thích kiến trúc công bố tháng 8/2026, Cerebras mô tả một nút thắt của suy luận: phải chuyển trọng số mô hình tới các lõi tính toán. Khi việc di chuyển dữ liệu chiếm nhiều thời gian, tăng năng lực tính toán đơn thuần không bảo đảm một câu trả lời được sinh nhanh hơn.
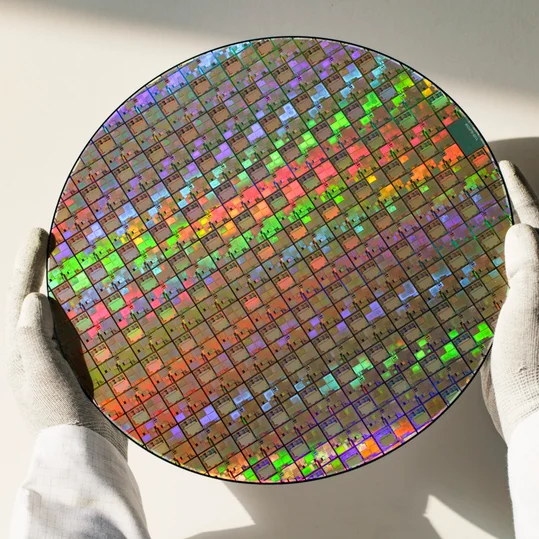
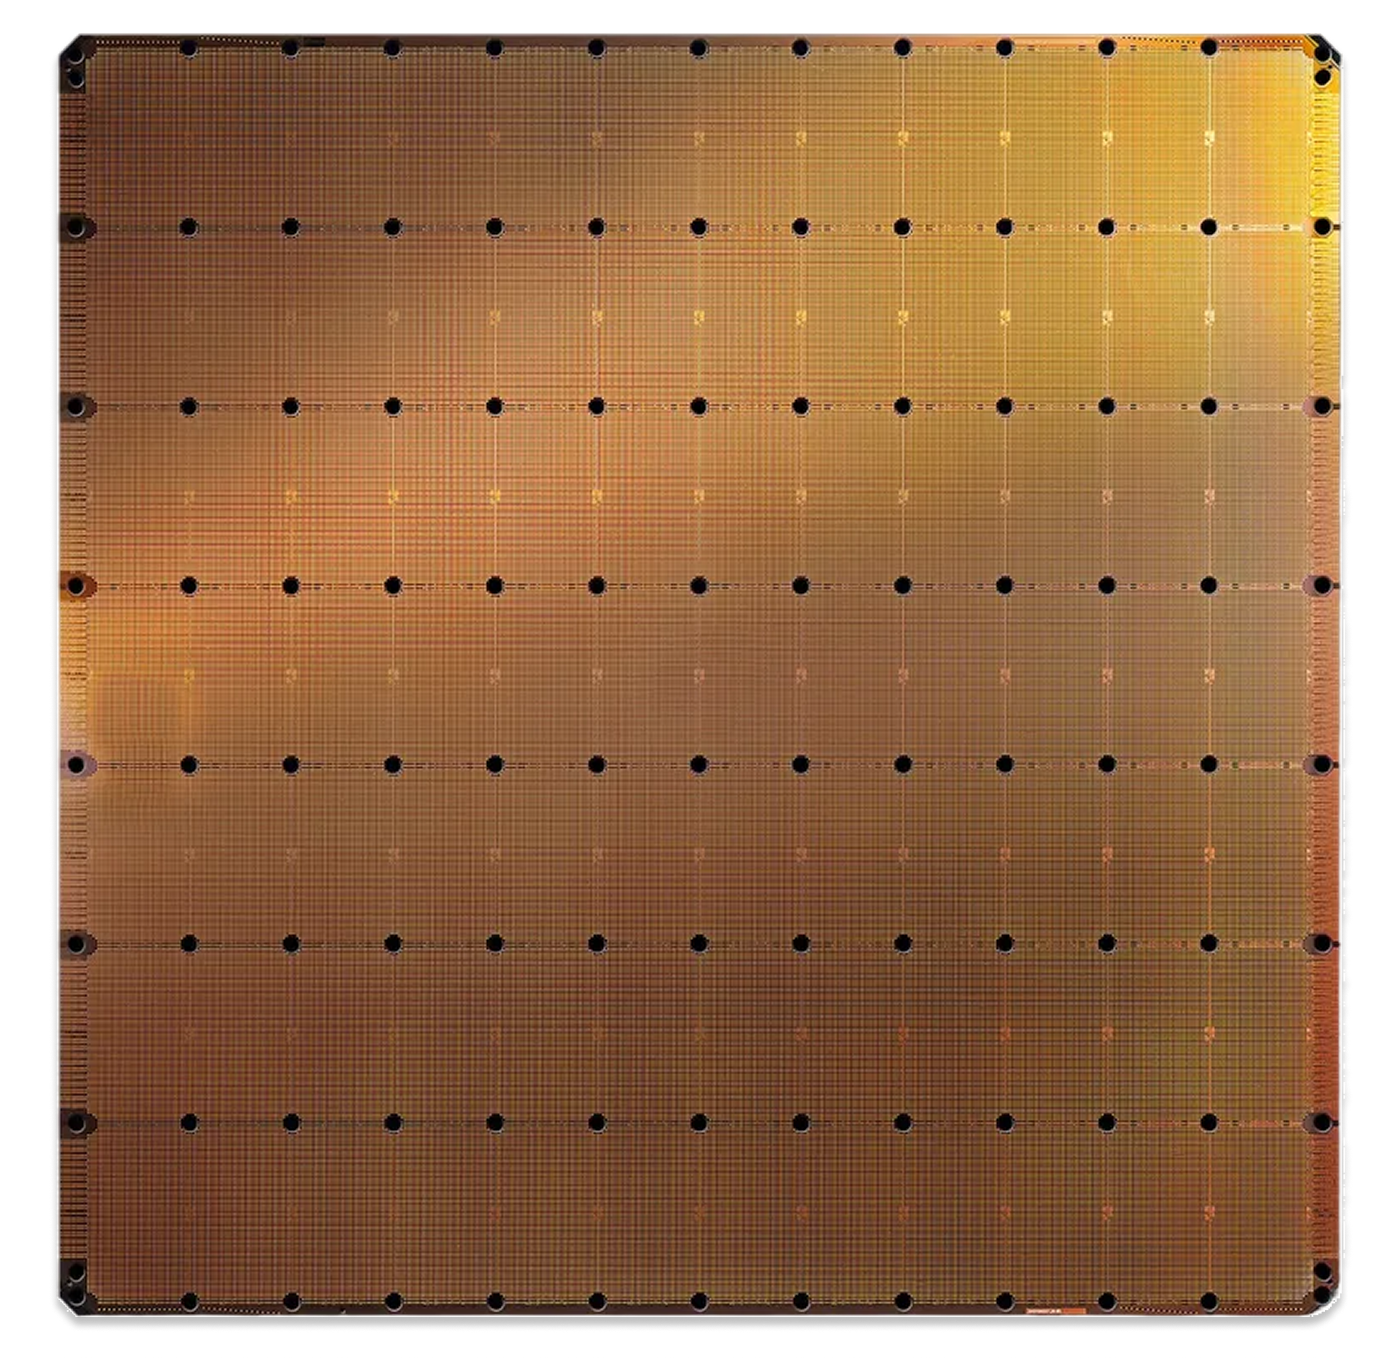
WSE-3 đưa bộ nhớ SRAM và các lõi xử lý lên cùng một wafer lớn. Cerebras công bố 44 GB SRAM nằm gần 900.000 lõi. Với mô hình không vừa một bộ xử lý, hãng mô tả cách phân chia các lớp qua nhiều hệ thống, giữ trọng số gần nơi tính toán và truyền kết quả trung gian giữa các chặng.
Những thông số này mô tả kiến trúc của Cerebras, không phải cấu hình đã được đo của toàn bộ Gimlet Cloud. Lợi ích thực tế còn phụ thuộc mô hình, cách phân chia và chi phí trao đổi dữ liệu giữa các hệ thống.
Phần mềm quyết định tác vụ chạy ở đâu
Gimlet đã trình bày nền tảng của mình trong bài giới thiệu tháng 10/2025: bộ điều phối tách đồ thị tính toán thành các phần, trình biên dịch tối ưu chúng cho phần cứng tương ứng, còn hệ thống tạo kernel hỗ trợ xây dựng các hàm tính toán chuyên biệt.
Theo mô tả đó, phần việc cần nhiều phép tính có thể được đưa tới GPU có thông lượng cao; phần bị giới hạn bởi bộ nhớ được đưa tới bộ tăng tốc có băng thông phù hợp. Công việc chịu ràng buộc mạng cần nút có kết nối nhanh. Đây là cách hãng giải thích thiết kế, chưa phải bằng chứng rằng mọi tác vụ đều hưởng lợi.
Trong thông báo hợp tác mới, Gimlet nêu các cách tách sâu hơn, gồm giai đoạn đọc đầu vào và sinh token, phần attention và feed-forward, cùng các thành phần của suy luận dùng dự đoán trước. Hãng cho biết phần mềm điều phối qua nhiều nút nhưng cung cấp một API suy luận thống nhất.
Về kỹ thuật, việc chia nhỏ chỉ đáng làm khi phần thời gian tiết kiệm lớn hơn chi phí truyền dữ liệu và đồng bộ. Nếu một chặng phải chờ chặng khác, bộ xử lý nhanh vẫn có thể bị bỏ trống. Đây là bài toán cần đo ở cấp hệ thống, không thể suy ra chỉ từ thông số của chip.
Đọc đúng con số 3.000 token/giây
Token là đơn vị mô hình xử lý văn bản, không tương đương cố định với một từ hay một ký tự. Tốc độ sinh token cũng chỉ là một phần của thời gian từ lúc gửi yêu cầu tới lúc công việc hoàn tất.
Ví dụ minh họa: nếu một tác vụ cần sinh 6.000 token và duy trì đều 3.000 token/giây, riêng khâu sinh mất khoảng hai giây. Phép tính này chưa bao gồm đọc đầu vào, xếp hàng, truy xuất dữ liệu, gọi công cụ hoặc thử lại. Nó không phải phép đo của Gimlet.
Với agent phải gọi nhiều dịch vụ, cần đánh giá cả chuỗi công việc. Một mô hình viết nhanh hơn nhưng vẫn chờ trình duyệt tải trang hay chờ cơ sở dữ liệu trả kết quả sẽ không tăng tốc toàn bộ tác vụ theo cùng tỷ lệ. Tốc độ tối đa nên được đọc kèm tên mô hình, độ dài ngữ cảnh, số yêu cầu đồng thời và chất lượng đầu ra.
100 MW là quy mô dự kiến triển khai
Gimlet cho biết hai bên có kế hoạch triển khai năng lực suy luận dùng Cerebras ở quy mô 100 MW. Đây là thông tin về quy mô hạ tầng dự kiến, không có nghĩa toàn bộ công suất ấy đã vận hành. MW cũng không phải đơn vị đo số token hay lượng điện cho mỗi câu trả lời.
Thông cáo chung dự kiến trung tâm dữ liệu Gimlet Cloud đầu tiên dùng Cerebras đi vào hoạt động cuối năm 2026. Hai bên nói giải pháp tích hợp đã phục vụ lưu lượng trong các triển khai riêng. Gimlet đồng thời là đối tác ra mắt CS-4; theo blog của công ty, khách hàng được kỳ vọng tiếp cận thế hệ tiếp theo trong năm 2027.
Cần đo lợi ích trên công việc hoàn chỉnh
Nhà phát triển muốn đánh giá dịch vụ nên dùng cùng dữ liệu, cùng yêu cầu chất lượng và cùng mức tải để so sánh thời gian hoàn thành. Cần tính cả yêu cầu thất bại, lần gọi lại và chi phí tổng, thay vì chỉ chọn câu trả lời có tốc độ cao nhất.
Sự kết hợp nhiều loại chip mở thêm cách bố trí hạ tầng, nhưng thông báo lần này chưa đủ để xác nhận mức tiết kiệm điện, giá thành hoặc cam kết tốc độ cho từng ứng dụng. Những kết luận đó cần cấu hình dịch vụ và số đo có thể kiểm tra khi hệ thống được triển khai rộng hơn.
Ảnh chip WSE-3: hình được Gimlet Labs sử dụng trong bài công bố hợp tác với Cerebras ngày 28/9/2026.