AI học nhìn từ hàng tỷ hình ảnh: Robot có thể cần một “Internet dữ liệu xúc giác” để học cách chạm
Thị giác máy tính lớn lên nhờ những kho dữ liệu web có hàng trăm triệu đến hàng tỷ cặp hình–text. Xúc giác robot thì không có nguồn dữ liệu tự nhiên tương tự: mỗi lần “chạm” phải được tạo ra bằng phần cứng thật, đồng bộ với lực và chuyển động, rồi dịch giữa những cảm biến nói các ngôn ngữ khác nhau. Từ Sparsh, T3 đến FTP-1 và N₀-Foundation, các nhóm nghiên cứu đang bắt đầu xây lớp hạ tầng còn thiếu đó.


AI học nhìn có một lợi thế mà robot học chạm chưa từng có: Internet đã tạo sẵn một kho hình ảnh khổng lồ trước khi các foundation model xuất hiện. ImageNet từng cần hơn 25.000 người gán nhãn khoảng 14 triệu ảnh. Sau đó, CLIP của OpenAI học từ 400 triệu cặp hình–text thu thập từ web; LAION-5B tiếp tục đẩy quy mô dữ liệu mở lên 5,85 tỷ cặp.
Không có một nguồn tương đương cho cảm giác chạm. Một bức ảnh có thể được sao chép từ web trong vài mili-giây. Muốn có một mẫu tactile, một robot hoặc con người phải thực sự chạm vào vật thể bằng một cảm biến cụ thể, ở một vị trí, hướng, lực và tốc độ cụ thể. Nếu muốn dữ liệu hữu ích cho điều khiển robot, tín hiệu chạm còn phải được đồng bộ với camera, tư thế bàn tay, chuyển động và hành động đang thực hiện.
Đó là lý do một hướng phát triển đáng chú ý của robotics trong năm 2026 không nằm ở việc chế tạo thêm một “ngón tay điện tử” nhạy hơn. Các nhóm nghiên cứu đang cố xây thứ gần giống một Internet dữ liệu xúc giác: kho kinh nghiệm chạm đủ lớn, đủ đa dạng và — khó nhất — đủ chuẩn hóa để một robot có thể học từ những lần chạm được thu trên cảm biến và phần cứng khác.
Đây là cách ví von về dữ liệu, không phải thuật ngữ viễn thông Tactile Internet đã được ITU và IEEE dùng từ lâu cho mạng truyền tín hiệu haptic với độ trễ rất thấp. Mục tiêu ở đây khác: tạo “nguyên liệu huấn luyện” cho tactile AI.
Thị giác có web; xúc giác phải tự tạo từng byte dữ liệu
Sự khác biệt bắt đầu từ cách dữ liệu sinh ra. Camera có thể nhìn một căn phòng mà không làm thay đổi nó. Cảm biến xúc giác chỉ có dữ liệu khi có tiếp xúc vật lý. Muốn biết một quả đào mềm đến đâu, robot phải ép vào nó. Muốn học thế nào là vật sắp trượt khỏi tay, robot phải tạo hoặc quan sát chính khoảnh khắc trượt đó.
Dữ liệu tactile vì vậy đắt hơn dữ liệu hình ảnh theo nhiều nghĩa. Nó cần robot thật hoặc dụng cụ thu chuyên dụng; cảm biến có thể mòn; gel, bề mặt và calibration thay đổi theo thời gian; một lần thao tác thất bại có thể làm rơi hoặc phá vật thể. Với các nhiệm vụ như cắm đầu nối, gập vải hay mở nắp, dữ liệu còn mang tính chuỗi thời gian: một frame xúc giác đơn lẻ thường không cho biết robot đang ép mạnh dần, trượt sang bên hay vừa vượt qua một điểm kẹt.
Và không giống ảnh JPEG, tactile data chưa có một định dạng thống nhất. Một GelSight ghi lại biến dạng của lớp đàn hồi bằng camera. Một tactile array trả về lưới áp lực. Một cảm biến lực–mô-men cho sáu con số. Hai cảm biến cùng đo “chạm” nhưng tín hiệu thô có thể khác nhau tới mức một model được huấn luyện trên thiết bị này không thể nhận trực tiếp dữ liệu từ thiết bị kia.
Từ 460.000 ảnh chạm đến 3 triệu điểm dữ liệu đa cảm biến
Một trong những bước đầu tiên theo hướng foundation model cho xúc giác là Sparsh của Meta FAIR, công bố năm 2024. Thay vì huấn luyện một model riêng cho từng nhiệm vụ, Sparsh dùng self-supervised learning trên hơn 460.000 tactile images từ các cảm biến vision-based như DIGIT và GelSight. Meta đồng thời xây TacBench với sáu nhóm tác vụ để đánh giá representation học được.
Điểm quan trọng của Sparsh không nằm ở việc 460.000 là một con số khổng lồ theo chuẩn computer vision — nó không phải. Ý nghĩa nằm ở việc tactile perception bắt đầu chuyển từ “có một sensor, thu một dataset cho một task” sang pretraining một representation rồi tái sử dụng ở nhiều task.
T3, hay Transferable Tactile Transformers, tiếp tục giải một nút thắt khác: khác biệt giữa cảm biến. Công trình của MIT CSAIL, xuất hiện tại Conference on Robot Learning, gom nhiều dataset mở thành FoTa với hơn 3 triệu điểm dữ liệu từ 13 cảm biến và 11 tác vụ. Kiến trúc dùng encoder riêng cho từng sensor nhưng chia sẻ một transformer trunk, nhằm học phần thông tin chung nằm bên dưới những kiểu dữ liệu tactile khác nhau.
Trong thí nghiệm cắm pin điện tử với độ chính xác dưới milimet, nhóm báo cáo T3 tăng tỷ lệ thành công 25% so với policy dùng tactile encoder huấn luyện từ đầu, và 53% so với policy không dùng xúc giác. Quan trọng hơn với câu chuyện dữ liệu, FoTa được phát hành ở định dạng thống nhất — một bước nhỏ nhưng cần thiết nếu nhiều lab muốn gom kinh nghiệm chạm thay vì giữ từng dataset trong một silo riêng.
FTP-1 thử làm cho 21 loại cảm biến “nói chung một ngôn ngữ”
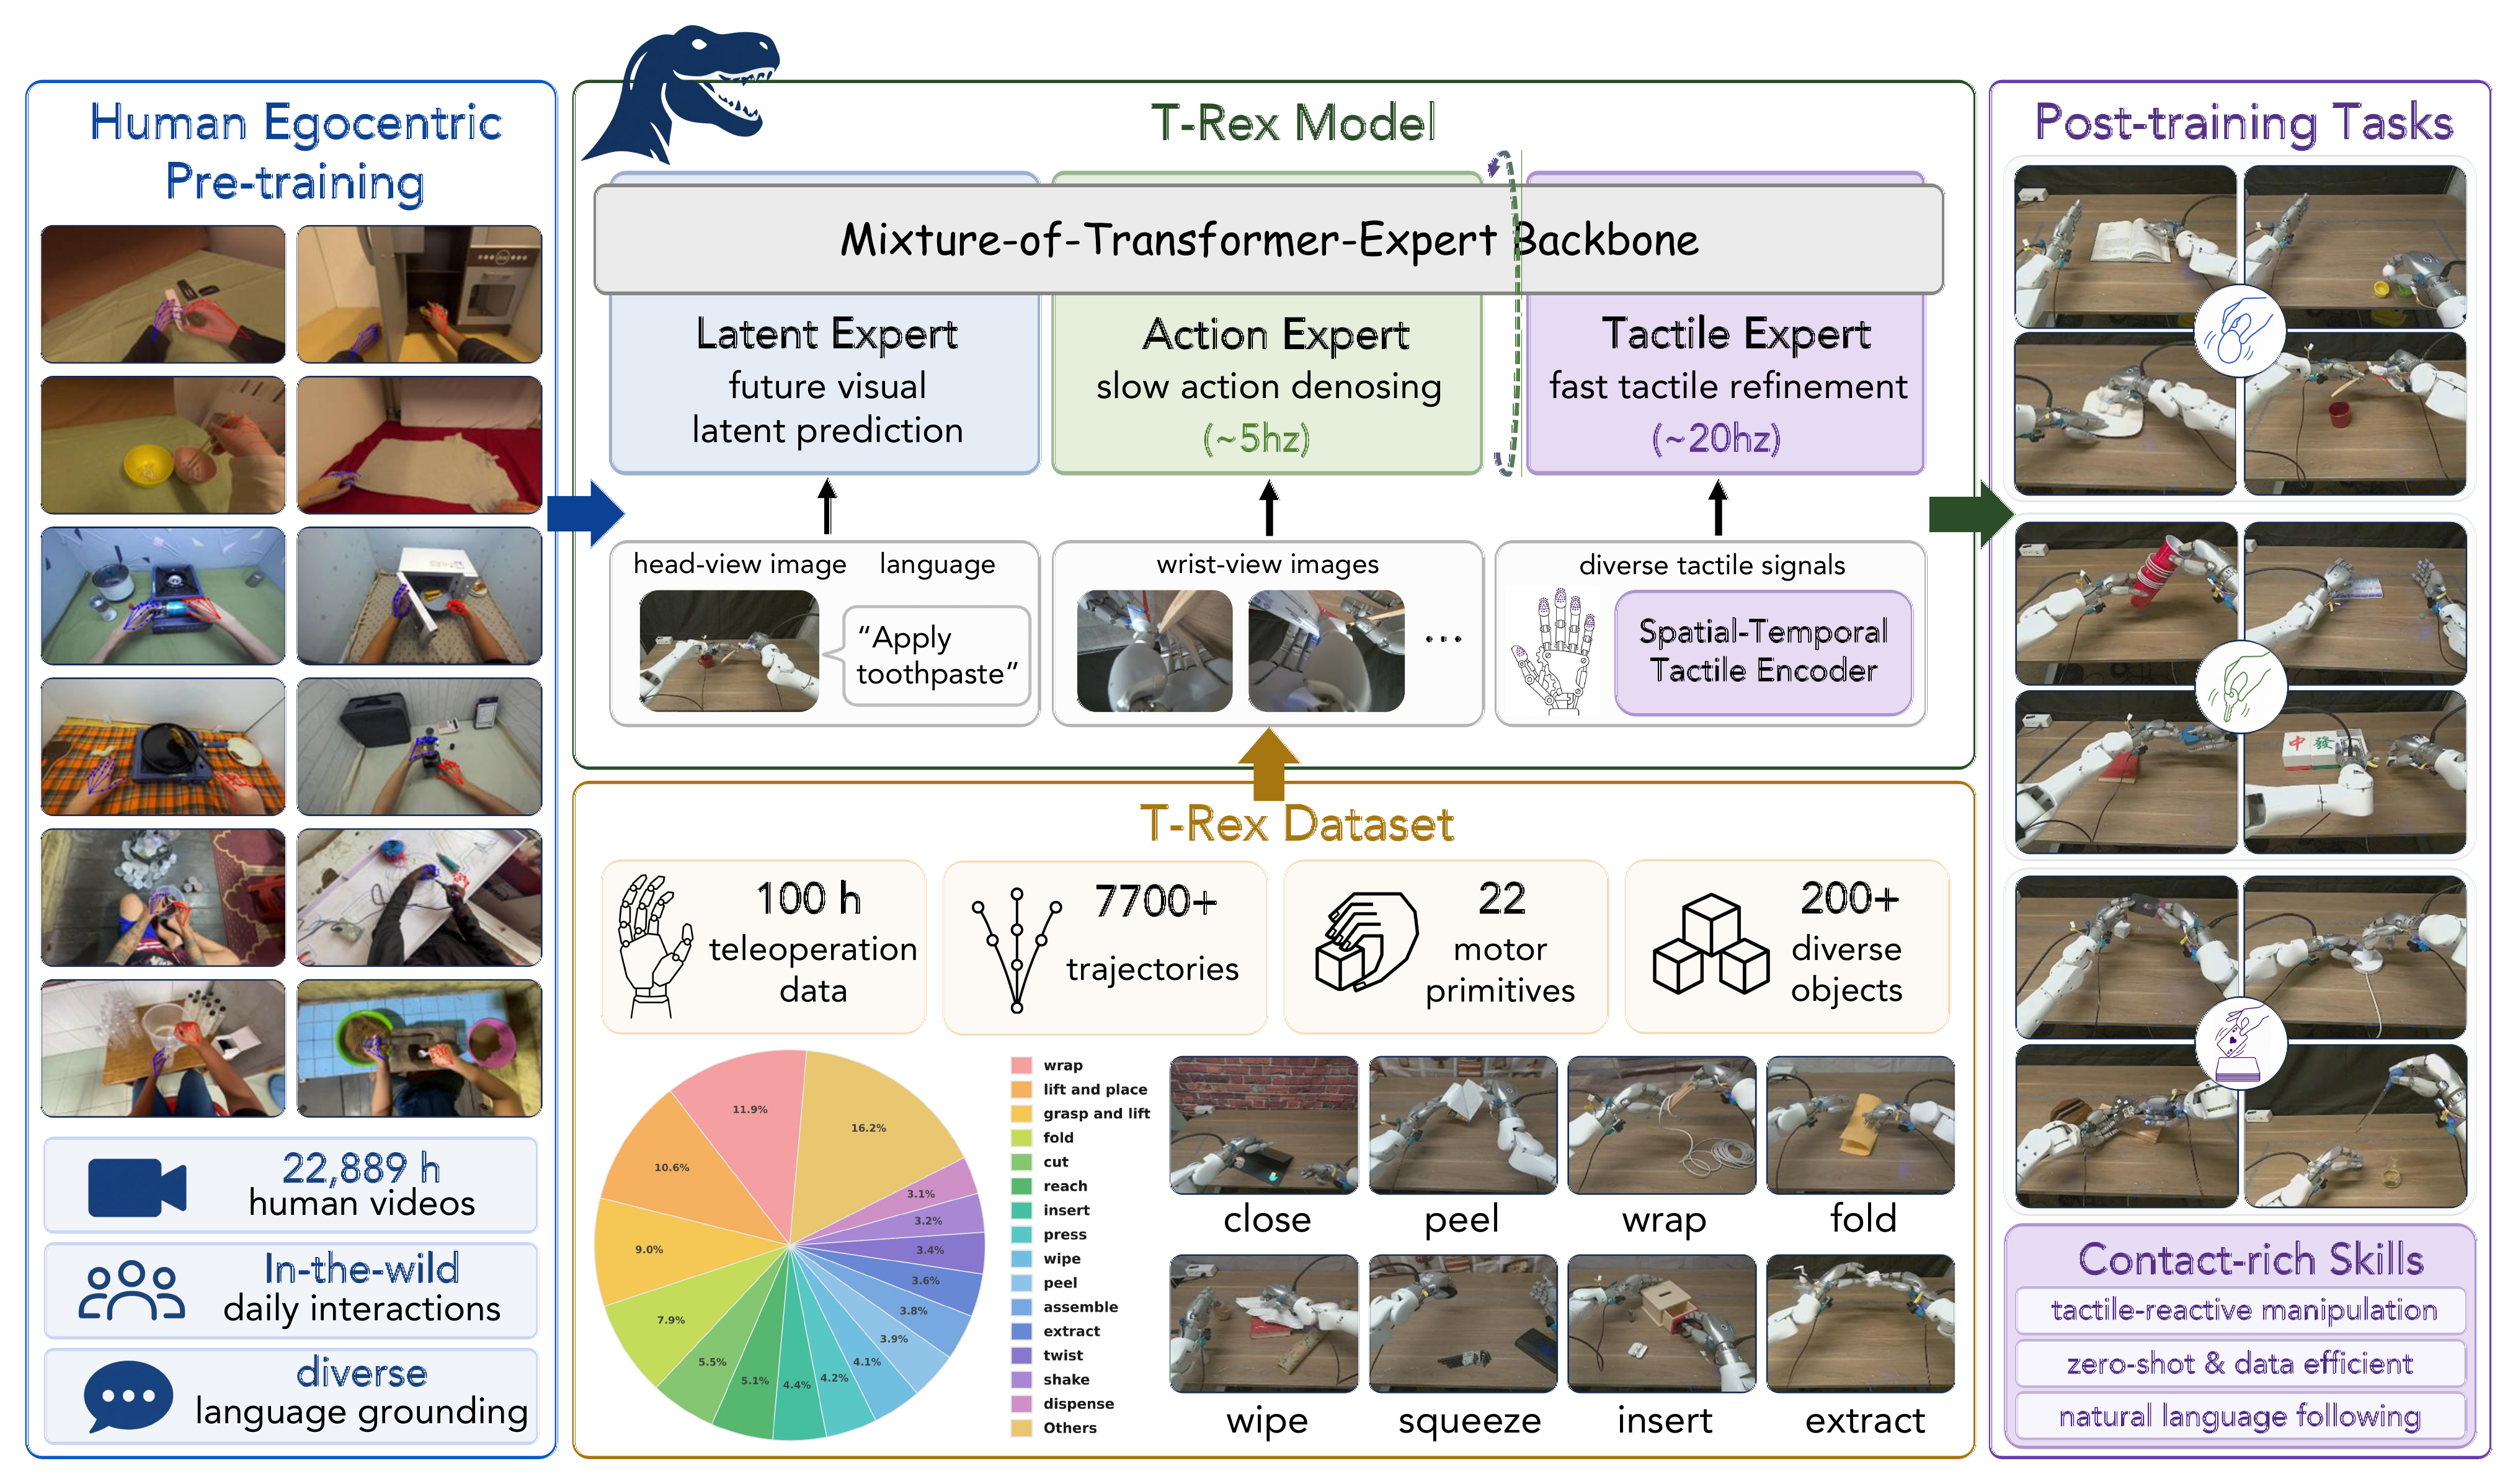
Đến năm 2026, quy mô bắt đầu tăng theo giờ tương tác thay vì chỉ tính frame. FTP-1, một preprint từ nhóm Tsinghua University, Fudan University, UC Berkeley, ETH Zurich, Shanghai Jiao Tong University và các đối tác, pretrain trên khoảng 3.000 giờ tactile manipulation tổng hợp từ 26 nguồn dữ liệu và 21 loại cảm biến.
Những sensor này không cùng một họ. Dataset gồm bảy loại image-based, năm loại array-based và chín loại state-based. Để đưa chúng vào cùng một policy, FTP-1 xây Morphology-Aware Tactile Token Space (MTTS): mỗi tín hiệu được chuyển thành token trong một interface chung, kèm thông tin về vị trí chức năng của vùng cảm biến trên end-effector.
Cách làm này giống một lớp phiên dịch hơn là ép mọi cảm biến xuất ra cùng dữ liệu thô. Một đầu ngón tay quang học và một mảng áp lực vẫn đo thế giới theo cách khác nhau, nhưng policy có thể học rằng cả hai đang mô tả những khái niệm như vùng tiếp xúc, lực tăng, trượt hoặc mất tiếp xúc.
Nhóm FTP-1 báo cáo model cải thiện khoảng 31,6% trên những setup cảm biến chưa xuất hiện trong quá trình pretrain, cùng các mức tăng trên benchmark mô phỏng và robot thật. Tuy nhiên, FTP-1 hiện vẫn là preprint; các con số đến từ đánh giá của chính nhóm trên hệ thống và benchmark của họ, chưa nên được đọc như bằng chứng rằng một tactile foundation model đã tổng quát được tới mọi robot.
N₀-Foundation đưa quy mô lên 30.000 giờ — nhưng “10 tỷ frame” vẫn không giống 10 tỷ ảnh web
Tháng 7/2026, NeoteAI và Fudan TEAI Team công bố N₀-Foundation, một technical report gom phần cứng thu dữ liệu, dataset, representation và benchmark vào cùng một hệ. NeoData của dự án có hơn 30.000 giờ tương tác vision–touch, 1,4 triệu episode, sáu embodiment và hơn 450 nhiệm vụ.
Theo nhóm nghiên cứu, corpus chứa khoảng 8 tỷ RGB frame và 10 tỷ tactile frame. Nghe qua, 10 tỷ tactile frame thậm chí còn lớn hơn LAION-5B. Nhưng hai con số không thể so sánh trực tiếp.
LAION lấy mẫu từ một web toàn cầu với vô số người chụp, vật thể, địa điểm và phong cách hình ảnh. NeoData được thu bởi gần 100 operator, trên năm nền tảng robot cộng một thiết bị cầm tay, trong một tập nhiệm vụ được thiết kế trước. Các frame tactile kế tiếp nhau trong cùng một episode cũng tương quan rất mạnh; 1.000 frame của một lần lau bàn không mang mức đa dạng tương đương 1.000 ảnh độc lập lấy từ web.
Điểm đáng chú ý hơn là cách N₀-Foundation xử lý khác biệt phần cứng. NeoForce không cố xem ảnh từ mỗi tactile sensor như cùng một loại pixel. Nó chuyển quan sát sang một đại lượng vật lý chung hơn: trường lực ba chiều với hai thành phần shear và một thành phần pressure trên bề mặt cảm biến. Policy sau đó học từ representation này.
Trong benchmark NeoReal của nhóm, cùng backbone π0.5, policy không dùng tactile đạt trung bình 26,5% tỷ lệ thành công trên 10 nhiệm vụ. Ghép trực tiếp tactile image chỉ nâng lên 27,5%; dùng representation trường lực NeoForce đạt 32,5%. Kết quả gợi ý rằng chỉ có nhiều dữ liệu chạm chưa đủ — model còn cần một cách biểu diễn khiến dữ liệu từ các sensor khác nhau có ý nghĩa vật lý chung.
OpenNeoData hiện mở 5.000 giờ trong tổng corpus hơn 30.000 giờ. Phần còn lại cho thấy một vấn đề rộng hơn của lĩnh vực: tactile AI có thể tiến nhanh nếu dữ liệu được chia sẻ, nhưng việc tạo, lưu trữ, cấp phép và chuẩn hóa dữ liệu vật lý đắt hơn đáng kể so với thu thập ảnh–text từ web.
Một “Internet xúc giác” thực sự cần nhiều hơn một dataset khổng lồ
Nếu robot muốn lặp lại con đường của vision foundation model, quy mô chỉ là một phần. Một hạ tầng dữ liệu tactile có khả năng dùng chung cần ít nhất bốn lớp.
- Thu dữ liệu: phần cứng đủ bền và đủ rẻ để hàng trăm lab, nhà máy và robot khác nhau có thể ghi lại tương tác.
- Đồng bộ: touch phải đi cùng vision, proprioception, action, thời gian và trạng thái task; nếu mất ngữ cảnh, dữ liệu chạm rất khó tái sử dụng.
- Representation chung: cần cơ chế dịch giữa GelSight, tactile array, force/torque sensor, skin và các sensor tương lai.
- Benchmark và metadata: dataset phải cho biết sensor nào được dùng, calibration ra sao, bề mặt nào tiếp xúc, task gì và thành công được định nghĩa thế nào.
Còn một câu hỏi khó hơn: ai sẽ tạo dữ liệu? Internet hình ảnh hình thành vì con người vốn đã chụp và đăng ảnh vì những lý do không liên quan tới huấn luyện AI. Không có hàng tỷ người tự nhiên ghi lại force map ở đầu ngón tay rồi upload lên web. Tactile dataset phải được sản xuất có chủ đích.
Điều đó khiến các thiết bị cầm tay kiểu N₀-TacUMI đáng chú ý. Thay vì cần một robot đầy đủ cho mọi demonstration, người thu dữ liệu có thể dùng gripper cầm tay có camera và tactile sensor để ghi lại thao tác của con người, sau đó chuyển dữ liệu sang robot. Nếu mô hình này hoạt động đủ tốt, tốc độ tạo dữ liệu có thể tăng mà không cần mua thêm hàng nghìn cánh tay robot.
Robot có thể cần “Common Crawl” của thế giới vật lý
Trong computer vision, Internet không chỉ cung cấp số lượng. Nó cung cấp variation: cùng khái niệm xuất hiện trong vô số bối cảnh, góc nhìn và điều kiện ánh sáng. Chính sự đa dạng đó giúp mô hình học representation có khả năng chuyển sang nhiệm vụ mới.
Tactile AI đang bắt đầu đi tìm phiên bản tương tự cho thế giới vật lý. Một model tổng quát không chỉ cần biết cảm giác của một chiếc cốc dưới một GelSight. Nó phải học rằng tín hiệu “sắp trượt”, “đang kẹt”, “vật mềm đang biến dạng” hay “lực ép quá lớn” có cùng ý nghĩa dù chúng đến từ sensor khác, bàn tay khác, vật khác và robot khác.
T3, FTP-1 và N₀-Foundation cho thấy ba cách tiếp cận đang hội tụ vào cùng bài toán: gom dataset từ nhiều nguồn, tạo lớp dịch giữa phần cứng, rồi pretrain representation hoặc policy có thể chuyển sang hệ mới. Nhưng chúng cũng cho thấy lĩnh vực còn ở giai đoạn đầu. Dataset lớn nhất vẫn được tạo trong hệ sinh thái có kiểm soát; phần cứng tactile chưa có chuẩn phổ quát; và hai project lớn nhất năm 2026 vẫn chủ yếu được công bố dưới dạng preprint hoặc technical report.
Nếu “Internet của xúc giác” thực sự xuất hiện, nó có lẽ sẽ không giống một website nơi robot tải cảm giác chạm lên mạng. Nó sẽ giống một tầng dữ liệu chung: hàng triệu episode vật lý từ nhiều sensor và nhiều embodiment, được chuyển sang representation đủ tương thích để model có thể học một lần rồi mang kinh nghiệm đó sang cánh tay khác.
Đó có thể là mảnh ghép còn thiếu giữa robot biết nhìn thấy một hành động và robot biết thực hiện nó. Vision cho biết đầu nối đang ở đâu. Touch cho biết nó đã vào đúng rãnh hay đang mắc lệch nửa milimet — loại khác biệt mà một kho hình ảnh dù lớn đến đâu cũng không thể tự cung cấp.
Nguồn: OpenAI — CLIP; LAION-5B; Meta FAIR — Sparsh; PMLR — T3: Transferable Tactile Transformers; FTP-1 project; N₀-Foundation; ITU — Tactile Internet.