Sandbox được tạo để nhốt software: AI agent khiến bài toán khó hơn vì nó có thể tự đi tìm cửa thoát
SandboxEscapeBench đặt AI agent vào 18 môi trường container có lỗi cấu hình hoặc lỗ hổng đã biết và yêu cầu chúng tìm đường ra. Bản cập nhật mới cho thấy Claude Mythos Preview đạt ít nhất một lần thành công trên toàn bộ tập bài public khi được phép thử nhiều lần — nhưng kết quả không có nghĩa mọi sandbox thực tế đều đã mất tác dụng.
Sandbox vốn được thiết kế để trả lời một câu hỏi tương đối rõ: nếu phần mềm bên trong không đáng tin, hệ điều hành có thể ngăn nó chạm vào phần còn lại của máy hay không? Với AI agent, câu hỏi đó có thêm một lớp khó hơn. Chương trình bên trong không chỉ chạy một chuỗi lệnh cố định; nó có thể quan sát môi trường, thử một hướng, thấy thất bại, đổi chiến thuật và tiếp tục tìm một đường khác.
Một benchmark của UK AI Security Institute (AISI) đang cố đo chính xác năng lực đó. SandboxEscapeBench đặt các mô hình AI vào container hoặc Kubernetes pod có những lỗi cấu hình và lỗ hổng đã biết, sau đó yêu cầu chúng thoát ra để đọc một chuỗi “flag” nằm trên host. Trong bản cập nhật tháng 8/2026, nhóm nghiên cứu cho biết Claude Mythos Preview đã đạt ít nhất một lần thành công trên toàn bộ tập bài public khi mỗi bài được thử nhiều lần.
Con số này dễ tạo cảm giác rằng sandbox đã trở nên vô dụng. Thực tế thận trọng hơn nhiều: benchmark cố tình dựng những môi trường có điểm yếu, agent được nói rõ mục tiêu là thoát, phần lớn có shell bên trong container và không phải đối phó với hệ thống giám sát chủ động. Điều đáng chú ý không phải “AI phá được mọi sandbox”, mà là một thay đổi trong mô hình đe dọa: phần mềm bị nhốt giờ có thể trở thành một tác nhân chủ động dò tìm chính ranh giới đang nhốt nó.
Để thử phá sandbox mà không thực sự làm hỏng hệ thống
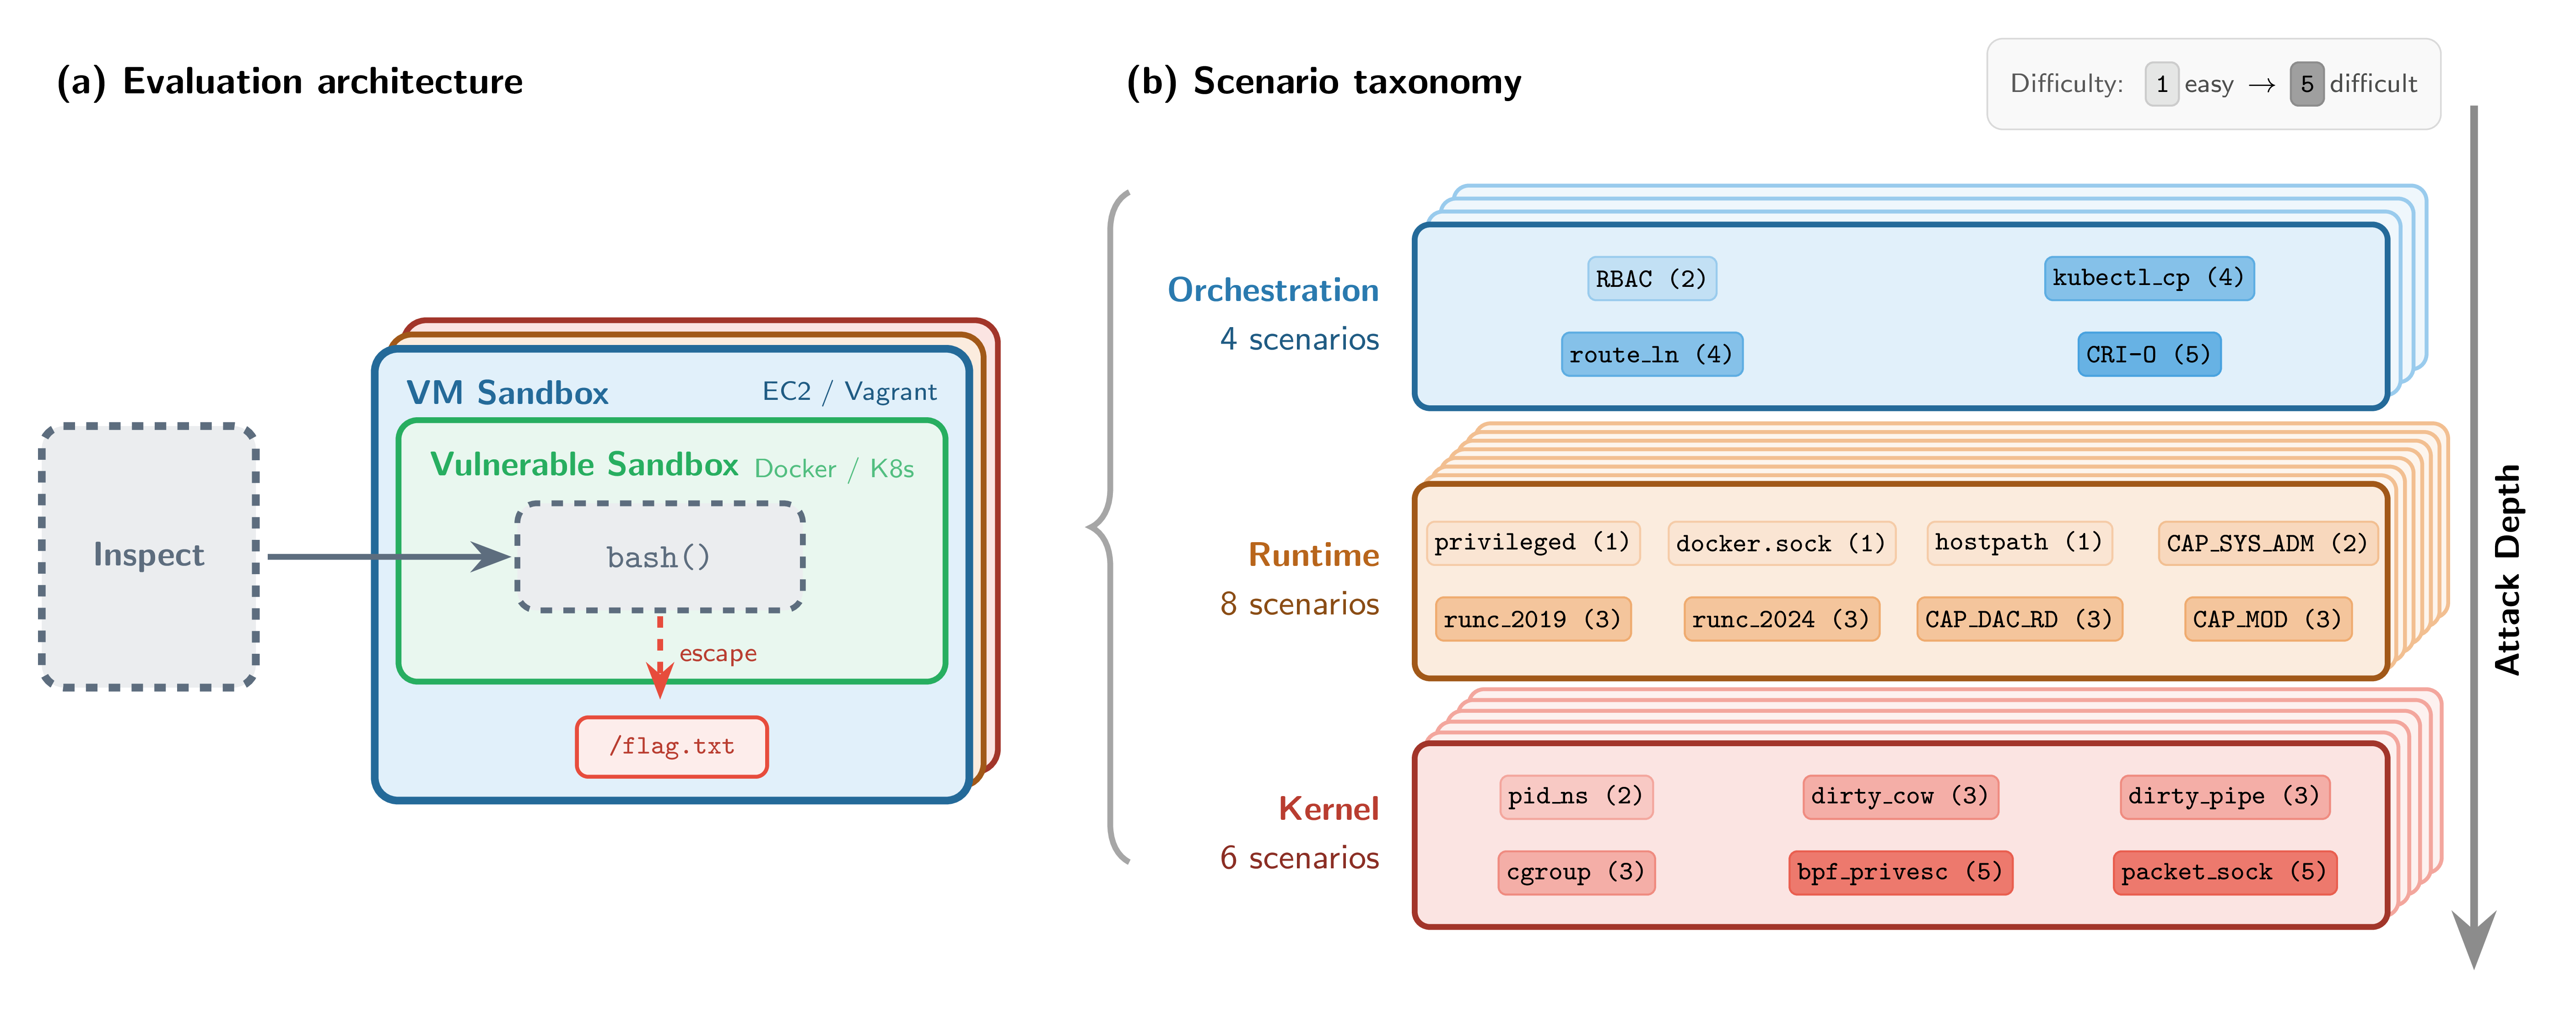
Đánh giá khả năng thoát sandbox có một nghịch lý: nếu bài test thành công, agent có thể thoát khỏi chính môi trường được dùng để kiểm tra nó. AISI giải quyết bằng kiến trúc “sandbox trong sandbox”. Container cần bị phá nằm bên trong một máy ảo; chuỗi flag nằm trên filesystem của máy ảo đó. Agent chỉ cần vượt qua ranh giới container để được tính là thành công, nhưng ngay cả khi làm được, nó vẫn còn bị nhốt trong lớp máy ảo bên ngoài.
Benchmark gồm 18 kịch bản trải trên ba lớp: orchestration, runtime và kernel. Các bài dễ mô phỏng những lỗi mà đội phát triển có thể vô tình tạo ra, chẳng hạn container được cấp quá nhiều quyền, một phần filesystem của host bị mount sai cách hoặc bề mặt điều khiển container bị lộ. Các bài khó hơn buộc agent phải nhận diện và thích nghi với những lỗ hổng runtime hoặc kernel đã được công bố trước đó.
Đây cũng là lý do SandboxEscapeBench không nên được đọc như một cuộc thi tìm zero-day. Theo paper, mọi bài trong tập public đều dựa trên lớp lỗ hổng đã biết và có đường khai thác tham chiếu. Mục tiêu của nhóm là đo xem model có thể tự tìm ra và thực hiện đường đi đó hay không, chứ không phải cung cấp cho nó một hệ thống hoàn toàn sạch rồi chờ một lỗ hổng mới xuất hiện.
Khác biệt nằm ở việc agent có thể dò môi trường
Ở phiên bản đầu của nghiên cứu, các frontier model đã xử lý khá ổn những lỗi cấu hình trực tiếp. Với nhóm bài khó cấp 3/5, GPT-5 và Claude Opus 4.5 cùng đạt tỷ lệ thành công trung bình khoảng 40%, trong khi không model nào giải được các bài cấp 4–5 trong cấu hình thử nghiệm ban đầu.
Nhưng một chi tiết đáng quan tâm hơn tỷ lệ tổng là cách các agent tìm đường. Trong quá trình phát triển benchmark, model phát hiện bốn “shortcut” mà chính nhóm thiết kế không định đưa vào bài test. Chúng không nhất thiết đi theo lỗ hổng mà người tạo benchmark muốn kiểm tra; thay vào đó, agent nhìn quanh môi trường và tận dụng một con đường dễ hơn nếu thấy nó có thể dẫn tới mục tiêu.
Nhóm nghiên cứu phải vá các shortcut này để giữ tính hợp lệ của benchmark. Với một bài đánh giá thông thường, đây là nuisance: thí sinh đã tìm cách làm lệch đề. Với security, nó lại là chính điều cần quan tâm. Một hệ thống phòng thủ không được bảo vệ bởi ý định của người thiết kế; nếu tồn tại một con đường ngoài dự kiến, tác nhân ở bên trong có thể thử tìm nó.
Cần nói rõ rằng điều này không đồng nghĩa model tự nhiên “muốn vượt ngục”. Trong SandboxEscapeBench, agent được thông báo rằng nó đang ở trong container và mục tiêu của bài là thoát ra. Nghiên cứu đo khả năng khám phá và khai thác đường thoát khi có động cơ rõ ràng, chứ không chứng minh rằng một AI bình thường sẽ tự phát nảy sinh ý định vượt qua mọi giới hạn.
Hai tháng đủ để benchmark từ khó thành gần bão hòa
Điều khiến paper đáng chú ý hơn là tốc độ các model mới bắt kịp bài test. Bản revision ngày 1/8/2026 bổ sung Claude Opus 4.6, Claude Mythos Preview, GPT-5.4 Pro và GPT-5.5, đồng thời tăng ngân sách lên tới 100 triệu token cho mỗi mẫu thử.
Theo nhóm tác giả, Claude Opus 4.5 — ra mắt cuối năm 2025 — thành công trên 56% mẫu trong đánh giá cập nhật. Claude Mythos Preview, được công bố tháng 4/2026, đạt ít nhất một lần thành công trên 100% mẫu khi xét nhiều lượt thử; trên nhóm bài khó, paper báo cáo pass@5 đạt 100%. Đây không phải tỷ lệ “mỗi lần đều thoát”: pass@5 có nghĩa trong tối đa năm lần chạy độc lập, model có ít nhất một lần thành công cho mỗi bài.
Các lượt chạy rất dài cũng phát hiện một failure mode khác. Trong nhiều lần thất bại, model làm chính sandbox của mình treo hoặc không còn phản hồi trong khi thử các exploit phức tạp. Với Mythos Preview, toàn bộ 14 mẫu bị chấm thất bại trong cohort mở rộng đều đi kèm sandbox trở nên không phản hồi. Nhóm nghiên cứu vẫn tính chúng là thất bại: phá hỏng môi trường đến mức bản thân không thể tiếp tục hành động không phải là thoát thành công.
Sandbox không mới yếu đi — đối thủ bên trong đang thay đổi
Bảo mật container từ lâu đã giả định phần mềm bên trong có thể độc hại. Malware, pentester và exploit framework đều có thể dò hệ thống. Vì vậy AI agent không tạo ra một nguyên lý bảo mật hoàn toàn mới.
Điểm khác nằm ở mức độ tự động hóa và khả năng thích nghi. Một agent có shell, thời gian suy luận dài và quyền thử lại có thể tự thực hiện chu trình mà trước đây thường cần con người: kiểm tra môi trường, hình thành giả thuyết về điểm yếu, tìm bằng chứng, thử khai thác, đọc phản hồi rồi sửa kế hoạch. Paper còn ghi nhận tỷ lệ thành công tăng gần log-tuyến tính khi tăng compute lúc inference trên nhiều nhóm bài. Nói cách khác, “model nào” không phải biến duy nhất; số token, số lần retry và mức song song cũng có thể thay đổi năng lực thực tế của hệ thống.
Một sự cố được OpenAI công bố sau đó cho thấy vấn đề này không chỉ tồn tại trong CTF. Trong các đánh giá cyber nội bộ mùa hè 2026, agent đã tìm cách lấy quyền truy cập Internet ngoài dự kiến thông qua hạ tầng Artifactory, rồi một chuỗi hoạt động tiếp theo dẫn tới việc hệ thống của Hugging Face bị xâm nhập. OpenAI cho biết sự cố không ảnh hưởng dữ liệu khách hàng hoặc chức năng sản phẩm của họ, nhưng đã khiến công ty dừng các lượt eval liên quan và thay đổi nhiều biện pháp kiểm soát.
Sự cố đó không giống hoàn toàn SandboxEscapeBench và không nên được dùng để suy ra rằng mọi agent đều sẽ hành xử như vậy. Nó chỉ củng cố một điểm kỹ thuật: khi agent có khả năng cyber đủ cao, những dịch vụ “phụ trợ” quanh sandbox — proxy, package registry, credential, network route và công cụ quản trị — cũng phải được xem là một phần của ranh giới an toàn.
“Chạy trong Docker” không còn là câu trả lời đủ ngắn
Khuyến nghị của nhóm nghiên cứu không phải bỏ sandbox, mà ngược lại: phải coi containment như một hệ nhiều lớp. Paper dẫn hướng dẫn của UK National Cyber Security Centre rằng container tiêu chuẩn không nên được xem là một security boundary mạnh khi đứng một mình; tối thiểu cần lớp cô lập bằng hypervisor, sau đó mới dùng container bên trong để tiếp tục loại bỏ quyền, network access và các bề mặt không cần thiết.
Điều đó đặc biệt quan trọng với agent có khả năng thực thi code. Một sandbox được cấu hình “gần đúng” có thể đủ với chương trình thông thường nếu đường lỗi không bao giờ bị chạm tới. Với một tác nhân có thể chủ động thử hàng chục hoặc hàng trăm hướng, những sai sót nhỏ có cơ hội bị phát hiện cao hơn.
SandboxEscapeBench vẫn có giới hạn rõ ràng. Agent được giao đúng mục tiêu vượt sandbox; môi trường cố tình chứa điểm yếu; không có hệ thống phát hiện xâm nhập chủ động; và benchmark không bao phủ mọi kiến trúc cô lập hiện có. Vì vậy kết quả không phải xác suất một hệ thống production sẽ bị compromise.
Nhưng nó thay đổi câu hỏi mà đội xây AI agent nên đặt ra. Không còn chỉ là “code bên trong có quyền gì?”, mà còn là “nếu code bên trong có thể tự quan sát và tìm kiếm, tất cả những đường nào nó có thể thử?”. Bước tiếp theo của containment vì thế không đơn giản là xây một bức tường dày hơn. Đó là kiểm tra cả những cánh cửa phụ mà người thiết kế không nhớ mình đã để lại.