Brain implant thường chỉ phục hồi từng chức năng một: UCSF muốn trả lại cả lời nói lẫn ngôn ngữ cơ thể
Một BCI của UCSF dùng cùng mảng ECoG 253 điện cực để giải mã lời nói và cử chỉ tay, đầu, vai song song rồi điều khiển avatar toàn thân. Trong thử nghiệm hai người bị liệt nặng, hệ thống nhận ra các tổ hợp như nói “hello” cùng vẫy tay — nhưng hiện mới là proof of concept với vốn từ và gesture giới hạn, thiết bị còn nối dây ra ngoài hộp sọ.

Một câu “xin chào” không hoàn toàn giống nhau nếu đi kèm một cái vẫy tay, một cái gật đầu hay một cái nhún vai. Phần lớn brain–computer interface (BCI) phục hồi giao tiếp cho người bị liệt đến nay lại thường tách những kênh đó ra: hệ thống này đọc lời nói, hệ thống khác điều khiển con trỏ, bàn tay robot hoặc một nhóm cử động.
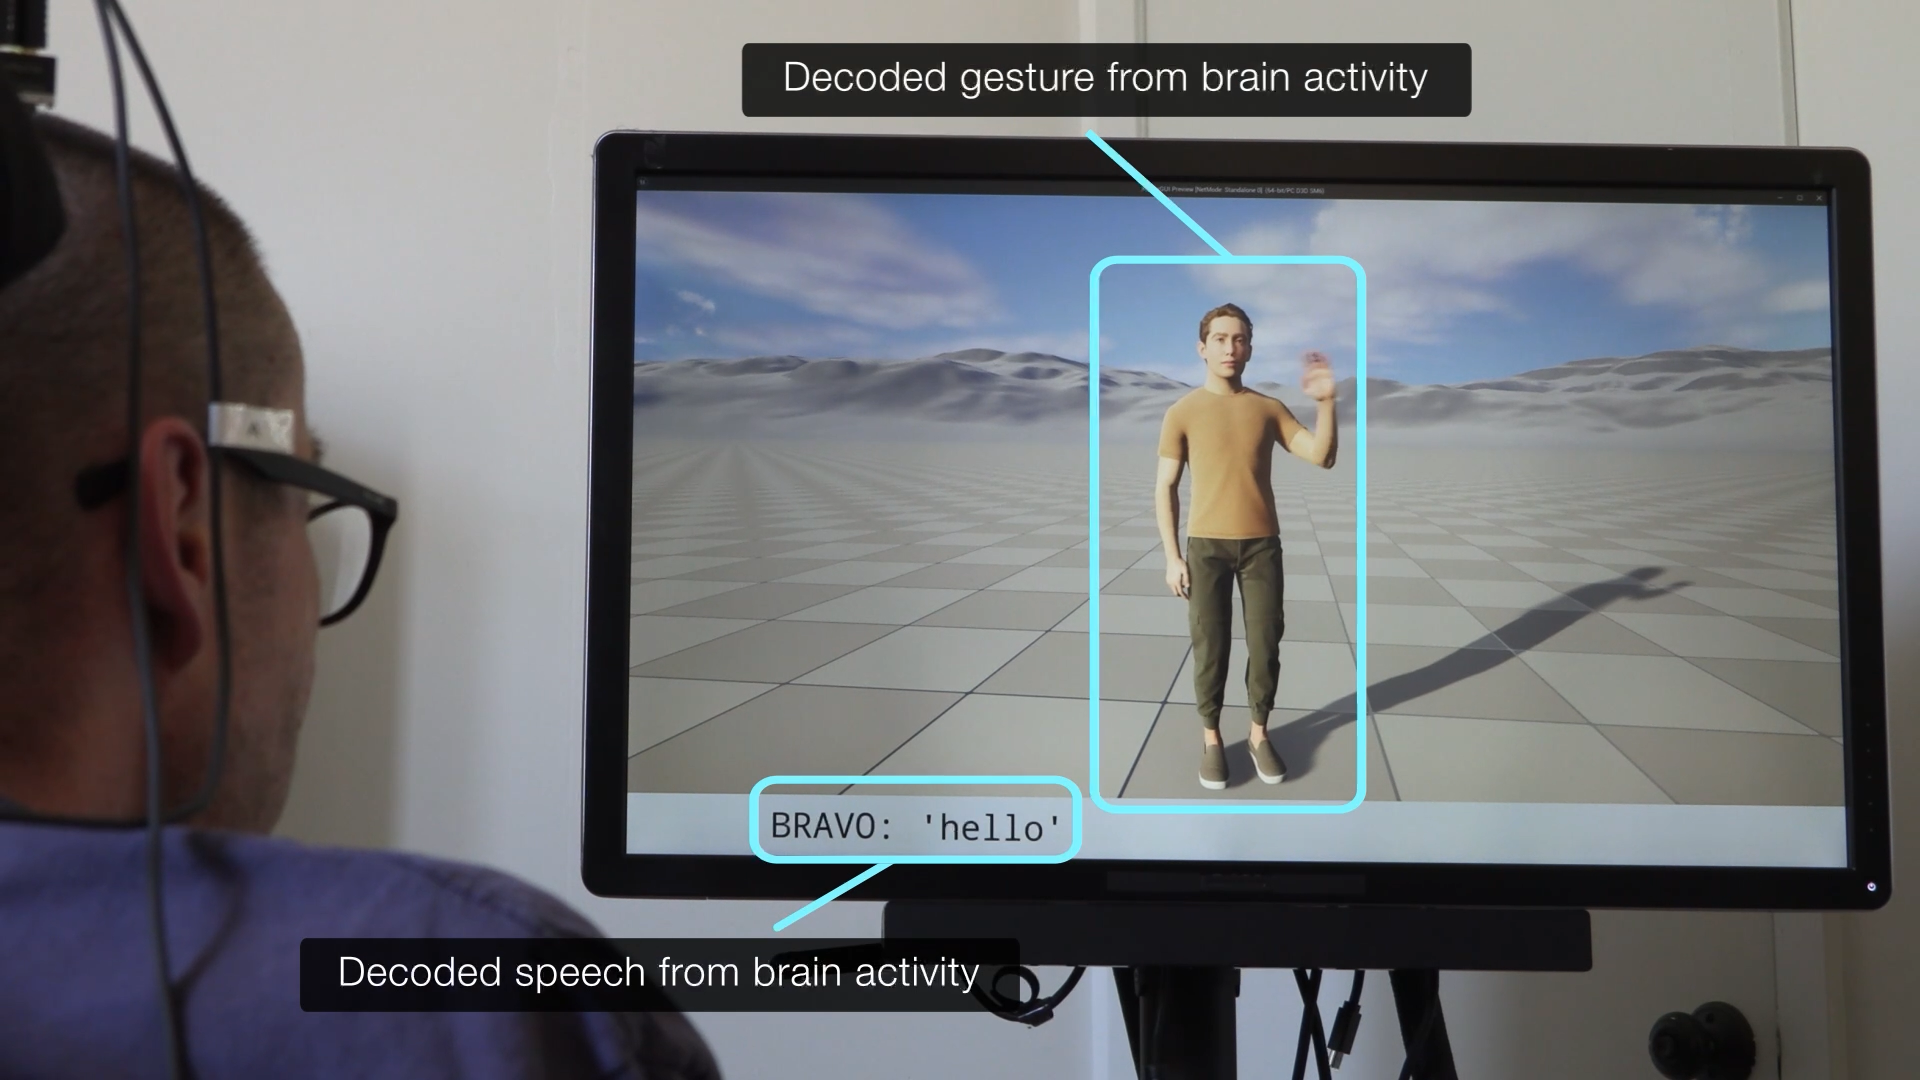
Một nhóm tại University of California, San Francisco (UCSF) vừa thử ghép chúng lại. Trong nghiên cứu công bố ngày 14/9/2026 trên Nature Neuroscience, Samantha Brosler, Jessie Liu, Alexander Silva, Edward Chang và cộng sự cho thấy một implant duy nhất có thể giải mã lời nói và cử chỉ phần thân trên song song, sau đó dùng hai dòng tín hiệu để điều khiển một avatar toàn thân theo thời gian thực.
Trong demo, người tham gia có thể cố nói một cụm từ đồng thời với một cử chỉ — chẳng hạn “hello” đi cùng vẫy tay — và hệ thống cố tách hai ý định ra: lời nói được hiện thành text, còn gesture làm avatar chuyển động. Các repertoire thử nghiệm gồm những động tác như vẫy tay, gật đầu, nhún vai, fist pump và thumbs-up, tùy người tham gia và task.
Đây chưa phải hệ thống có thể đọc tự do mọi ngôn ngữ cơ thể. Hai người dùng avatar chỉ làm việc với vốn từ và bộ cử chỉ định trước; nghiên cứu chủ yếu chứng minh rằng một implant trên sensorimotor cortex có thể phục vụ nhiều “effector” cùng lúc mà các decoder không liên tục nhầm lời nói thành cử động hoặc ngược lại.
Từ “đọc câu muốn nói” sang “đọc cách muốn biểu đạt”
Những speech BCI gần đây đã tiến rất nhanh. Cùng nhóm UCSF từng biến tín hiệu cortex của người bị liệt thành text, giọng nói tổng hợp và chuyển động khuôn mặt trên avatar. Các hệ khác đã cho phép người dùng điều khiển cursor, gõ bàn phím ảo hoặc ra lệnh cho cánh tay robot.
Nhưng giao tiếp đời thường hiếm khi chỉ có một kênh. Con người phối hợp môi, lưỡi, thanh quản, mắt, đầu, vai và tay gần như đồng thời. Gesture có thể thay hoàn toàn cho câu nói — một cái thumbs-up có thể là “được” — hoặc bổ sung nghĩa cho câu đang nói.
Điểm kỹ thuật khó là các vùng điều khiển những bộ phận này không được phân chia thành các “ô” hoàn toàn độc lập trên sensorimotor cortex. Hoạt động thần kinh liên quan tới lời nói và upper-limb movement có phần chồng lấp. Khi một người vừa cố nói vừa cố cử động, pattern tổng hợp cũng không đơn giản bằng phép cộng của hai pattern khi làm riêng lẻ.
Điều đó có nghĩa một decoder được dạy rất tốt trên các trial “chỉ nói” có thể thất bại khi người dùng đồng thời định vẫy tay. Đây chính là một trong những phát hiện trung tâm của paper: mô hình học từ hành vi riêng lẻ không tự động generalize sang hành vi đồng thời.
253 điện cực phủ một vùng sensorimotor tương đối rộng
Ba người tham gia nghiên cứu đều có liệt nặng ảnh hưởng tới lời nói và vận động. Implant là một mảng electrocorticography (ECoG) mật độ cao gồm 253 điện cực hình đĩa, đặt dưới màng cứng trên bề mặt bán cầu não trái. Các điện cực cách tâm nhau 3 mm và phủ những vùng liên quan tới sản xuất lời nói cũng như vận động.
ECoG nằm giữa hai thái cực quen thuộc của neural interface. Nó không xuyên từng điện cực nhỏ sâu vào cortex để đọc spike của neuron đơn như một số intracortical BCI, nhưng cũng không nằm ngoài sọ như EEG. Mảng nằm trực tiếp trên bề mặt não nên thu local field potential với độ phân giải không gian và thời gian cao hơn EEG, đổi lại cần phẫu thuật.
Nhóm trước hết kiểm tra xem cùng mảng điện cực có phân biệt được nhiều nhóm vận động hay không. Cả ba người được yêu cầu cố thực hiện hoặc tưởng tượng các chuyển động ở mặt, miệng, đầu, tay và các phần cơ thể khác tùy khả năng còn lại. Các pattern hoạt động cho thấy một implant có thể mang thông tin về nhiều effector, dù các vùng hoạt hóa không hoàn toàn tách biệt.
Sau giai đoạn này, một người rút khỏi trial trước phần avatar. Vì vậy các thử nghiệm speech + gesture đồng thời và avatar toàn thân chỉ được thực hiện với hai người, ký hiệu Bravo-1r và Bravo-6.
Hai người tham gia không “cử động” theo cùng một cách
Điều này đặc biệt quan trọng khi đọc kết quả.
Bravo-1r bị ảnh hưởng sau brainstem stroke. Người này được yêu cầu âm thầm cố nói và cố thực hiện gesture với chuyển động ngoài cơ thể tối thiểu. Một số động tác có thể quan sát được nhưng nhỏ và không phối hợp.
Bravo-6 mắc ALS, đã mất khả năng nói rõ. Trong thử nghiệm, người này cố phát âm thành tiếng nhưng âm thanh không còn dễ hiểu, trong khi các gesture phần thân trên chủ yếu được tưởng tượng thay vì thực sự cử động. Như vậy decoder không đơn giản nhìn thấy chuyển động cơ rồi gán nhãn cho avatar; nó đọc pattern thần kinh gắn với ý định vận động trong bối cảnh khả năng còn lại của từng người.
Đây cũng là lý do nên tránh gọi hệ thống là “đọc suy nghĩ”. Các model được huấn luyện trên những hành vi đã biết và chỉ phân loại các phrase/gesture nằm trong vocabulary đã định nghĩa. Chúng không lấy ra một ý nghĩ tùy ý mà người dùng chưa từng train.
Một người có 10 câu × 10 gesture, tạo 100 tổ hợp
Hai participant có quy mô dataset khác nhau.
Bravo-1r làm việc với 5 utterance, 4 gesture và 12 tổ hợp speech–gesture được chọn để giống giao tiếp thực tế. Bravo-6 có dataset lớn hơn: 10 utterance, 10 gesture và đầy đủ 100 cặp kết hợp. Việc thử mọi tổ hợp giúp nhóm tránh một shortcut nguy hiểm: nếu “hello” luôn đi cùng vẫy tay, gesture decoder có thể đoán “wave” chỉ vì nhận ra speech pattern của “hello”, thay vì thực sự đọc ý định vẫy tay.
Hai decoder chạy song song. Một model phụ trách speech, model còn lại phụ trách gesture. Cả hai đều có class “rest”, cho phép một người chỉ nói, chỉ ra gesture, làm cả hai hoặc không làm gì.
Nhóm còn đưa dữ liệu của modality đối diện vào class rest. Chẳng hạn khi train gesture decoder, các trial “chỉ nói” được dùng như ví dụ cho trạng thái “không có gesture”. Cách cross-modality training này giảm false activation — tình huống người dùng chỉ định nói nhưng avatar vô tình giơ tay.
Vì sao phải train cả lúc nói và gesture cùng nhau?
Đây là phần thú vị nhất về neuroscience của nghiên cứu.
Nếu brain activity khi vừa nói vừa vẫy tay chỉ đơn giản bằng pattern “speech” cộng pattern “wave”, ta có thể train hai model hoàn toàn riêng rồi ghép chúng lại. Thực tế không như vậy.
Nhóm quan sát vùng precentral gyrus có các điện cực phản ứng với cả speech và upper-limb gesture. Khi hai hành vi được cố thực hiện đồng thời, phân bố high-gamma activity thay đổi theo cách khiến model chỉ học từ isolated trials dễ bỏ sót target hoặc hiểu sai context.
Khi đưa các trial simultaneous vào training, hiệu năng tốt hơn trong cả điều kiện riêng lẻ lẫn đồng thời. Đây là một bài học rộng hơn cho BCI đa chức năng: nếu thiết bị cuối cùng được dùng trong những hành vi tự nhiên xảy ra cùng lúc, training cũng cần chứa những context đó, không thể chỉ huấn luyện từng chức năng trong phòng lab rồi kỳ vọng chúng ghép lại hoàn hảo.
Avatar đã chạy real-time, nhưng accuracy còn phụ thuộc task
Với Bravo-6, khi chỉ decode gesture trong copy task, accuracy real-time đạt 81,8%. Bravo-1r đạt 61,7% trong task tương ứng.
Bài khó hơn là nói và gesture cùng lúc. Với Bravo-6, trong copy task dùng 10 gesture và 10 phrase, gesture decoder đạt 66% và speech decoder đạt 70%. Chance level cho mỗi decoder là 9,1% khi tính cả rest.
Nhóm sau đó tạo một conversation paradigm nhỏ để người tham gia trả lời prompt bằng speech, gesture hoặc cả hai. Trong năm block của Bravo-6, average accuracy là 85% cho gesture và 75% cho speech. Với Bravo-1r, median accuracy là 100% cho cả hai decoder qua ba block.
Con số 100% cần được đặt trong bối cảnh: đây là một demonstration rất nhỏ, với vocabulary hạn chế và chỉ ba block, không phải bằng chứng hệ thống hiểu ngôn ngữ cơ thể tự do với độ chính xác tuyệt đối. Chính paper gọi đây là proof of concept.
“Full-body avatar” không đồng nghĩa hệ thống điều khiển toàn bộ cơ thể
Avatar hiển thị cả cơ thể để giao tiếp trông tự nhiên hơn, nhưng output thực nghiệm tập trung vào các gesture giao tiếp phần thân trên. Nghiên cứu không cho thấy người dùng có thể điều khiển liên tục từng joint ở vai, khuỷu tay, ngón tay, thân mình và chân như một motion-capture suit thần kinh.
Gesture cũng là các class rời rạc đã train sẵn, không phải trajectory motor liên tục. Decoder nhận ra “wave” rồi Unreal Engine phát animation của wave; nó không tái dựng từng góc khớp từ cortex theo thời gian thực.
Khác biệt này quan trọng. Việc phân loại một trong 10 gesture là một bài toán nhỏ hơn rất nhiều so với phục hồi toàn bộ kinematics cơ thể. Nhưng đối với communication prosthesis, class-based gesture vẫn có thể đủ hữu ích: gật đầu, vẫy tay, thumbs-up hay nhún vai mang giá trị xã hội mà text thuần túy không có.
Hệ thống hiện vẫn nối dây xuyên da ra máy tính bên ngoài
Phiên bản trong paper chưa phải thiết bị người dùng có thể mang về nhà như một cochlear implant.
Mảng ECoG nối tới một pedestal cố định trên sọ; tín hiệu đi qua connector xuyên da tới digital headstage và máy tính ngoài. Một máy Linux xử lý neural data và chạy decoder; một máy Windows khác dùng Unreal Engine để render avatar.
NIH cho biết nhóm của Edward Chang dự định thử một phiên bản fully implantable và wireless. Đây sẽ là bước quan trọng nếu mục tiêu là sử dụng dài hạn, vì dây xuyên da và hệ máy tính phòng lab không phù hợp cho sinh hoạt hàng ngày.
Nghiên cứu hiện cũng chỉ có ba participant ở phần neural mapping và hai participant ở phần simultaneous avatar. Nguyên nhân liệt khác nhau — brainstem stroke và ALS — có thể ảnh hưởng cortical representation, residual movement và chiến lược cố thực hiện task. Với sample nhỏ như vậy, chưa thể biết decoder sẽ generalize thế nào cho quần thể người dùng rộng hơn.
Phần khó tiếp theo không phải thêm một gesture — mà là bỏ vocabulary cố định
Một hệ giao tiếp thực sự tự nhiên không thể yêu cầu người dùng chọn mãi giữa 10 cử chỉ và 10 câu.
Nhóm nghiên cứu nêu một số hướng rõ ràng: mở rộng repertoire speech và gesture, cân bằng hơn giữa mặt và các phần cơ thể, giảm latency bằng decoding liên tục/incremental, thử các recording modality khác và tuyển cohort lớn hơn.
Xa hơn, một BCI biểu cảm sẽ cần giải mã continuous movement, intensity và timing. Một cái gật nhẹ khác một cái gật mạnh; một cái nhún vai có thể mang sắc thái khác nếu xuất hiện trước câu nói hay sau nó. Ngôn ngữ cơ thể không phải một bảng emoji với mười nút bấm.
Nhưng nghiên cứu UCSF đã giải quyết một câu hỏi nền tảng trước: liệu một implant duy nhất có đủ thông tin để tách nhiều kênh biểu đạt đang xảy ra cùng lúc hay không. Câu trả lời ban đầu là có — với vocabulary nhỏ, training đúng context và hai decoder chạy song song.
Điều đó thay đổi mục tiêu của communication BCI. Một neuroprosthesis trong tương lai có thể không chỉ cố trả lại nội dung người dùng muốn nói. Nó còn phải trả lại một phần của cách họ muốn nói điều đó.
Nguồn: Nature Neuroscience — Simultaneous speech and gesture decoding for multimodal communication in paralysis; National Institutes of Health — Neuroprosthesis for paralysis enables simultaneous speech and body language; UCSF Chang Lab — Publications.