Camera hiện gửi ánh sáng cho processor xử lý: Sensor mới bắt đầu “suy nghĩ” ngay bên trong từng pixel
Một photodetector MoS₂ mới không chỉ biến ánh sáng thành dòng điện: microcavity quanh mỗi pixel khiến nó tự thực hiện phép “nhân trọng số”, còn động học hạt tải tích lũy kết quả theo thời gian. Prototype đạt 99,6% trên MNIST và 94,8% trên CIFAR-10, nhưng phần trích xuất đặc trưng vẫn chạy bằng mạng điện tử bên ngoài và hệ hiện mới gồm 10 photodetector cho lớp phân loại cuối.

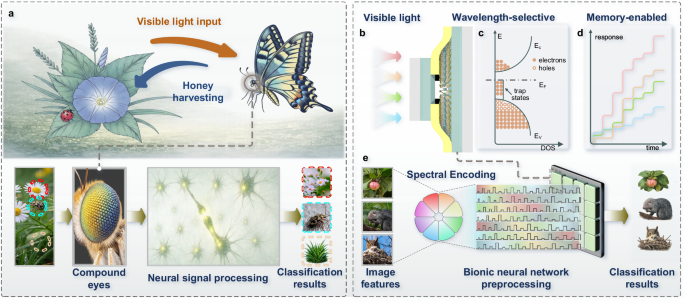
Một camera thông thường chia công việc khá rõ. Pixel nhận photon và biến chúng thành tín hiệu điện; mạch đọc số hóa tín hiệu; sau đó processor, GPU hoặc accelerator mới bắt đầu các phép toán để tìm cạnh, nhận vật thể hay chạy neural network. Phần lớn dữ liệu phải rời khỏi sensor trước khi nó trở thành thứ máy có thể “hiểu”.
Một nhóm tại Nanjing University và các tổ chức cộng tác đang thử làm mờ ranh giới đó. Trong nghiên cứu công bố trên Nature Communications tháng 7/2026, họ chế tạo photodetector MoS2 mà chính phản ứng quang học và động học điện tích của từng pixel được dùng để thực hiện hai thao tác cốt lõi của neural network: gán trọng số và cộng tích lũy.
Nói “pixel suy nghĩ” là một cách ví von. Thiết bị không chạy một model ngôn ngữ hay toàn bộ computer vision stack bên trong từng điểm ảnh. Nhưng nó làm được điều mà pixel camera cổ điển không làm: ánh sáng đi vào không chỉ được đo, mà còn được tính toán ngay trong quá trình đo.
Trong prototype, hệ thống đạt accuracy 99,6% trên MNIST, 94,8% trên CIFAR-10 và 94,0% trên Free Spoken Digit Dataset. Những con số này đáng chú ý, nhưng cần đọc cùng kiến trúc thực tế: một electronic CNN vẫn đảm nhiệm phần feature extraction; mảng photodetector quang học chỉ thực hiện lớp fully connected cuối cùng của classifier. Đây là proof-of-concept cho một computational primitive ở sensor, chưa phải camera AI hoàn chỉnh.
Điểm nghẽn không chỉ nằm ở phép tính, mà ở việc phải di chuyển dữ liệu
Camera độ phân giải cao tạo ra lượng dữ liệu lớn ngay cả trước khi một neural network bắt đầu làm việc. Với kiến trúc thông thường, điện tích từ pixel được đọc ra, chuyển qua analog-to-digital converter, ghi vào memory rồi tiếp tục di chuyển giữa memory và compute unit. Trong nhiều hệ edge — robot, drone, wearable hay camera luôn bật — bản thân việc vận chuyển dữ liệu có thể tiêu tốn năng lượng và tạo latency đáng kể.
Đây là lý do in-sensor computing đang được nghiên cứu như một nhánh riêng của edge AI. Thay vì coi sensor là phần tử thụ động chỉ chụp ảnh, kỹ sư cố đưa một phần preprocessing hoặc neural computation vào chính vật liệu và mạch cảm biến.
Cách tiếp cận này có nét giống võng mạc sinh học hơn camera truyền thống. Retina không gửi toàn bộ giá trị ánh sáng của từng photoreceptor lên não như một ma trận pixel thô; nhiều lớp tế bào đã thực hiện lọc, tích hợp và mã hóa ngay trước khi tín hiệu rời mắt. Mục tiêu của in-sensor computing không phải sao chép sinh học từng chi tiết, mà khai thác cùng nguyên tắc: xử lý thông tin càng gần nơi nó được sinh ra càng tốt.
Mỗi pixel được đặt trong một “hộp cộng hưởng” quang học
Thiết bị của nhóm nghiên cứu dùng molybdenum disulfide, hay MoS2, một semiconductor hai chiều. Lớp MoS2 được đặt trong một Fabry–Pérot microcavity hình thành giữa hai lớp bạc đóng vai trò gương quang học.
Microcavity này khiến photodetector không phản ứng giống nhau với mọi màu ánh sáng. Tùy kích thước cavity, một số bước sóng cộng hưởng mạnh hơn và tạo photocurrent lớn hơn. Nhóm nghiên cứu khai thác chính đường cong spectral responsivity này như một tập trọng số analog.
Có thể hình dung mỗi pixel sở hữu một “núm gain” khác nhau cho từng bước sóng. Khi một feature được mã hóa thành cường độ ánh sáng và một weight được mã hóa bằng việc chọn bước sóng phù hợp, photocurrent sinh ra tỷ lệ với tích giữa hai đại lượng. Thay vì CPU đọc hai con số rồi thực hiện phép nhân, phép nhân xuất hiện như một hệ quả vật lý của quá trình ánh sáng được chuyển thành điện.
Trong thiết bị, Ag phía dưới đồng thời là back-gate và gương dưới; HfO2 vừa là dielectric vừa định nghĩa khoảng cách cavity; lớp MoS2 tạo kênh photodetector, còn một lớp Ag mỏng phía trên hoàn tất microcavity. Các phép đo trên 12 thiết bị cho thấy cộng hưởng tập trung quanh 625 nm với full width at half maximum khoảng 25 nm, một dấu hiệu cho thấy fabrication giữa các device tương đối đồng đều.
Pixel còn “nhớ” ánh sáng vừa đi qua
Phần thứ hai của phép tính đến từ một đặc tính thường bị xem là phi lý tưởng ở photodetector: hạt tải không biến mất tức thì sau khi ánh sáng tắt. Các trap state trong MoS2 giữ lại ảnh hưởng của những pulse trước trong một khoảng thời gian.
Nhóm biến hiệu ứng đó thành memory analog ngắn hạn. Một chuỗi pulse quang học được gửi vào pixel theo thời gian; phản ứng với pulse mới chồng lên phần photocurrent còn lại từ pulse trước. Đến cuối chuỗi, giá trị dòng điện đã tích lũy gần tương đương một multiply–accumulate (MAC) — phép nhân rồi cộng dồn, cũng là thao tác xuất hiện khắp neural network.
Thiết bị có rise time khoảng 9,87 ms và fall time khoảng 14,12 ms trong điều kiện đo cộng hưởng. Khoảng thời gian này đủ nhanh cho thí nghiệm time-multiplexing của nhóm, nhưng cũng đủ chậm để phản ứng từ nhiều pulse liên tiếp chồng lên nhau và tạo tích lũy.
Điểm hay của kiến trúc là memory không phải một SRAM riêng nằm cạnh sensor. Nó nằm trong chính động học vật lý của photodetector.
Weight được mã hóa bằng màu, input được mã hóa bằng độ sáng
Trong thí nghiệm classifier, nhóm dùng nguồn supercontinuum kết hợp bộ lọc quang có thể chọn bước sóng. Mỗi feature được biến thành một pulse; biên độ pulse mang giá trị feature, còn bước sóng được chọn sao cho responsivity của pixel tương ứng với weight mà neural network đã học.
Vì vậy, hai toán hạng của phép MAC nằm ở hai chiều vật lý khác nhau. Input nằm trong intensity; weight nằm trong wavelength. Photodetector thực hiện phép nhân khi chuyển ánh sáng thành photocurrent, rồi carrier lifetime thực hiện phép cộng dồn theo thời gian.
Mười photodetector trong classifier tương ứng với 10 class đầu ra. Sau khi toàn bộ feature vector được phát dưới dạng chuỗi pulse, pixel có photocurrent tích lũy lớn nhất trở thành class dự đoán.
Đây cũng là lý do paper gọi hệ thống là wavelength-encoded neuromorphic inference. Neural weight không được lưu như một số nhị phân trong RAM; nó được ánh xạ vào đáp ứng phổ của phần cứng.
99,6% accuracy không có nghĩa sensor tự nhận dạng ảnh từ photon tới nhãn
Đây là giới hạn cần giữ rõ nhất khi đọc kết quả. Ảnh MNIST hay CIFAR-10 không được chiếu nguyên bản thẳng vào một mảng hàng triệu pixel rồi để sensor tự làm toàn bộ inference.
Trong setup của paper, dữ liệu đầu vào trước hết chạy qua một electronic feature-extraction backbone — một CNN nhỏ tạo vector 512 chiều. Vector đó mới được chuyển thành chuỗi pulse quang học để mảng MoS2 thực hiện lớp classification cuối.
Do đó, accuracy 99,6% trên MNIST, 94,8% trên CIFAR-10 và 94,0% trên FSDD chứng minh rằng phần fully connected có thể được ánh xạ sang hardware quang–điện với độ trung thực cao so với reference model. Nó chưa chứng minh một image sensor hoàn chỉnh có thể thay GPU cho toàn bộ network.
Cấu hình hiện tại cũng dùng chỉ 10 photodetector đầu ra, phù hợp với ba benchmark đều có 10 class. Để trở thành một camera thực tế, kiến trúc phải scale lên array lớn hơn rất nhiều, tích hợp nguồn hoặc modulation quang học gọn hơn và xử lý được các layer sâu hơn mà không cần một chuỗi thiết bị phòng lab bao quanh.
Hardware analog có một vấn đề quen thuộc: hai pixel hiếm khi giống hệt nhau
Neural network số có lợi thế là weight 0,5 trên chip này về nguyên tắc vẫn là 0,5 trên chip khác. Weight vật lý được mã hóa qua optical responsivity thì phụ thuộc vào fabrication, coupling và trạng thái device.
Paper cho thấy calibration vì thế rất quan trọng. Trên Free Spoken Digit Dataset, cùng mảng 10 photodetector chỉ đạt 76,4% nếu bỏ pixel-wise calibration; khi dùng đường cong responsivity đo riêng của từng pixel để hiệu chỉnh, accuracy tăng trở lại 94,0%.
Một control array MoS2 không có microcavity chỉ đạt 16,4% trong thử nghiệm tương ứng, củng cố rằng wavelength-selective resonance thực sự đang làm việc như cơ chế weight chứ không chỉ là một hiệu ứng trang trí.
Nhưng kết quả cũng cho thấy thách thức của analog AI hardware: nếu hàng triệu pixel đều cần characterization riêng và calibration thường xuyên, lợi ích năng lượng hoặc diện tích ở cấp device có thể bị bù lại bởi complexity ở cấp hệ thống.
“In-sensor” hiện vẫn cần một bàn quang học khá lớn
Một nghịch lý của nhiều nghiên cứu in-sensor computing là phần tử cảm biến rất nhỏ nhưng hệ demo xung quanh lại lớn. Setup hiện tại dùng supercontinuum laser, acousto-optic tunable filter, beam splitter, optical spectrum analyzer và hệ căn chỉnh quang học.
Các tác giả cũng thừa nhận latency hiện tại chủ yếu bị giới hạn bởi hệ supercontinuum–AOTF trong phòng lab, không phải bản thân cơ chế photodetection. Họ đề xuất nguồn tunable tốc độ cao hoặc integrated modulator nhỏ gọn hơn cho các phiên bản sau.
Một giới hạn khác là weight của classifier trong kiến trúc hiện tại bị ràng buộc không âm, vì responsivity quang học tự nhiên không biểu diễn trực tiếp weight âm. Nhóm phải huấn luyện lớp cuối với non-negative weight constraint và không dùng bias. Những giới hạn như vậy không làm proof-of-concept mất giá trị, nhưng chúng cho thấy một neural layer vật lý không linh hoạt giống matrix multiplication số.
Camera tương lai có thể không cần “nhìn thấy” mọi thứ như con người
Nếu in-sensor computing trưởng thành, ứng dụng hấp dẫn nhất có thể không phải smartphone chụp ảnh đẹp hơn. Nó phù hợp hơn với những máy cần quan sát liên tục nhưng chỉ quan tâm một số tín hiệu: robot phát hiện vật cản, drone theo dõi chuyển động, wearable nhận gesture, camera công nghiệp tìm defect hoặc sensor luôn bật chờ một sự kiện hiếm.
Trong các hệ đó, việc đọc và số hóa mọi pixel ở full fidelity chỉ để processor sau đó bỏ đi phần lớn thông tin là một thiết kế tốn kém. Sensor có khả năng lọc, weight hoặc tích lũy ngay từ đầu có thể giảm dữ liệu phải di chuyển tới các stage sau.
Nhưng paper 2026 này chưa chứng minh một camera như vậy. Nó chứng minh một điều hẹp hơn và có lẽ quan trọng hơn về mặt phần cứng: photodetector có thể vừa cảm nhận vừa thực hiện một primitive của neural computation bằng chính vật lý của nó.
Bước tiếp theo sẽ là đưa ý tưởng từ một mảng 10 output trên bàn quang học sang array lớn, tích hợp và có thể sản xuất ổn định; đồng thời chứng minh rằng tổng hệ thống — sensor, nguồn sáng, calibration, ADC và phần compute còn lại — thực sự dùng ít năng lượng hoặc có latency thấp hơn CMOS camera cộng accelerator hiện nay. Khi đó, “pixel biết tính toán” mới chuyển từ một thí nghiệm vật liệu sang một kiến trúc camera mới.
Nguồn
- Xiang Chen và cộng sự, “Wavelength-encoded neuromorphic inference enabled by microcavity MoS2 photodetector arrays”, Nature Communications, 2026.
- “Edge intelligence through in-sensor and near-sensor computing for the Internet of Things”, Nature Reviews Electrical Engineering, 2025.
- Lukas Mennel và cộng sự, “Ultrafast machine vision with 2D material neural network image sensors”, Nature, 2020.