Chip AI không chỉ gặp giới hạn tính toán: Cuộc chiến tiếp theo là đưa cả nghìn ampere tới vài centimet silicon
AI accelerator ngày càng tiêu thụ hơn 1 kW nhưng lõi logic vẫn hoạt động quanh mức điện áp dưới 1 V, đẩy dòng cấp nguồn lên hàng trăm tới khoảng 1.000 A. Infineon vừa giới thiệu power stage 6 × 6 mm hỗ trợ 300 A đỉnh, trong khi ngành chip đang chuyển từ cấp điện bên cạnh sang cấp điện theo phương thẳng đứng và thậm chí từ mặt sau của wafer.

Chip AI thường được nói đến bằng số transistor, FLOPS hay băng thông HBM. Nhưng khi một accelerator vượt ngưỡng công suất 1 kW, một bài toán ít hào nhoáng hơn bắt đầu quyết định thiết kế: làm thế nào đưa một dòng điện khổng lồ từ bo mạch vào lõi silicon chỉ rộng vài centimet mà không biến chính đường cấp nguồn thành điện trở sưởi.
Điểm nghịch lý nằm ở điện áp. Các lõi xử lý tiên tiến không chạy ở hàng chục volt mà thường quanh mức dưới 1 V. Với cùng một công suất, điện áp càng thấp thì dòng điện càng phải tăng. Một rail 800 W ở 0,8 V về lý tưởng đã tương ứng khoảng 1.000 A. Vì vậy, thế hệ AI accelerator hiện nay không chỉ cần nguồn “mạnh hơn”; chúng cần một mạng phân phối điện có điện trở cực thấp, phản ứng đủ nhanh trước các bước nhảy tải và nằm càng gần processor càng tốt.
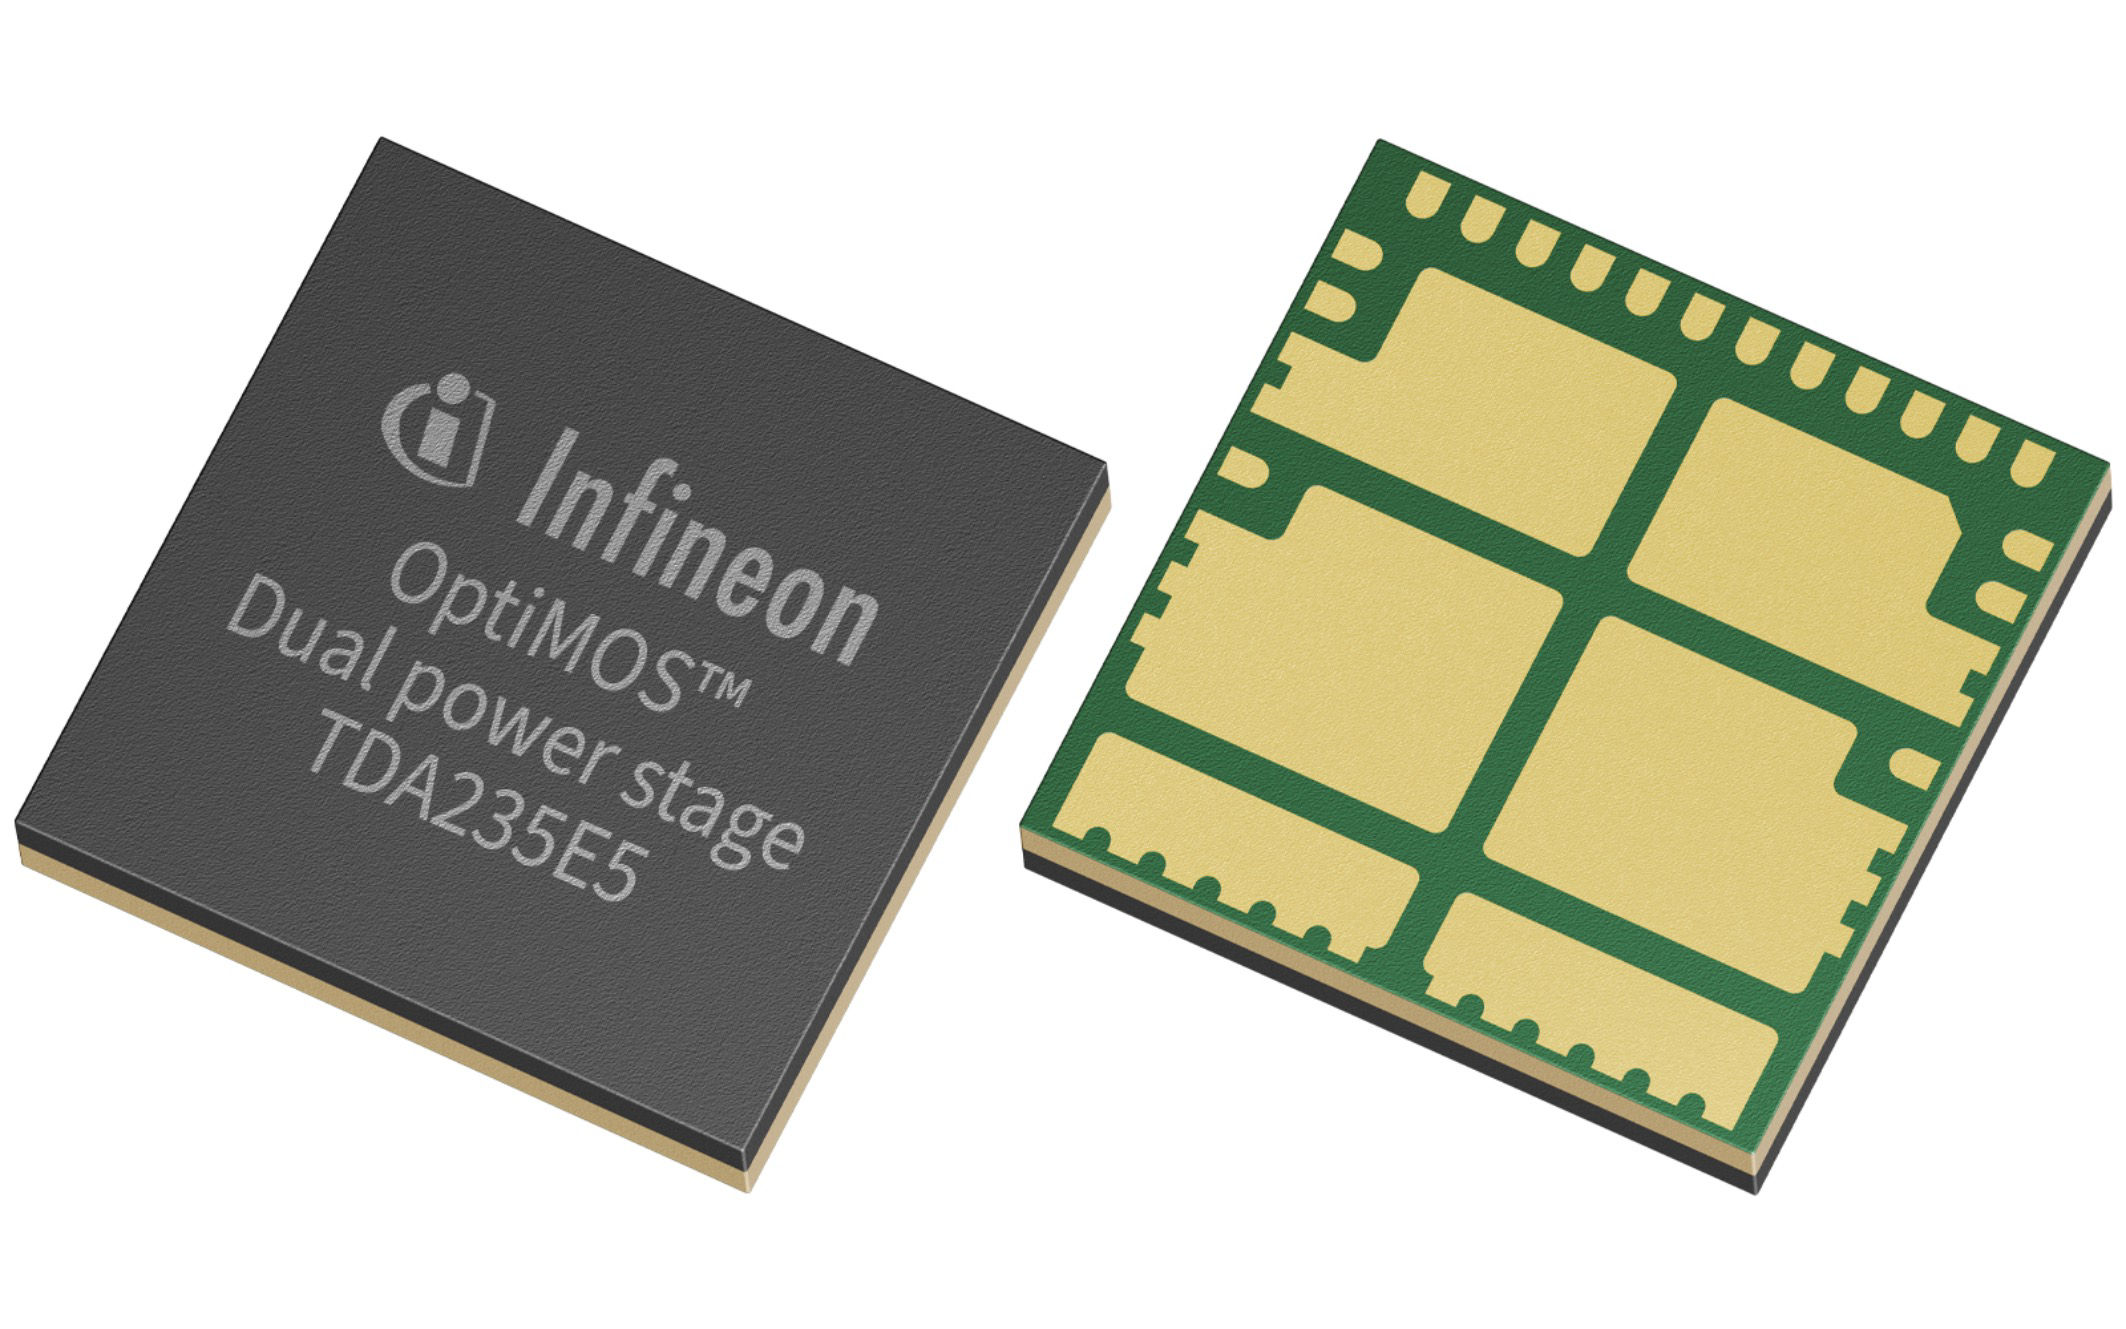
Ngày 7/9, Infineon giới thiệu TDA235E5 và TDA235E0, hai power stage hai pha dành cho AI accelerator và CPU máy chủ. Mỗi linh kiện chỉ 6 × 6 × 0,8 mm nhưng hỗ trợ tới 120 A dòng thiết kế liên tục và 300 A dòng đỉnh, với mật độ dòng vượt 2 A/mm². Engineering sample hiện mới được cung cấp để khách hàng đánh giá, nên đây chưa phải bằng chứng rằng các GPU thương mại đã dùng kiến trúc này. Nhưng thông số của nó cho thấy rất rõ cuộc đua đang chuyển sang đâu.
Ở 1.000 A, vài chục micro-ohm cũng trở thành vấn đề lớn
Tổn hao trên đường cấp nguồn tuân theo công thức quen thuộc P = I²R. Khi dòng chỉ vài ampere, một đoạn copper trace có điện trở rất nhỏ gần như không đáng kể. Khi dòng lên 1.000 A, cùng điện trở đó được nhân với một triệu.
Vicor, một nhà cung cấp module nguồn khác, đưa ra ví dụ cho kiến trúc cấp điện đặt bộ biến đổi ở bên cạnh processor: nếu tổng trở đường cấp nguồn khoảng 200 micro-ohm và dòng liên tục đạt 1.000 A, riêng bo mạch có thể tiêu tán khoảng 200 W. Đây là con số từ mô hình kỹ thuật của nhà cung cấp chứ không phải thông số chung cho mọi accelerator, nhưng phép tính cho thấy vì sao vài centimet copper trên PCB giờ có thể ảnh hưởng trực tiếp tới hiệu suất hệ thống.
Vấn đề còn khó hơn khi tải AI không đứng yên. GPU có thể chuyển nhanh giữa các pha chờ dữ liệu và những cụm phép toán hoạt động đồng thời, khiến dòng thay đổi rất lớn trong thời gian ngắn. Nếu power delivery network không phản ứng đủ nhanh, điện áp tại die có thể tụt tạm thời — hiện tượng voltage droop. Để tránh lỗi, nhà thiết kế phải chừa biên điện áp, thêm capacitor hoặc giảm xung; cả ba đều làm mất một phần lợi ích từ transistor nhanh hơn.
Infineon hiện mô tả các rail cho AI processor ở mức 200–1.000 A, đồng thời cho rằng những kiến trúc mật độ cao hơn có thể tiến tới trên 2.000 A khi các power module được đặt gần tải hơn. Đây là lý do cuộc đua về mật độ dòng — A/mm² — đang trở thành một chỉ số quan trọng gần như mật độ transistor ở một lớp khác của hệ thống.
Vertical power delivery: thay vì đi vòng bên cạnh, đưa điện từ dưới lên
Trong bố trí truyền thống, các voltage regulator nằm xung quanh processor. Dòng điện phải đi theo phương ngang qua PCB hoặc substrate rồi mới tới các bump cấp nguồn. Cách này dễ thiết kế và dễ làm mát, nhưng đường đi dài tạo thêm điện trở và cảm kháng đúng ở nơi dòng điện đang tăng nhanh nhất.
Vertical power delivery (VPD) đổi hình học của bài toán: đặt một phần bộ chuyển đổi nguồn ngay bên dưới processor và đưa dòng theo phương thẳng đứng lên package. Đường dẫn ngắn hơn đồng nghĩa với ít copper hơn, trở kháng thấp hơn và phản ứng tốt hơn khi tải thay đổi nhanh.
Infineon đã đi theo hướng này qua nhiều thế hệ. Module hai pha năm 2024 đạt khoảng 1,6 A/mm²; module bốn pha năm 2026 vượt 2 A/mm². Dòng TDA235E5/E0 mới giữ mật độ trên 2 A/mm² nhưng hạ chiều cao package xuống chỉ 0,8 mm, phù hợp hơn với những bố trí nơi linh kiện nguồn phải chen vào không gian rất sát processor.
Thiết kế mới tích hợp OptiMOS 6 MOSFET và driver hai pha trong cùng package. Việc đưa hai pha vào một linh kiện không chỉ tiết kiệm diện tích; nhiều pha cho phép chia dòng, giảm ripple và phản ứng nhanh hơn khi processor yêu cầu thêm điện đột ngột. Infineon cũng nhấn mạnh đường truyền nhiệt từ junction lên mặt trên package để power stage có thể ghép tốt hơn với liquid cooling.
Đây là một điểm đánh đổi quan trọng. Đặt nguồn sát hoặc dưới GPU giúp giảm tổn hao điện, nhưng đồng thời đưa thêm một nguồn nhiệt vào khu vực vốn đã có mật độ nhiệt cực cao. Vì vậy, VPD không thể tách khỏi thiết kế cold plate, package, capacitor, substrate và cả cách đặt HBM.
Một rack 225 kW khiến “đường dây cuối cùng” trở nên quan trọng
Ở cấp hệ thống, áp lực này dễ thấy hơn. Tài liệu kiến trúc của NVIDIA cho hệ DGX Rubin NVL8 mô tả cấu hình tám hệ trong một rack với mức tiêu thụ khoảng 225 kW mỗi rack. Con số đó bao gồm toàn hệ thống chứ không phải chỉ GPU, nhưng nó cho thấy vì sao kiến trúc nguồn của AI server đang phải thay đổi từ đầu vào tủ rack cho đến vài milimet cuối cùng trước transistor.
Ở phía upstream, ngành đang tăng điện áp phân phối để giảm dòng và tổn hao trên cáp. NVIDIA đã thúc đẩy kiến trúc 800 VDC cho các AI factory thế hệ mới, trong khi nhiều accelerator board dùng bus 48 V ở tầng trung gian. Sau đó điện áp phải được hạ từng bước xuống mức quanh 1 V hoặc thấp hơn cho core. Mỗi lần chuyển đổi đều phải cân bằng hiệu suất, kích thước magnetics, nhiệt và tốc độ đáp ứng.
Điều đáng chú ý là chiến lược này đi theo hai hướng tưởng như ngược nhau: điện áp được tăng lên ở khoảng cách xa để giảm dòng, nhưng lại phải hạ rất thấp ngay sát transistor. Kết quả là phần “last centimeter” của power delivery trở thành nơi có dòng điện lớn nhất trong cả chuỗi.
Backside power delivery là lớp khác — nhưng cùng giải một nút thắt
Vertical power delivery ở cấp board/package không nên nhầm với backside power delivery bên trong chính die silicon. Hai kiến trúc giải cùng vấn đề trở kháng nhưng ở hai lớp khác nhau.
Trong chip truyền thống, dây tín hiệu và mạng cấp nguồn cùng đi qua các lớp kim loại ở mặt trước transistor. Khi transistor nhỏ hơn và mật độ logic tăng, cả hai loại dây tranh nhau không gian. Intel với PowerVia và TSMC với Super Power Rail đang chuyển phần mạng cấp nguồn sang mặt sau wafer, để mặt trước tập trung hơn cho signal routing.
Intel cho biết PowerVia trên Intel 18A có thể giảm worst-case dynamic voltage droop tới 10 lần trong các thiết kế được hãng đánh giá, đồng thời cho phép compaction diện tích ở cấp block. Trong khi đó, TSMC A16 kết hợp nanosheet transistor với backside power rail; TSMC đặt mục tiêu A16 sẵn sàng sản xuất trong nửa cuối 2026 và cho biết so với N2P, node này có thể giảm 15–20% công suất ở cùng tốc độ hoặc tăng 8–10% tốc độ ở cùng Vdd.
Những con số của Intel và TSMC là dữ liệu do chính foundry công bố cho các process cụ thể, không thể cộng trực tiếp với lợi ích của VPD để suy ra mức tiết kiệm cho một GPU hoàn chỉnh. Nhưng hướng thiết kế là nhất quán: rút ngắn đường cấp nguồn ở mọi tầng, từ rack tới board, từ package tới mặt sau transistor.
Cuộc đua AI đang kéo ngành power semiconductor vào trung tâm
TDA235E5/E0 chưa phải một “chip AI” và cũng không làm tăng FLOPS trực tiếp. Nó là linh kiện cấp nguồn — loại thành phần trước đây hiếm khi xuất hiện trong headline về AI. Nhưng khi processor tiến tới hàng nghìn ampere, chất lượng của power delivery có thể quyết định processor giữ được xung bao lâu, cần bao nhiêu capacitor, lãng phí bao nhiêu điện trên PCB và có thể đóng gói dày đến mức nào.
Đó cũng là lý do các hãng power semiconductor đang cạnh tranh bằng những thứ rất khác GPU: mật độ dòng trên mỗi mm², điện trở đường dẫn, tốc độ transient, chiều cao module và khả năng tản nhiệt. Engineering sample 6 × 6 mm của Infineon mới chỉ là một thành phần trong chuỗi đó, nhưng nó cho thấy giới hạn vật lý của AI compute đang lan ra ngoài transistor.
Bước tiếp theo không chỉ là làm power stage chịu được dòng lớn hơn. Các nhà thiết kế phải chứng minh rằng VPD có thể sản xuất ở quy mô lớn, hoạt động ổn định ngay dưới processor, tương thích với liquid cooling và advanced packaging, đồng thời không biến việc sửa chữa hay kiểm thử thành một bài toán quá đắt. Nếu transistor tiếp tục tăng mật độ mà mạng cấp nguồn không theo kịp, chip nhanh hơn trên giấy vẫn có thể bị chặn bởi thứ cơ bản nhất: đường đưa điện tới nó.