Tag: Vision-Language-Action

Chatbot có thể trả lời “gần đúng”: Robot thì không thể “gần như” ...
FEARL của UC Irvine tách robot AI thành một foundation model lo nhìn–hiểu nhiệm vụ và một safety module nhỏ đủ để kiểm chứng toán ...
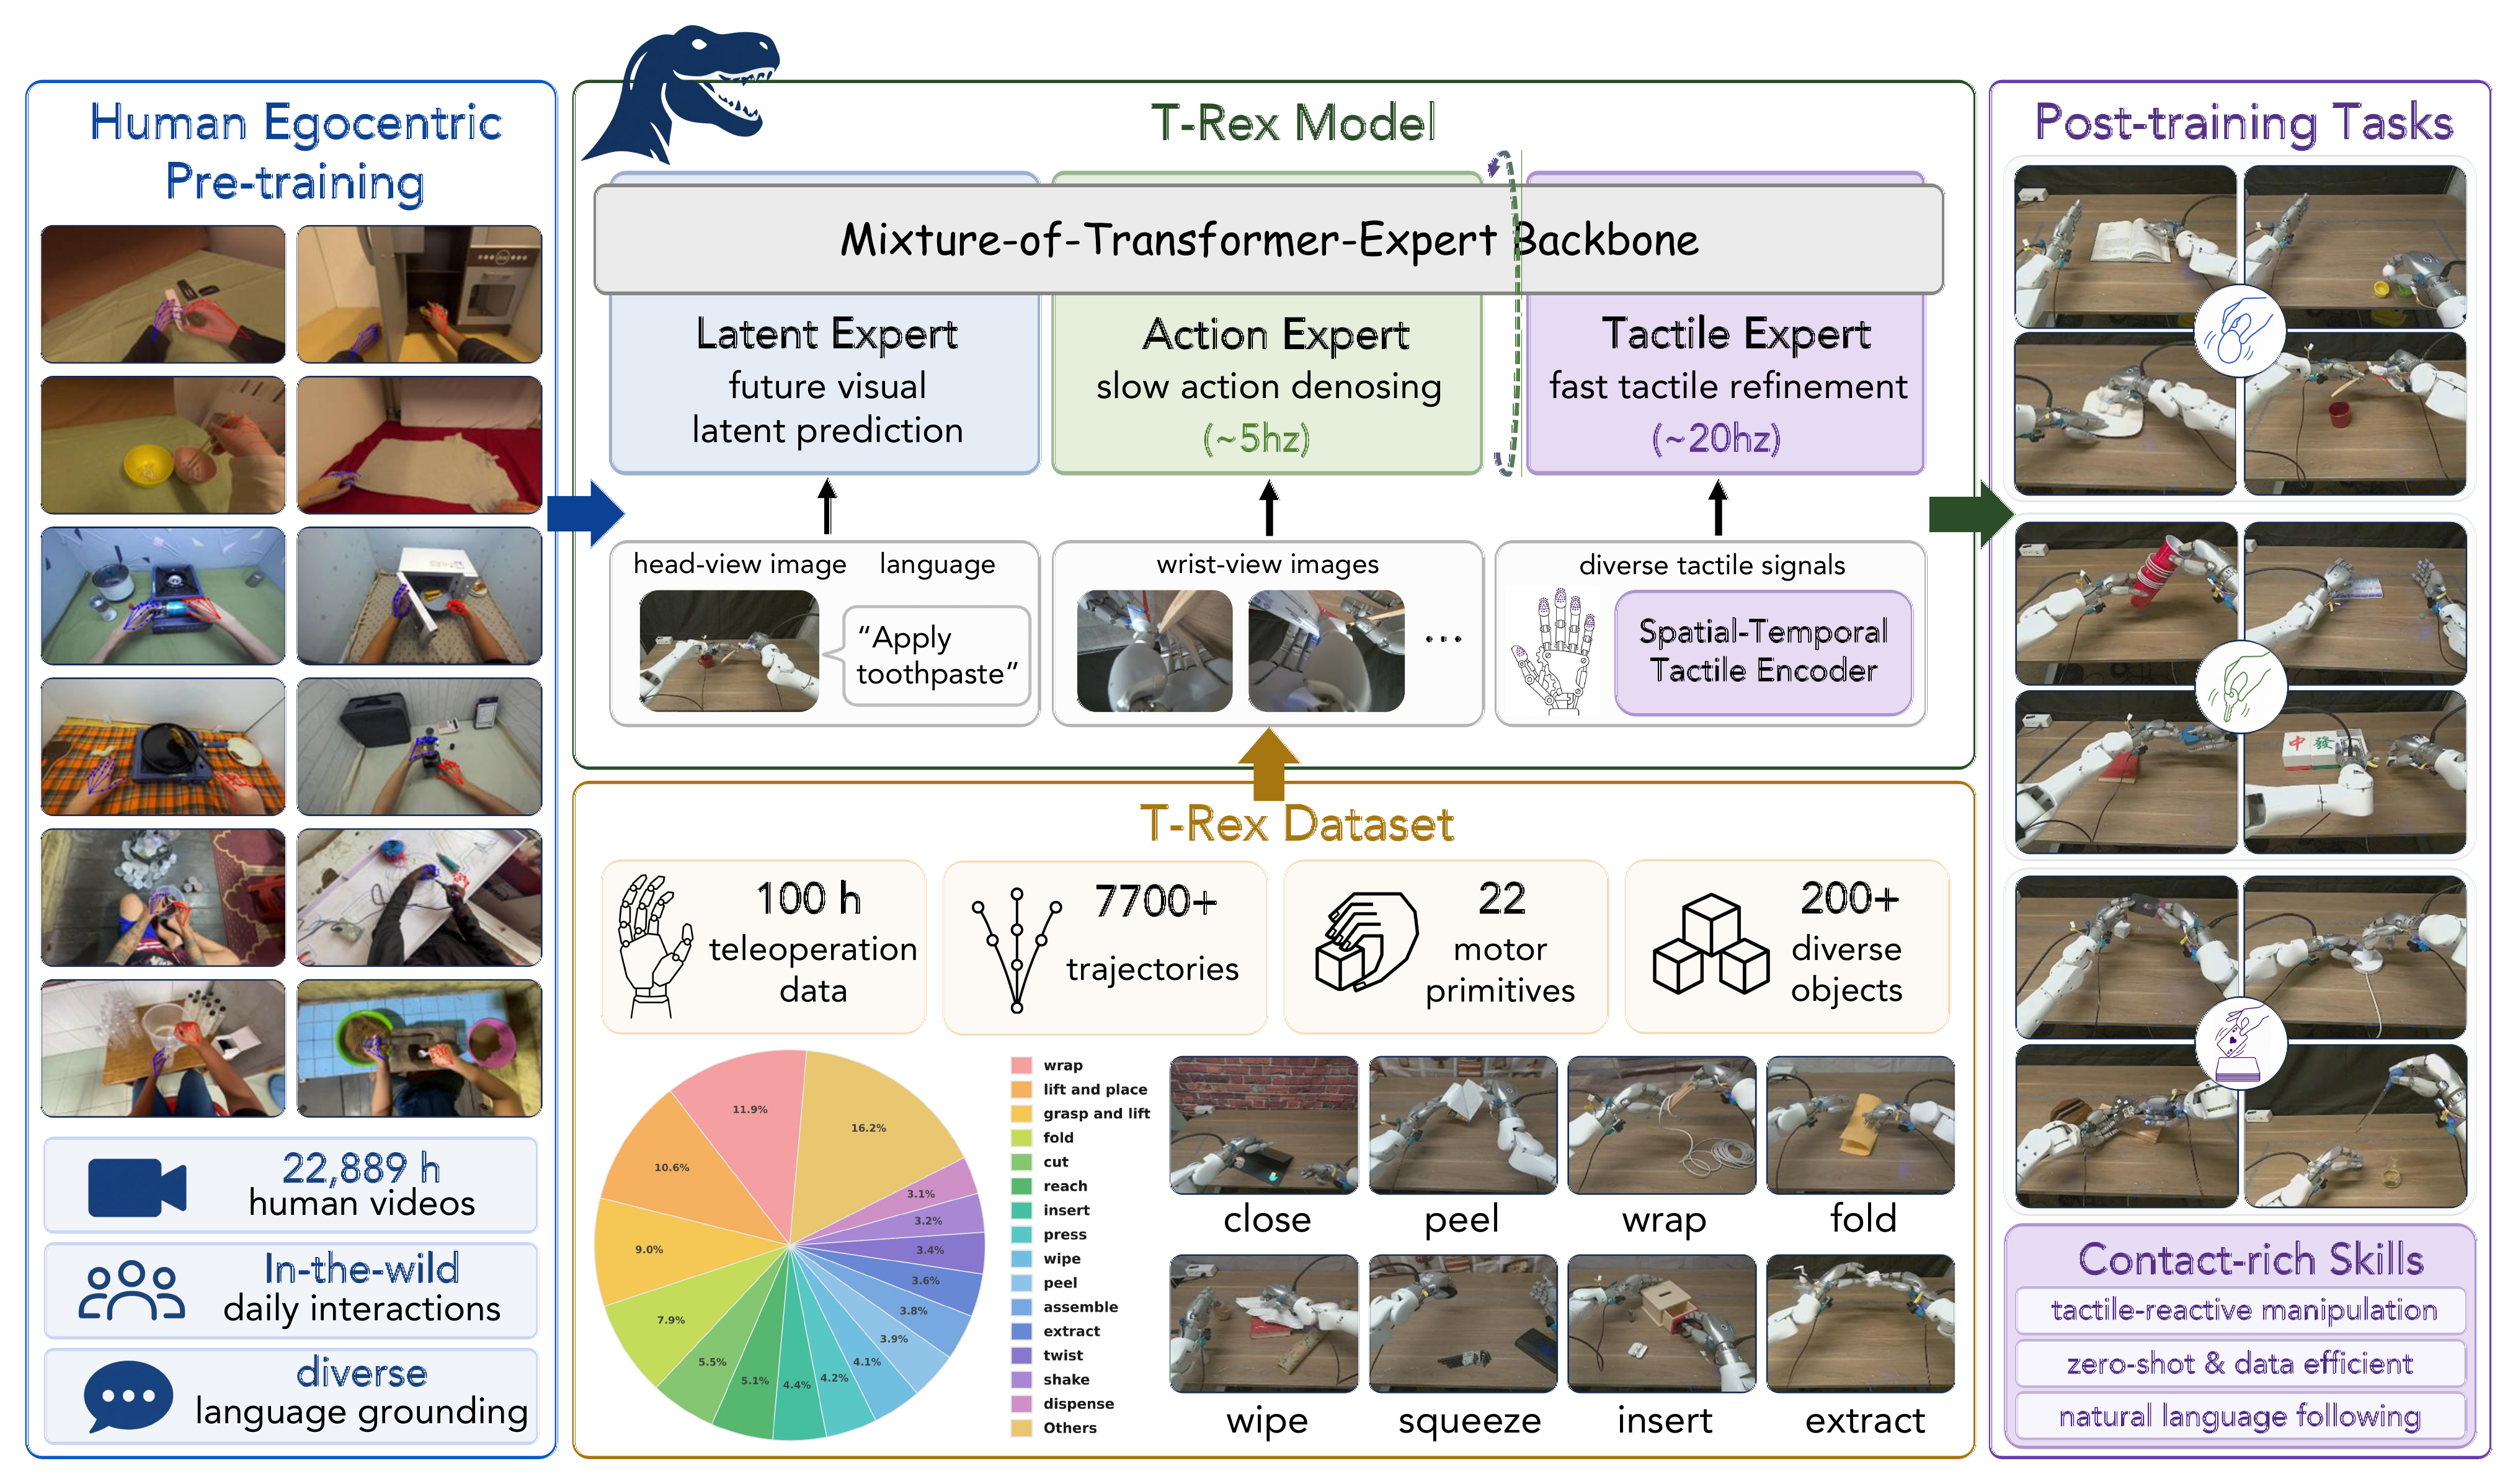
Robot đã có mắt và não AI: Cuộc đua tiếp theo là cho chúng một th...
Các mô hình vision-language-action đã giúp robot hiểu cảnh vật và làm theo chỉ dẫn, nhưng những việc như cắm phích, xoay chìa khóa...
Robot hiện phải được dạy từng kỹ năng: Platform mới muốn biến vid...
FourthHuman đang xây một pipeline biến video góc nhìn thứ nhất của con người thành dữ liệu có cấu trúc cho robot: phân đoạn hành đ...