Robot đã có mắt và não AI: Cuộc đua tiếp theo là cho chúng một thứ con người xem là hiển nhiên — cảm giác chạm
Các mô hình vision-language-action đã giúp robot hiểu cảnh vật và làm theo chỉ dẫn, nhưng những việc như cắm phích, xoay chìa khóa hay giữ quả trứng vẫn phụ thuộc vào lực, độ trượt và biến dạng mà camera khó nhìn thấy. Năm 2026, các nhóm nghiên cứu bắt đầu chạy đua không chỉ để chế tạo cảm biến chạm, mà còn để xây những bộ dữ liệu xúc giác đủ lớn cho AI học cách phản ứng với tiếp xúc.

Một robot có thể nhìn thấy ổ khóa, nhận ra chìa khóa và lập kế hoạch đưa chìa vào đúng vị trí. Nhưng ở những milimet cuối cùng, camera không cho nó biết cạnh chìa vừa chạm vào thành rãnh, lực đang lệch về bên nào hay vật thể bắt đầu trượt khỏi ngón tay. Con người xử lý những tín hiệu này gần như vô thức qua da. Robot thì thường không có lớp thông tin đó.
Đây đang trở thành một trong những nút thắt lớn của robot AI. Các mô hình vision-language-action (VLA) đã tiến nhanh nhờ dữ liệu hình ảnh, video và ngôn ngữ ở quy mô rất lớn, giúp robot nhận biết đồ vật, hiểu chỉ dẫn và sinh chuỗi hành động. Nhưng với những thao tác cần tiếp xúc chính xác — cắm đầu nối, vặn bóng đèn, lau một bề mặt với lực vừa đủ, giữ vật mềm hay chuyển một quả trứng từ khay này sang khay khác — nhìn thôi chưa đủ.
Điểm mới trong năm 2026 là cuộc đua về xúc giác bắt đầu mang dáng dấp của cuộc đua dữ liệu AI. Thay vì chỉ hỏi cảm biến nào nhạy hơn, các nhóm tại UC Berkeley, NVIDIA, Stanford, Tsinghua, Fudan và nhiều tổ chức khác đang hỏi một câu khác: làm thế nào thu đủ dữ liệu chạm, chuẩn hóa chúng giữa nhiều loại phần cứng và đưa chúng vào mô hình đủ nhanh để robot kịp sửa động tác ngay khi tiếp xúc xảy ra?
Camera nhìn thấy vật thể, nhưng không nhìn thấy hết trạng thái tiếp xúc
Thị giác rất mạnh khi robot cần xác định một chiếc cốc nằm ở đâu hoặc tay cầm đang hướng về phía nào. Nhưng nhiều biến quyết định thành công của thao tác chỉ xuất hiện tại vùng tiếp xúc: lực ép theo phương vuông góc, lực trượt theo bề mặt, ma sát, biến dạng và dấu hiệu một vật sắp trượt khỏi tay.
Cảm biến xúc giác vì vậy không đơn giản là một phiên bản khác của camera. Một số hệ thống dùng lớp gel mềm và camera nhỏ để quan sát bề mặt biến dạng khi chạm vật thể. Một số khác dựa trên điện dung, điện trở áp lực hoặc cảm biến lực-mô-men. Chúng có tốc độ, độ phân giải, hình dạng và đơn vị dữ liệu khác nhau. Chính sự phân mảnh này khiến việc xây một “foundation model cho cảm giác chạm” khó hơn nhiều so với gom ảnh JPEG từ Internet.
Một vấn đề khác là thời gian. Robot có thể mất vài trăm mili-giây để một mô hình lớn xử lý ảnh, ngôn ngữ và sinh hành động tiếp theo, nhưng trượt hoặc va chạm có thể xảy ra nhanh hơn thế. Nếu tín hiệu xúc giác chỉ được đưa vào cùng một vòng suy luận chậm, robot có thể biết mình đang mất vật thể sau khi đã quá muộn.
T‑Rex tách phần “nghĩ” chậm và phần “cảm” nhanh
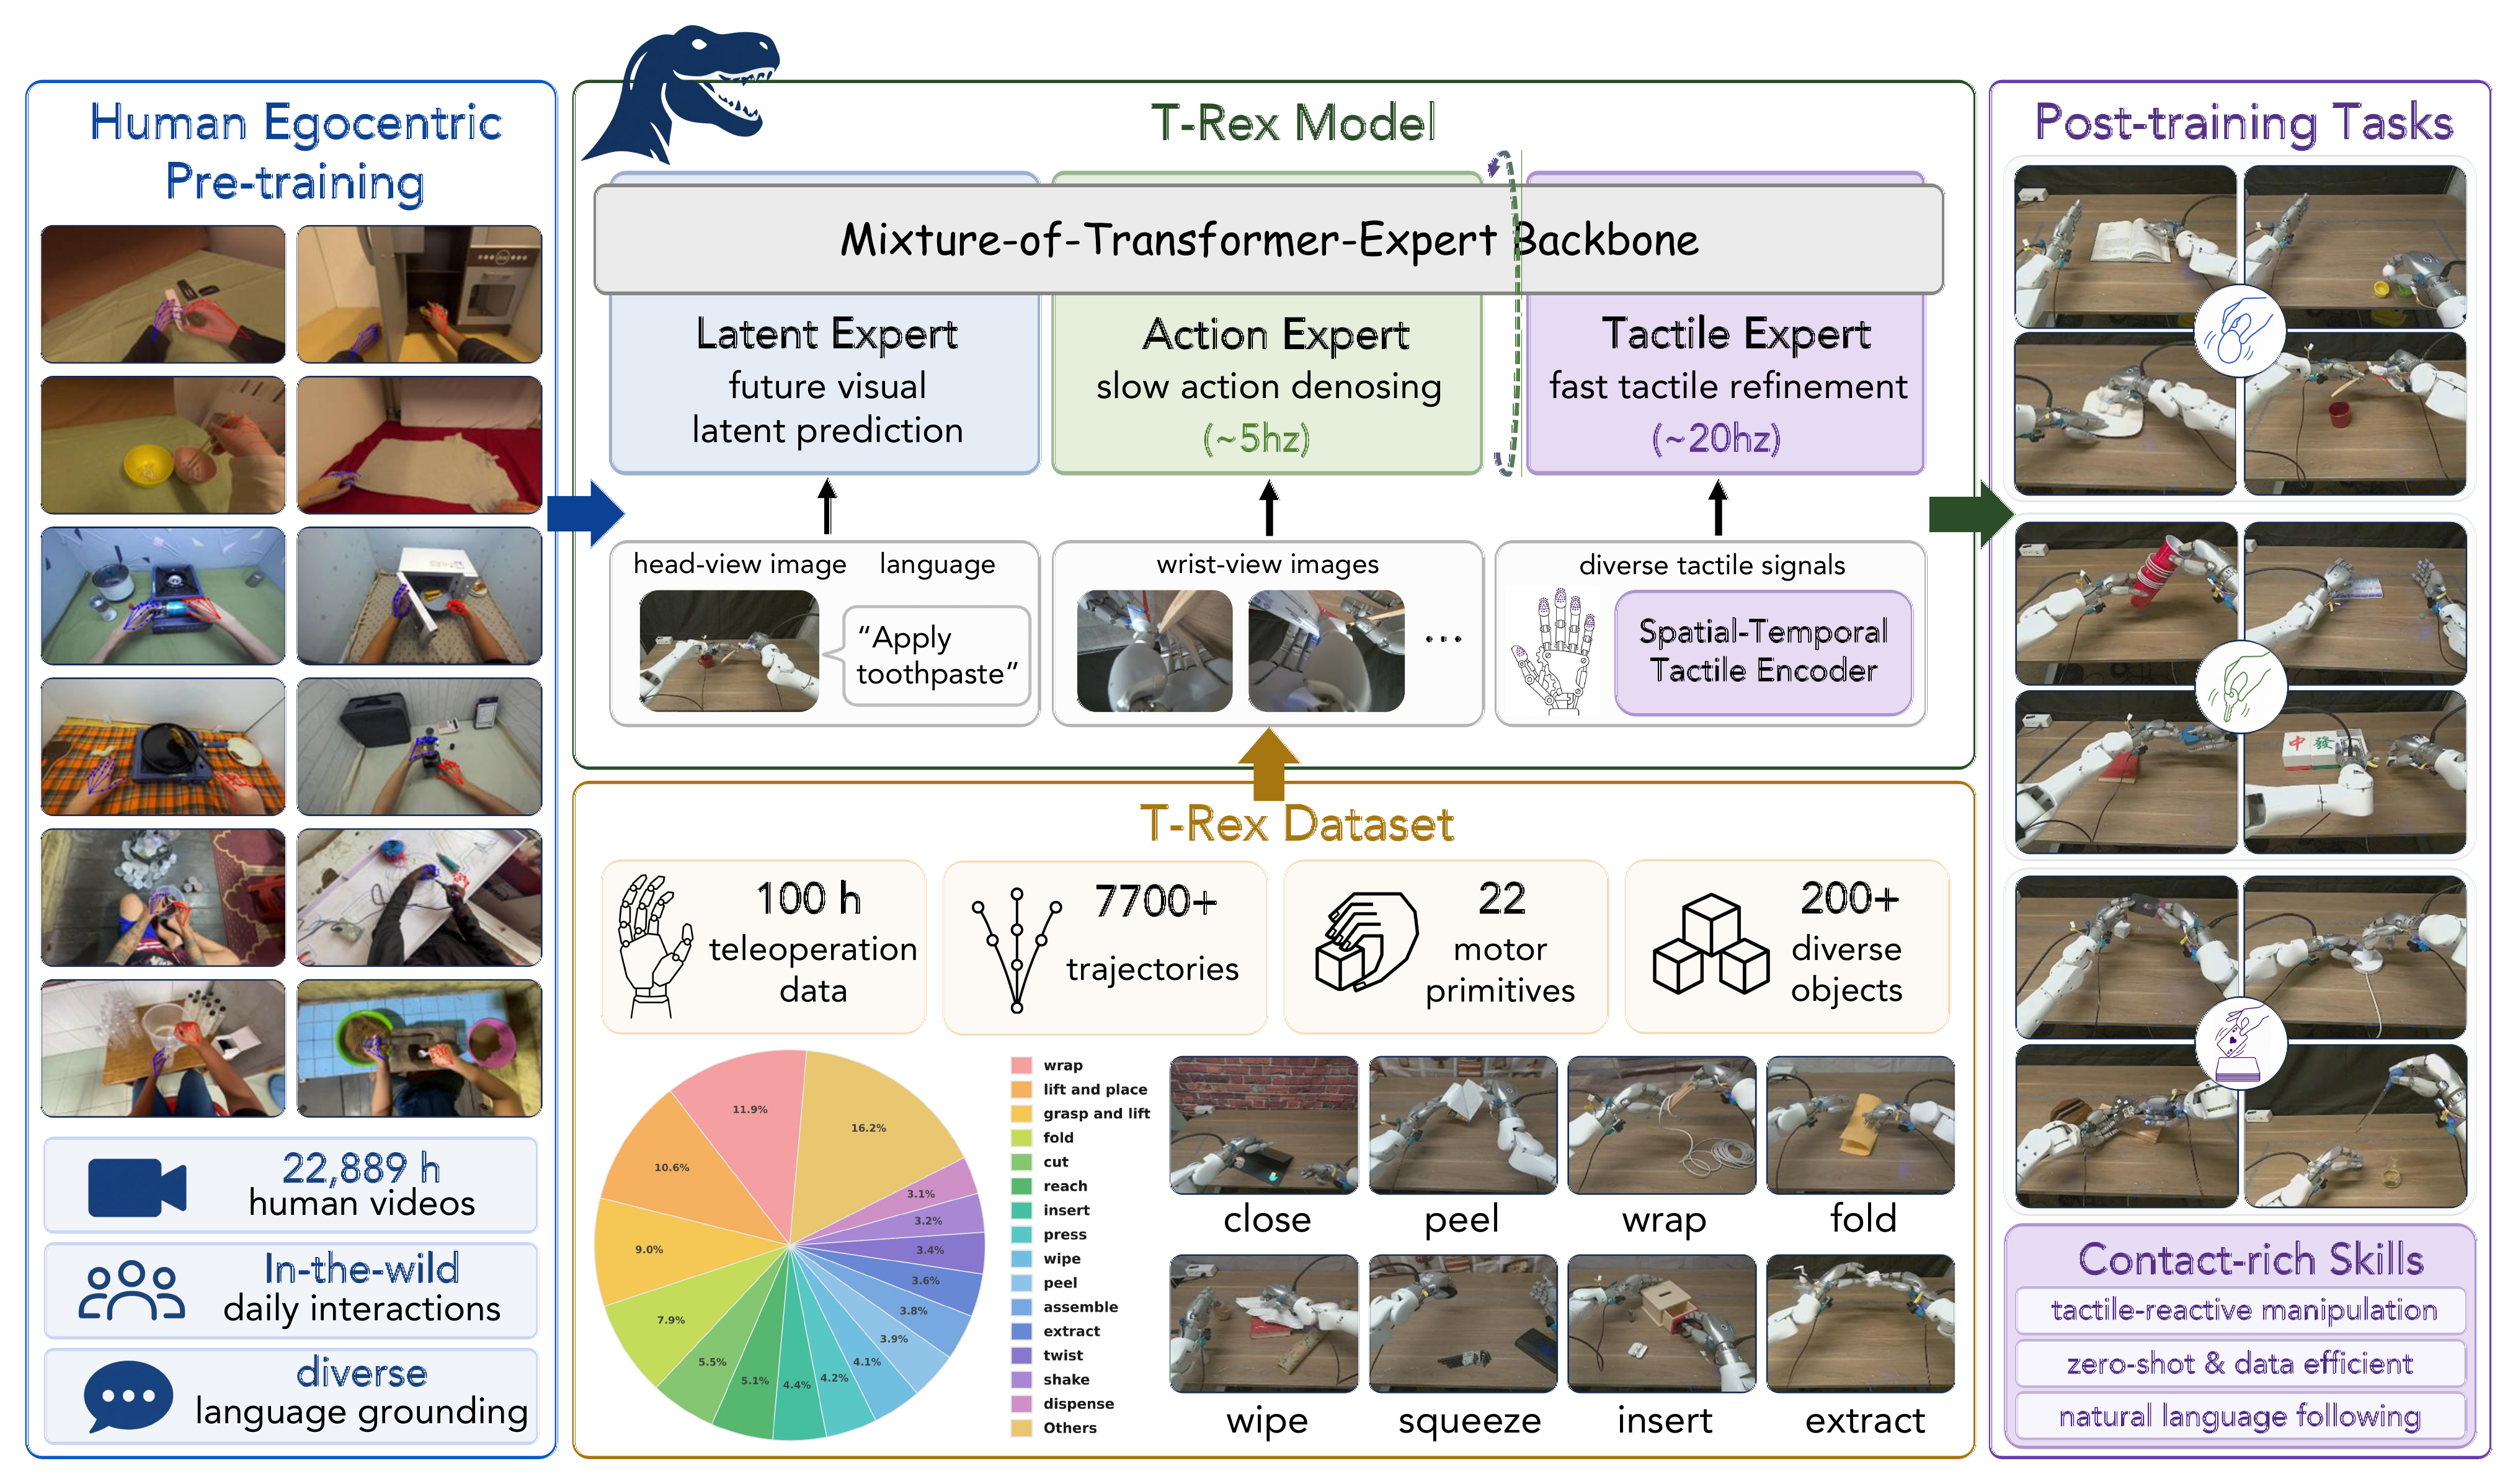
T‑Rex, một dự án của các nhà nghiên cứu từ UC Berkeley, NVIDIA, Stanford và các đối tác, là ví dụ rõ nhất cho cách giải bài toán này. Nhóm thu khoảng 100 giờ dữ liệu robot có đồng bộ tín hiệu xúc giác, hơn 7.700 quỹ đạo thao tác, 22 primitive vận động và hơn 200 vật thể. Dữ liệu tập trung vào những hành vi cơ bản như đóng, bóc, quấn, gập, lau, bóp, chèn và rút vật.
Thay vì bắt một mô hình duy nhất xử lý mọi thứ ở cùng tốc độ, T‑Rex chia công việc thành các “expert”. Action expert lập kế hoạch chuyển động ở khoảng 5 Hz, còn tactile expert chạy ở khoảng 20 Hz để dùng tín hiệu chạm chỉnh lại hành động nhanh hơn. Nói đơn giản, tầng thị giác-ngôn ngữ quyết định robot nên làm gì; tầng xúc giác liên tục sửa cách bàn tay thực hiện việc đó khi vật thật bắt đầu đẩy ngược lại.
Trong 12 nhiệm vụ thực tế do nhóm thiết kế — gồm lật trang, chuyển trứng, lau đĩa, bóp kem đánh răng, mở khóa và vặn bóng đèn — T‑Rex đạt trung bình 65% lượt thử thành công. Baseline mạnh nhất trong bảng so sánh, EgoScale, đạt 35%. Đáng chú ý hơn, một phiên bản π0.5 được thêm tín hiệu tactile theo cách đơn giản chỉ đạt 6%, thấp hơn cả π0.5 không dùng xúc giác ở mức 17%.
Chi tiết này quan trọng vì nó cho thấy “gắn thêm cảm biến” không tự động làm robot khéo hơn. Mô hình phải biết tín hiệu chạm nào đáng chú ý, tích hợp nó với kế hoạch hiện tại và phản ứng ở tốc độ phù hợp. T‑Rex hiện là preprint trên arXiv; các con số trên đến từ bộ đánh giá và phần cứng của chính nhóm, chưa phải benchmark độc lập trên robot thương mại.
Từ 100 giờ lên 3.000 giờ rồi 30.000 giờ
Nếu T‑Rex tập trung vào khả năng phản ứng nhanh, FTP‑1 nhắm vào một vấn đề khác: mỗi loại cảm biến xúc giác đang nói một “ngôn ngữ” riêng.
FTP‑1, do nhóm từ Tsinghua University cùng UC Berkeley, Shanghai Jiao Tong University, ETH Zurich, Sharpa và các cộng tác viên phát triển, được pretrain trên khoảng 3.000 giờ dữ liệu từ 26 nguồn, bao phủ 21 loại cảm biến tactile. Hệ thống dùng các encoder riêng cho dữ liệu dạng ảnh, dạng mảng và dạng trạng thái, rồi chiếu chúng vào một không gian token chung trước khi đưa qua tactile Transformer.
Theo preprint của nhóm, cách này cải thiện hiệu quả thao tác giàu tiếp xúc trên những cấu hình cảm biến đã thấy trong lúc pretrain và vẫn chuyển được sang hai cấu hình cảm biến chưa xuất hiện trong dữ liệu huấn luyện. Đây là mục tiêu quan trọng nếu ngành robot muốn tránh việc đổi một ngón tay hoặc cảm biến là phải huấn luyện lại toàn bộ policy từ đầu.
Ở quy mô lớn hơn, Fudan University và NeoteAI công bố N₀‑Foundation với NeoData: hơn 30.000 giờ tương tác vision–tactile, 1,4 triệu episode, sáu embodiment và hơn 450 nhiệm vụ. Một phần 5.000 giờ được nhóm đưa ra dưới dạng OpenNeoData. Hệ thống thu dữ liệu từ năm nền tảng robot và một gripper cầm tay có hai cảm biến xúc giác, camera góc rộng cùng theo dõi chuyển động.
N₀‑Foundation còn thử chuyển dữ liệu từ những phần cứng khác nhau về một đại lượng chung hơn: trường lực ba chiều gồm hai thành phần lực cắt và một thành phần áp lực vuông góc. Trong benchmark NeoReal của nhóm, cùng backbone π0.5, policy không dùng tactile đạt tỷ lệ thành công trung bình 26,5% trên 10 nhiệm vụ. Khi điều kiện hóa bằng representation trường lực NeoForce, con số tăng lên 32,5%.
Đây vẫn là technical report do chính NeoteAI và nhóm Fudan công bố, nên chưa nên đọc 30.000 giờ như bằng chứng rằng bài toán xúc giác đã được giải. Nó cho thấy một xu hướng khác: tactile AI đang bắt đầu có hạ tầng thu thập dữ liệu, benchmark và representation riêng, tương tự giai đoạn thị giác máy tính từng chuyển từ các demo nhỏ sang dataset chung.
Cảm giác chạm cũng không nên chỉ nằm ở đầu ngón tay
Một nhánh nghiên cứu khác đang mở rộng xúc giác ra toàn bộ cơ thể robot. Trong bài báo được Nature Sensors công bố tháng 7/2026, nhóm của Yajing Shen trình bày EmArm, một cánh tay robot phủ các vùng “da” mềm kích thước lớn, kết hợp với cảm nhận vị trí khớp và vòng điều khiển perception–action khép kín.
Hệ thống định vị tiếp xúc với độ chính xác dưới milimet theo báo cáo của nhóm, đồng thời dùng tín hiệu chạm để nhận biết tương tác với người, thao tác vật lớn và lập lại quỹ đạo khi gặp vật cản trong tình huống camera bị che khuất. Ý tưởng ở đây khác với việc làm đầu ngón tay tinh hơn: robot cần biết cả khi cẳng tay, cổ tay hoặc một vùng khác của cơ thể vô tình chạm môi trường.
Điều đó đặc biệt quan trọng nếu robot được đưa ra khỏi dây chuyền cố định để làm việc quanh con người. Một cánh tay chỉ nhận ra va chạm thông qua mô-men ở động cơ có thể biết “có gì đó không ổn”; da xúc giác phân bố có thể bổ sung thông tin về chính xác chỗ nào đang tiếp xúc và tiếp xúc đó thay đổi ra sao.
Nút thắt mới không chỉ là cảm biến, mà là dữ liệu và kiến trúc
Cảm biến tactile đã tồn tại nhiều năm. Điều đang thay đổi là chúng bắt đầu được đặt vào cùng hệ sinh thái với foundation model, dữ liệu đa embodiment và policy học từ demonstration. Nhưng đây cũng là nơi những giới hạn trở nên rõ hơn.
Không giống ảnh và văn bản, dữ liệu xúc giác không có sẵn trên Internet. Mỗi giờ dữ liệu thường phải được tạo bằng robot thật hoặc thiết bị thu chuyên dụng. Cảm biến mòn, bề mặt tiếp xúc thay đổi, calibration lệch và các loại phần cứng sinh tín hiệu không tương thích. Dữ liệu cũng thưa theo thời gian: trong nhiều thao tác, phần lớn khoảnh khắc robot chưa chạm gì, sau đó một sự kiện tiếp xúc ngắn lại quyết định toàn bộ kết quả.
Vì thế, quy mô dữ liệu có thể là điều kiện cần nhưng chưa chắc là điều kiện đủ. Kết quả của T‑Rex cho thấy kiến trúc phản ứng nhanh có thể quan trọng không kém số giờ huấn luyện; FTP‑1 cho thấy phải giải bài toán khác biệt phần cứng; còn N₀‑Foundation cho thấy ngay cả khi có hàng chục nghìn giờ dữ liệu, mức cải thiện trên benchmark thực vẫn còn tương đối khiêm tốn.
Nếu robot hình người và robot đa năng muốn đi từ những demo được chuẩn bị kỹ sang bếp, kho hàng, bệnh viện hay nhà ở, “não” AI sẽ phải học một điều mà sinh học giải quyết từ rất sớm: hành động không chỉ là gửi lệnh cho cơ bắp rồi chờ hình ảnh tiếp theo. Nó là một vòng lặp liên tục giữa dự đoán và tiếp xúc — chạm, cảm nhận sai lệch, rồi sửa động tác trước khi vật rơi khỏi tay.
Nguồn: T‑Rex project / UC Berkeley, NVIDIA, Stanford và cộng tác viên; FTP‑1 preprint; N₀‑Foundation / NeoteAI & Fudan TEAI Team; Nature Sensors — EmArm; IEEE Robotics & Automation Society.