AI hiện chủ yếu học từ dữ liệu scientist tạo ra: Phòng lab tương lai có thể để robot tự tạo luôn dữ liệu nó cần
Self-driving laboratory khép kín vòng lặp giữa AI và thế giới vật lý: mô hình chọn thí nghiệm tiếp theo, hệ thống tự tổng hợp mẫu và đo kết quả, rồi dữ liệu mới quay lại để cập nhật mô hình. PoLARIS của NC State và Brown đã hoàn thành 120 thí nghiệm vật liệu trong chưa đầy 12 giờ, nhưng mức tự chủ hiện vẫn bị giới hạn bởi không gian tìm kiếm, phần cứng và các bước characterization ngoài vòng lặp.

Phần lớn AI dùng trong khoa học hiện nay bắt đầu từ một thứ đã tồn tại: dữ liệu. Một mô hình có thể đọc hàng triệu cấu trúc vật liệu, phổ đo, ảnh kính hiển vi hoặc kết quả thí nghiệm rồi tìm quy luật mà con người khó nhìn thấy. Nhưng phía trước tập dữ liệu đó thường vẫn là một nhà khoa học đã quyết định cần thử gì, chuẩn bị mẫu, vận hành thiết bị và đo kết quả.
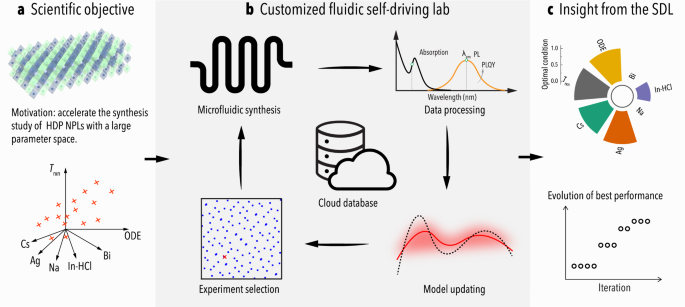
Self-driving laboratory muốn đóng luôn khoảng trống này. Thay vì AI chỉ nhận dữ liệu sau khi con người làm xong thí nghiệm, mô hình chọn thí nghiệm tiếp theo; hệ thống tự tạo mẫu và đo nó; kết quả mới quay lại làm dữ liệu học; rồi vòng lặp lặp lại. AI không còn chỉ đọc quá khứ của phòng lab mà bắt đầu quyết định dữ liệu nào đáng tạo ra tiếp theo.
Một ví dụ cụ thể được công bố ngày 4/5/2026 trên Nature Communications. Nhóm tại North Carolina State University và Brown University xây dựng PoLARIS — viết tắt của perovskite laboratory for autonomous reaction inference and synthesis — để tự tổng hợp và tối ưu một họ nanoplatelet double perovskite nhiều thành phần. Trong một chiến dịch, hệ thống thực hiện 120 thí nghiệm trong chưa đầy 12 giờ, tự dùng kết quả của những lượt trước để chọn điều kiện cho những lượt sau.
Khác biệt nằm ở vòng kín, không phải ở cánh tay robot
Một phòng lab tự động chưa chắc là một self-driving lab. Máy chia chất lỏng có thể pipette hàng nghìn giếng theo một protocol do con người viết, nhưng nếu nó cứ thực hiện một danh sách cố định từ đầu tới cuối thì đó vẫn chủ yếu là automation.
Self-driving lab thêm một vòng phản hồi. Sau mỗi nhóm thí nghiệm, dữ liệu được phân tích ngay và mô hình quyết định điểm nào trong không gian tham số đáng thử tiếp. Đây là dạng active learning hoặc Bayesian optimization: hệ thống không cố đo mọi khả năng, mà cân bằng giữa hai mục tiêu — thử những vùng nó dự đoán sẽ cho kết quả tốt và thăm dò những vùng nó còn chưa chắc chắn.
PoLARIS thể hiện khá rõ cấu trúc này. Hệ thống kiểm soát bảy biến liên quan đến thành phần precursor, dung môi và nhiệt độ phản ứng. Các bơm syringe đưa dòng hóa chất vào một reactor vi lưu; những giọt phản ứng nhỏ đi qua vùng gia nhiệt rồi chạy qua các cell quang học để đo hấp thụ UV–Vis và photoluminescence ngay trên dòng chảy.
Phần mềm xử lý phổ, trích các đặc trưng như vị trí peak, cường độ phát xạ và diện tích phát xạ, rồi lưu cả dữ liệu thô, dữ liệu xử lý, điều kiện tổng hợp và timestamp. Những dữ liệu đó huấn luyện một Gaussian-process surrogate model. Mô hình sau đó đề xuất nhóm thí nghiệm kế tiếp.
Điểm quan trọng là dữ liệu mới không phải dữ liệu mô phỏng mà được tạo bởi phản ứng hóa học thật. Khi một đề xuất được đưa ra, thiết bị phải thay đổi lưu lượng precursor và nhiệt độ, tổng hợp mẫu mới, đo mẫu rồi mới biết dự đoán có đúng hay không.
120 thí nghiệm không được chọn giống nhau
PoLARIS không bắt đầu từ con số không. Nhóm nghiên cứu trước hết chạy 80 điều kiện được chọn bằng Latin hypercube sampling để phủ tương đối rộng không gian thí nghiệm. Sau đó mới có 40 vòng Bayesian optimization do hệ thống tự chọn.
Trong mỗi nhóm năm đề xuất, bốn điều kiện được chọn theo chiến lược expected improvement — ưu tiên các vùng có khả năng cải thiện kết quả tốt nhất — và một điều kiện dùng upper confidence bound để thăm dò vùng còn nhiều bất định. Đây là chi tiết quan trọng: nếu AI chỉ liên tục khai thác vùng đang tốt nhất, nó có thể mắc kẹt ở một cực đại cục bộ và không bao giờ tìm thấy vùng tốt hơn ở nơi khác.
Mục tiêu của chiến dịch là tăng photoluminescence quantum yield (PLQY) của nanoplatelet. Proxy PLQY tốt nhất đo trực tiếp trong dòng tăng từ khoảng 17% lên 30%; mẫu tốt nhất sau purification đạt PLQY tuyệt đối 45% khi được đo offline bằng integrating sphere. Toàn bộ 120 thí nghiệm tiêu thụ khoảng 30 mL của mỗi precursor.
Nhưng con số đáng chú ý hơn ở đây không nhất thiết là 45%. Nó là cách kết quả được tìm ra: mô hình không nhận sẵn một database hoàn chỉnh rồi chọn hàng tốt nhất. Nó dùng mỗi thí nghiệm để quyết định thí nghiệm nào đáng mua bằng thời gian và hóa chất tiếp theo.
Đây là nơi AI bắt đầu tự tạo training data của chính nó
Trong machine learning truyền thống, một trong những nút thắt lớn nhất là dữ liệu. Với khoa học thực nghiệm, dữ liệu tốt còn đắt hơn vì mỗi điểm có thể đòi hỏi tổng hợp một mẫu vật lý, chờ phản ứng, hiệu chuẩn thiết bị và characterization.
Self-driving lab thay đổi bài toán từ “thu thật nhiều dữ liệu rồi train model” sang “chọn điểm dữ liệu nào đáng tạo ra nhất”. Nếu một thí nghiệm tốn hàng giờ hoặc dùng vật liệu đắt tiền, việc giảm số thử nghiệm vô ích có thể quan trọng không kém việc làm robot chạy nhanh hơn.
PoLARIS còn dùng model đã học như một dạng digital twin dữ liệu của quá trình tổng hợp. Phân tích SHAP chỉ ra nồng độ Cs, precursor In-HCl và nhiệt độ phản ứng là những biến ảnh hưởng mạnh nhất tới mục tiêu quang học. Sau đó nhóm không dừng ở correlation: họ chạy các dynamic flow experiments, liên tục thay đổi từng tham số trong khi đo phổ theo thời gian để kiểm tra cơ chế phản ứng.
Đây là điểm khiến self-driving lab đáng quan tâm hơn một cỗ máy tối ưu công thức. Về nguyên tắc, cùng vòng lặp có thể được dùng không chỉ để tìm “điểm tốt nhất” mà còn để chọn những thí nghiệm làm giảm bất định về một giả thuyết khoa học.
AI vẫn chưa thực sự tự quyết định toàn bộ câu hỏi khoa học
Từ “self-driving” dễ tạo cảm giác rằng nhà khoa học chỉ cần bật máy rồi chờ phát hiện xuất hiện. PoLARIS chưa ở mức đó.
Con người vẫn xác định mục tiêu — ở đây là tối đa hóa một proxy của PLQY — thiết kế reactor, chọn bảy biến được phép thay đổi, đặt giới hạn lưu lượng và nhiệt độ, chuẩn bị precursor và quyết định phép đo nào đủ để đánh giá sản phẩm. Một số characterization quan trọng của mẫu tốt nhất, gồm X-ray diffraction và transmission electron microscopy, vẫn được thực hiện offline.
Không gian mà AI được phép tìm kiếm cũng do phần cứng quyết định. Trong nghiên cứu này, nhiệt độ tối đa bị giới hạn ở 220 °C bởi tubing PFA, còn bảy dòng precursor phải nằm trong giới hạn lưu lượng nhất định. Khi Bayesian optimizer liên tục đẩy một số tham số tới biên, nó không thể tự lắp một reactor chịu nhiệt cao hơn hay đưa vào một nguyên tố mới.
Đó là một trong những giới hạn lớn nhất của self-driving labs hiện nay: AI có thể tự tối ưu bên trong một “hộp” được con người xây, nhưng thay đổi chính cái hộp thường vẫn cần con người.
Một nghiên cứu mới đang thử tự động hóa cả việc chọn “hộp”
Ngày 25/8/2026, một nhóm khác công bố trên Communications Materials một framework dùng LLM làm vòng ngoài cho bài toán khám phá vật liệu. Trong kiến trúc đó, Bayesian optimization vẫn chọn candidate bên trong một không gian vật liệu hiện tại, còn LLM xem dữ liệu đã tích lũy rồi đề xuất ba nguyên tố cho không gian tìm kiếm tiếp theo.
Ý tưởng giải quyết đúng điểm yếu vừa nêu: thay vì con người phải dừng hệ thống và quyết định “giờ hãy thử Fe–Co–Ni thay vì bộ nguyên tố trước”, một mô hình có thể tự đề xuất lần mở rộng kế tiếp.
Nhưng kết quả này cần đọc cẩn thận. Đây là proof of concept trên một dataset DFT công khai gồm 16.908 hợp kim ba thành phần, không phải một robot đã tự thay bình precursor rồi tổng hợp vật liệu mới. Tác giả cũng lưu ý rằng LLM dùng trong thử nghiệm có thể đã tiếp xúc với dữ liệu tương tự trong quá trình pre-training, nên chưa thể khẳng định hiệu quả tương tự sẽ giữ nguyên trên một không gian vật liệu thực sự chưa từng xuất hiện.
Nói cách khác, hai mảnh ghép đang tiến tới nhau từ hai phía: PoLARIS cho thấy phần cứng có thể tự tạo dữ liệu vật lý rồi học từ nó; nghiên cứu LLM cho thấy phần mềm có thể bắt đầu tự mở rộng vùng tìm kiếm. Ghép được cả hai trong một hệ thống thực là bài toán khó hơn nhiều.
Self-driving lab không nhất thiết phải là một phòng lab triệu USD
Một rào cản khác là chi phí. Nhiều hệ thống tự động dùng robotic arm, liquid handler và thiết bị phân tích có giá trên 100.000 USD trước cả khi tính những máy đo đắt tiền.
Trong tháng 4/2026, nhóm Timothy Noël tại University of Amsterdam công bố RoboChem-Flex trên Nature Synthesis, một kiến trúc self-driving lab hóa học modular sử dụng linh kiện phổ thông, 3D printing và Bayesian optimization. Một cấu hình human-in-the-loop dùng module lấy mẫu có chi phí phần cứng khoảng 5.000 USD; để chạy closed loop hoàn toàn vẫn cần ghép thêm analytical equipment.
Nhóm thử nền tảng trên sáu bài toán từ photocatalysis, biocatalysis tới cross-coupling và asymmetric catalysis. Trong một case, hệ thống bắt đầu với 15 thí nghiệm khởi tạo, sau đó tự chạy optimization và hội tụ ở điều kiện cho 71% yield với residence time hai phút sau 13 lượt tối ưu.
Điều này cho thấy xu hướng không chỉ là làm một “robot scientist” cực kỳ đắt. Một hướng quan trọng khác là chuẩn hóa hardware và software để nhiều phòng lab có thể tham gia tạo dữ liệu machine-readable, tái lập được và đủ chi tiết cho vòng lặp AI.
Nút thắt tiếp theo là dữ liệu có provenance, phần cứng tương thích và an toàn
Một review đăng tháng 7/2026 trên Nature Reviews Chemistry cho rằng giai đoạn tiếp theo của self-driving laboratories phụ thuộc vào ba yếu tố: khả năng scale, khả năng generalize và dữ liệu có provenance xuyên suốt từ chuẩn bị precursor tới synthesis, characterization và đánh giá hiệu năng.
Điểm này dễ bị đánh giá thấp. Một robot tạo 100.000 điểm dữ liệu không hữu ích nếu sau đó không thể biết calibration nào đã được dùng, batch hóa chất nào tạo ra mẫu, nhiệt độ thực tế lệch bao nhiêu hoặc software phiên bản nào đã xử lý phổ. Với AI, metadata không phải giấy tờ hành chính; nó quyết định dữ liệu có học được và tái lập được hay không.
Ngoài ra còn có bài toán an toàn. Khi một model được phép chuyển từ đề xuất văn bản sang hành động vật lý — mở van, gia nhiệt, phối trộn hóa chất hoặc điều khiển robot — lỗi không còn chỉ tạo ra một câu trả lời sai. Nó có thể tạo ra phản ứng ngoài dự kiến hoặc làm hỏng thiết bị. Vì vậy self-driving lab thực tế sẽ cần guardrail ở cả software lẫn hardware, giới hạn rõ những hành động AI được phép thực thi.
PoLARIS chưa phải một “nhà khoa học robot” có thể tự nghĩ ra câu hỏi nghiên cứu bất kỳ. Nó là một hệ thống rất chuyên biệt cho một họ phản ứng, với mục tiêu và biên hoạt động do con người thiết kế. Nhưng nó minh họa khá rõ thay đổi đang xảy ra: AI không nhất thiết phải chờ scientist mang dữ liệu tới nữa. Trong một vòng thí nghiệm đủ khép kín, chính mô hình có thể quyết định dữ liệu nào còn thiếu, yêu cầu máy tạo điểm dữ liệu đó, học từ kết quả rồi tiếp tục hỏi câu kế tiếp.
Bước tiếp theo không chỉ là làm AI thông minh hơn. Đó là xây những phòng lab đủ modular để model có thể chuyển câu hỏi thành thí nghiệm thật, đủ chuẩn hóa để dữ liệu tạo ra có thể dùng lại, và đủ an toàn để vòng lặp đó chạy hàng giờ hoặc hàng ngày mà không cần một người đứng cạnh cho mỗi lần thử.