Sau AI dự đoán có thể là AI tìm định luật: Machine learning bắt đầu trả lại cho nhà khoa học những phương trình để kiểm chứng
Một lớp hệ thống AI mới không chỉ trả về dự đoán mà còn tìm các biểu thức toán học tường minh từ dữ liệu. Năm 2026, các nghiên cứu đã dùng symbolic regression cho sắc ký, cơ học vật liệu và hệ động lực đa thang — nhưng một phương trình khớp dữ liệu vẫn chưa tự động trở thành định luật khoa học.

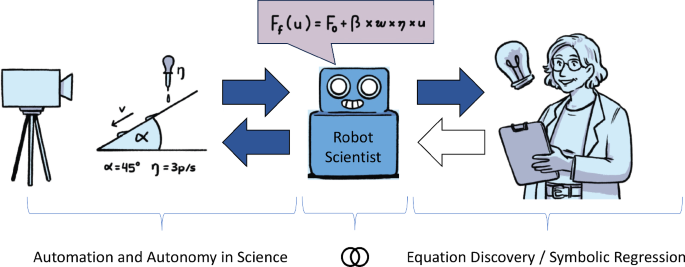
Một mạng neural có thể dự đoán khá chính xác vật liệu sẽ bền đến đâu, phân tử sẽ chạy bao xa trên bản sắc ký hay dòng chảy sẽ tiến triển thế nào. Nhưng khi nhà khoa học hỏi vì sao, câu trả lời thường nằm rải rác trong hàng nghìn hoặc hàng triệu trọng số mà con người gần như không thể đọc thành một mô hình vật lý.
Một hướng nghiên cứu đang cố thay đổi đầu ra đó. Thay vì chỉ trả về một con số, các hệ thống equation discovery và symbolic regression tìm trực tiếp những biểu thức toán học ngắn gọn mô tả dữ liệu. Trong vài tháng của năm 2026, các nhóm nghiên cứu đã dùng cách tiếp cận này để rút ra phương trình cho sắc ký lớp mỏng, hành vi cơ học của thép và lithium, dòng chảy đa thang, thậm chí để một agent dựa trên LLM tự chọn dạng phương trình rồi kiểm tra nó trên dữ liệu.
Đây không phải lần đầu máy tính tìm phương trình. Các hệ thống kiểu BACON đã làm việc này từ cuối thập niên 1970; symbolic regression bằng genetic programming xuất hiện từ nhiều thập niên trước. Điều đang thay đổi là khả năng kết hợp mạng neural, mô hình ngôn ngữ, kiến thức miền và thuật toán tìm kiếm để làm việc với dữ liệu phức tạp hơn — đồng thời trả lại kết quả ở dạng mà một nhà khoa học có thể đọc, phản biện và đưa vào thí nghiệm tiếp theo.
Khác biệt nằm ở đầu ra: một con số hay một công thức
Machine learning dự đoán và equation discovery có thể bắt đầu từ cùng một bảng dữ liệu nhưng hướng tới hai sản phẩm khác nhau.
Với mô hình hộp đen, mục tiêu thường là giảm sai số dự đoán. Nếu đưa vào thành phần hóa học, nhiệt độ và áp suất, mô hình có thể trả về một tính chất cần quan tâm. Cách làm này rất hữu ích khi nhiệm vụ chính là dự báo.
Symbolic regression lại tìm một hàm toán học gồm biến, hằng số và các phép toán như cộng, nhân, lũy thừa, logarithm hay exponential. Thuật toán phải giải đồng thời hai bài toán: tìm cấu trúc của phương trình và tìm các hệ số làm nó khớp dữ liệu.
Nếu thành công, đầu ra có thể giống loại tri thức khoa học đã quen thuộc từ lâu: một công thức có vài biến, vài tham số và một quan hệ rõ ràng giữa chúng. Người nghiên cứu có thể kiểm tra đơn vị, nhìn xem giới hạn của phương trình có hợp lý không, so sánh nó với lý thuyết đã biết và thử phá vỡ nó bằng dữ liệu mới.
Đó là lý do một bài tổng quan công bố trên tạp chí Machine Learning tháng 4/2026 coi việc tạo ra “tri thức mà con người đọc được”, đặc biệt ở dạng phương trình, là một nhánh riêng của automated scientific discovery. Các tác giả cũng chỉ ra khoảng trống hiện tại: hệ thống tự động hóa thí nghiệm ngày càng mạnh và hệ thống tìm phương trình ngày càng tốt, nhưng những nền tảng thực sự kết hợp được cả hai vẫn còn hiếm.
Trong hóa học, AI nén gần 5.000 phép đo thành những quan hệ có thể đọc
Một ví dụ rõ về giá trị của đầu ra dạng phương trình xuất hiện trong Advanced Science đầu năm 2026. Siyu Lou, Chengchun Liu và cộng sự phát triển UHSR — Unsupervised Hierarchical Symbolic Regression — để mô hình hóa thin-layer chromatography, kỹ thuật mà nhà hóa học dùng để quan sát cách một hợp chất di chuyển giữa pha tĩnh và dung môi.
Bộ dữ liệu gồm 4.944 phép đo hệ số lưu giữ Rf, 387 hợp chất hữu cơ và 17 thành phần dung môi thuộc ba hệ pha động. Một deep neural network có thể học trực tiếp từ những biến này. UHSR chọn đường vòng: trước hết gom thông tin theo cách gần với trực giác hóa học, học các biến ẩn có ý nghĩa như chỉ số lưu giữ của chất tan và dung môi, sau đó dùng symbolic regression để tìm phương trình liên kết chúng với Rf.
Nhóm giảm mô tả phân tử xuống 18 đặc trưng dựa trên nhóm chức thay vì fingerprint MACCS 167 chiều. Chỉ số chất tan ξ do hệ thống học được, khi đưa vào một mô hình XGBoost độc lập cùng đặc trưng dung môi, đạt R2 = 0,95 và RMSE 0,070 trong phép so sánh của paper; các descriptor quen thuộc như LogP, TPSA hay dipole moment cho R2 thấp hơn trong cùng thiết lập.
Phần đáng chú ý không chỉ là độ chính xác. Nhóm còn hỏi 100 nhà hóa học có trung bình khoảng 10 năm kinh nghiệm xem các biến và phương trình tìm được có hợp với trực giác chuyên môn hay không. 97% cho rằng các retention index phù hợp với kỳ vọng của họ; 99% cho rằng phương trình Rf phù hợp. Trong nhóm người có kiến thức AI ở mức cao nhất, 88,2% nói họ tin UHSR hơn mô hình machine learning truyền thống.
Những con số khảo sát này không chứng minh phương trình là “định luật mới”. Chúng cho thấy một lợi thế thực dụng hơn: AI có thể nén mô hình thành cấu trúc toán học mà nhà khoa học hiểu được và thấy đáng để kiểm tra tiếp.
Trong vật liệu, hệ thống không chỉ fit hệ số mà còn thay luôn dạng phương trình
Một bước khác xuất hiện trong Science Advances ngày 11/9/2026. GraphED của Hao Xu, Yuntian Chen và Dongxiao Zhang biểu diễn phương trình như một đồ thị: node là biến hoặc phép toán, edge là quan hệ tính toán và một số edge mang các tham số đặc trưng cho từng vật liệu.
Cách biểu diễn này cho phép hệ thống tìm một cấu trúc toán học chung nhưng vẫn fit hệ số riêng cho nhiều vật liệu. Đây là điểm khác với cách truyền thống, nơi nhà nghiên cứu thường chọn trước một công thức kiểu Johnson–Cook hay Cowper–Symonds rồi chỉ hiệu chỉnh tham số.
Trong bài toán strain-rate của thép hợp kim, GraphED được kiểm tra trên 408 nhóm dữ liệu của 40 vật liệu, trải qua tám bậc độ lớn về tốc độ biến dạng. Phương trình được chọn đạt R2 = 0,980 và mean squared error 6,9 × 10⁻⁴, tốt hơn các công thức thực nghiệm đối chứng trong bộ dữ liệu của nghiên cứu. Nhóm còn áp dụng cùng khung cho lithium kim loại và cao su hyperelastic có chất độn.
Đây chính là ranh giới giữa “AI dự đoán” và “AI đưa ra mô hình để tranh luận”. Kỹ sư không chỉ nhận một ứng suất dự đoán; họ nhận một constitutive equation có thể được cài vào solver, so với lý thuyết vật liệu và thử ở điều kiện tải mới.
Hệ thống phức tạp hơn buộc AI phải tìm nhiều công thức ở nhiều thang
Một giới hạn lớn của symbolic regression cổ điển là không gian tìm kiếm bùng nổ khi số biến và độ phức tạp tăng. Công thức thực tế cũng không nhất thiết giữ nguyên hình dạng ở mọi thang đo: chuyển động của từng hạt và phân bố thống kê của cả đàn, chẳng hạn, có thể cần hai cách mô tả khác nhau.
Deflex, được công bố trên Nature Communications tháng 6/2026, nhắm trực tiếp vào bài toán đa thang. Hệ thống dùng một dạng lambda calculus được neural network hướng dẫn để xây dựng biểu thức phức tạp theo những khối nhỏ hơn. Nhóm thử trên sáu hệ đại diện, từ mô phỏng chuyển động hạt và chất lưu tới dữ liệu chuyển động tập thể của người và chim.
Trong các thí nghiệm fluid dynamics, nhóm báo cáo Deflex có thể thu hồi phương trình Navier–Stokes từ quan sát ở thang nhỏ và các phân bố vận tốc ở thang lớn. Trên bộ Feynman Symbolic Regression Database gồm 120 công thức vật lý kinh điển có thêm nhiễu, hệ thống có hiệu năng cạnh tranh với các phương pháp symbolic regression hàng đầu xét theo trade-off giữa sai số và thời gian chạy.
Nhưng chính ví dụ này cũng cho thấy cần thận trọng với cụm “AI tìm định luật mới”. Khi một hệ thống thu hồi Navier–Stokes hay các công thức Feynman đã biết, nó đang chứng minh khả năng rediscovery — tìm lại quan hệ đúng từ dữ liệu — chứ chưa khám phá vật lý mà con người chưa biết.
LLM còn tiến thêm một bước: tự chọn lý thuyết để thử
Symbolic regression thường tìm kiếm trong một không gian toán học do nhà nghiên cứu định nghĩa trước. Một hướng khác dùng LLM như một agent có kiến thức khoa học để đề xuất dạng phương trình trước, viết code fit tham số rồi kiểm tra nó trên dữ liệu.
Samuel Onimpa Alfred và Veera Sundararaghavan tại University of Michigan trình diễn một workflow như vậy trong Computational Materials Science tháng 7/2026. Agent có thể chọn phương trình, sinh và chạy code, sau đó đánh giá mức phù hợp mà không cần con người can thiệp ở từng bước. Với các quan hệ đã biết như Hall–Petch và Paris law, agent nhận ra đúng dạng công thức và dự đoán trên dữ liệu mới.
Nhóm còn yêu cầu hệ thống xử lý một trường hợp chưa có công thức mục tiêu được cung cấp, và agent đề xuất một quan hệ phụ thuộc biến dạng cho thay đổi HOMO–LUMO gap. Đây gần với hình ảnh “AI đưa cho scientist một phương trình mới” nhất trong các ví dụ hiện tại.
Nhưng chính paper cũng ghi rõ cảnh báo quan trọng: agent đôi khi trả về phương trình sai, thiếu hoặc không nhất quán ngay cả khi numerical fit trông tốt. Một LLM cũng có thể nhớ một công thức từ dữ liệu huấn luyện thay vì thực sự suy ra nó từ thí nghiệm. Vì vậy, provenance của tri thức và khả năng kiểm tra độc lập trở thành vấn đề khoa học chứ không chỉ vấn đề AI.
Một phương trình mới chưa phải một định luật mới
Có ít nhất ba bước giữa “công thức khớp dữ liệu” và “định luật khoa học”.
Đầu tiên là generalization. Phương trình phải tiếp tục hoạt động trên dữ liệu ngoài tập dùng để tìm nó, đặc biệt ở điều kiện mà mô hình chưa nhìn thấy. Một biểu thức có thể fit hoàn hảo phạm vi nhiệt độ hẹp nhưng sụp đổ khi extrapolate.
Thứ hai là tính phù hợp vật lý. Đơn vị phải nhất quán; giới hạn khi biến tiến về 0 hoặc vô hạn phải có nghĩa; các symmetry, conservation law và ràng buộc đã biết không được bị vi phạm. Một biểu thức số học đẹp nhưng sai dimension thường không phải tri thức khoa học hữu ích.
Thứ ba là kiểm chứng bằng can thiệp hoặc thí nghiệm mới. Correlation có thể sinh ra nhiều phương trình gần tương đương trên cùng dữ liệu. Muốn nói một quan hệ phản ánh cơ chế, nhà khoa học cần thiết kế phép đo có khả năng phân biệt các giả thuyết cạnh tranh.
Bài tổng quan năm 2026 còn chỉ ra một giới hạn khác: symbolic regression vẫn khó khi số biến cao; việc liên hệ phương trình tìm được với lý thuyết hiện có còn là vấn đề mở; và foundation model có thể đã nhìn thấy các benchmark kinh điển trong dữ liệu pretraining, khiến kết quả “khám phá lại” khó diễn giải hơn.
Bước kế tiếp không phải bỏ scientist, mà đóng vòng lặp khám phá
Viễn cảnh thú vị nhất của equation discovery không phải một AI ngồi trước bảng trắng tự viết ra định luật của tự nhiên. Nó là một vòng lặp cụ thể hơn: hệ thống nhận dữ liệu, đề xuất phương trình, chỉ ra nơi các phương trình cạnh tranh khác nhau, gợi ý phép đo tiếp theo, nhận dữ liệu mới rồi loại bỏ giả thuyết không sống sót qua thử nghiệm.
Khi vòng lặp đó được nối với self-driving lab, AI có thể chuyển từ việc tìm pattern trong dữ liệu có sẵn sang chủ động yêu cầu dữ liệu có giá trị khoa học nhất. Đây cũng là khoảng trống mà các tác giả của review về automated scientific discovery nhấn mạnh: tự động hóa thí nghiệm đã tiến xa, equation discovery cũng đã tiến xa, nhưng hệ thống vừa tự chủ vừa giao tiếp bằng những representation mà nhà khoa học sử dụng vẫn chưa phổ biến.
Vì vậy, “AI tìm định luật” hiện nên được hiểu như một chương trình nghiên cứu, không phải một khả năng đã hoàn thành. Điều mới của giai đoạn hiện nay là machine learning ngày càng có thể trả lại cho nhà khoa học thứ tốt hơn một dự đoán: một phương trình đủ rõ để bị chất vấn. Và trong khoa học, khả năng bị kiểm tra, bị bác bỏ hoặc sống sót qua thí nghiệm mới chính là bước cần thiết trước khi một công thức có thể được gọi là định luật.
Nguồn: Machine Learning — Automated Scientific Discovery: From Equation Discovery to Autonomous Discovery Systems; Advanced Science — Unsupervised Hierarchical Symbolic Regression for Interpretable Property Modeling in Complex Multi-Variable Systems; Science Advances — Beyond empirical models: Discovering constitutive laws in solids with graph-based equation discovery; Nature Communications — Discovering multiscale deep formulas in complex systems via neural-guided lambda calculus; Computational Materials Science — From data to theory: Autonomous large language model agents for materials science.