Vệ tinh đang chụp nhiều hơn băng thông có thể gửi xuống Earth: Thế hệ mới sẽ tự hiểu ảnh trước khi downlink
ESA Φsat-2 đã lọc mây, phát hiện tàu và tạo bản đồ ngay trên quỹ đạo. Năm 2026, một phiên bản nén 73 MB của foundation model Prithvi còn chứng minh rằng satellite có thể dùng cùng một “bộ não” cho nhiều nhiệm vụ — chuyển Earth observation từ gửi ảnh thô về ground sang gửi trước thứ đáng chú ý.

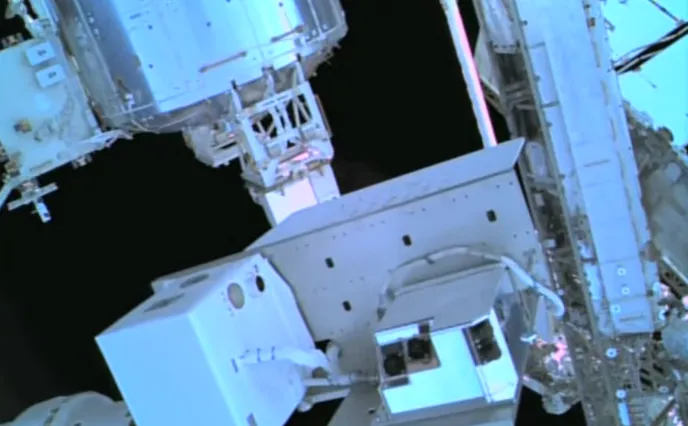
Một camera trên quỹ đạo có thể chụp Trái Đất nhanh hơn nhiều so với tốc độ satellite có thể gửi dữ liệu xuống ground station. NASA không phải cơ quan duy nhất gặp bài toán này: toàn bộ ngành Earth observation đang tăng độ phân giải, số spectral band và tần suất chụp, trong khi mỗi vệ tinh chỉ có những cửa sổ liên lạc hữu hạn và một ngân sách điện rất nhỏ cho downlink.
IBM Research mô tả riêng đội vệ tinh quan sát Trái Đất của NASA đã gửi xuống terabyte imagery mỗi ngày. Cách vận hành truyền thống là chụp trước, lưu dữ liệu, đợi bay qua ground station, downlink càng nhiều càng tốt rồi mới để server trên Earth quyết định đâu là mây, đâu là cháy rừng, tàu biển hay vùng vừa ngập.
Một thế hệ satellite mới đang thử đảo thứ tự đó. Thay vì coi spacecraft chỉ là camera và ground segment là “bộ não”, chúng mang AI lên quỹ đạo để xử lý ảnh ngay cạnh sensor. Những pixel không hữu ích có thể bị loại; ảnh quan trọng được ưu tiên; trong một số trường hợp satellite có thể gửi xuống một mask, vị trí đối tượng hoặc cảnh báo trước khi file ảnh đầy đủ tới mặt đất.
Đỉnh mới của hướng này xuất hiện năm 2026, khi một nhóm từ University of Adelaide, ESA Φ-lab, Thales Alenia Space và SmartSat đưa phiên bản nén của Prithvi — geospatial foundation model do NASA và IBM phát triển — lên môi trường quỹ đạo. Đây là bước chuyển từ những AI app chỉ biết một việc sang một backbone có thể được tái sử dụng cho nhiều nhiệm vụ Earth observation.
Downlink mới là “ống cổ chai” của một camera cách Earth hàng trăm kilomet
Ở data center, nếu model tạo thêm vài gigabyte dữ liệu, hệ thống có thể ghi vào SSD hoặc đẩy qua mạng quang tốc độ cao. Satellite không có sự xa xỉ đó. Nó phải dùng radio, anten công suất giới hạn và những khoảng thời gian cụ thể khi ground station nằm trong vùng nhìn thấy.
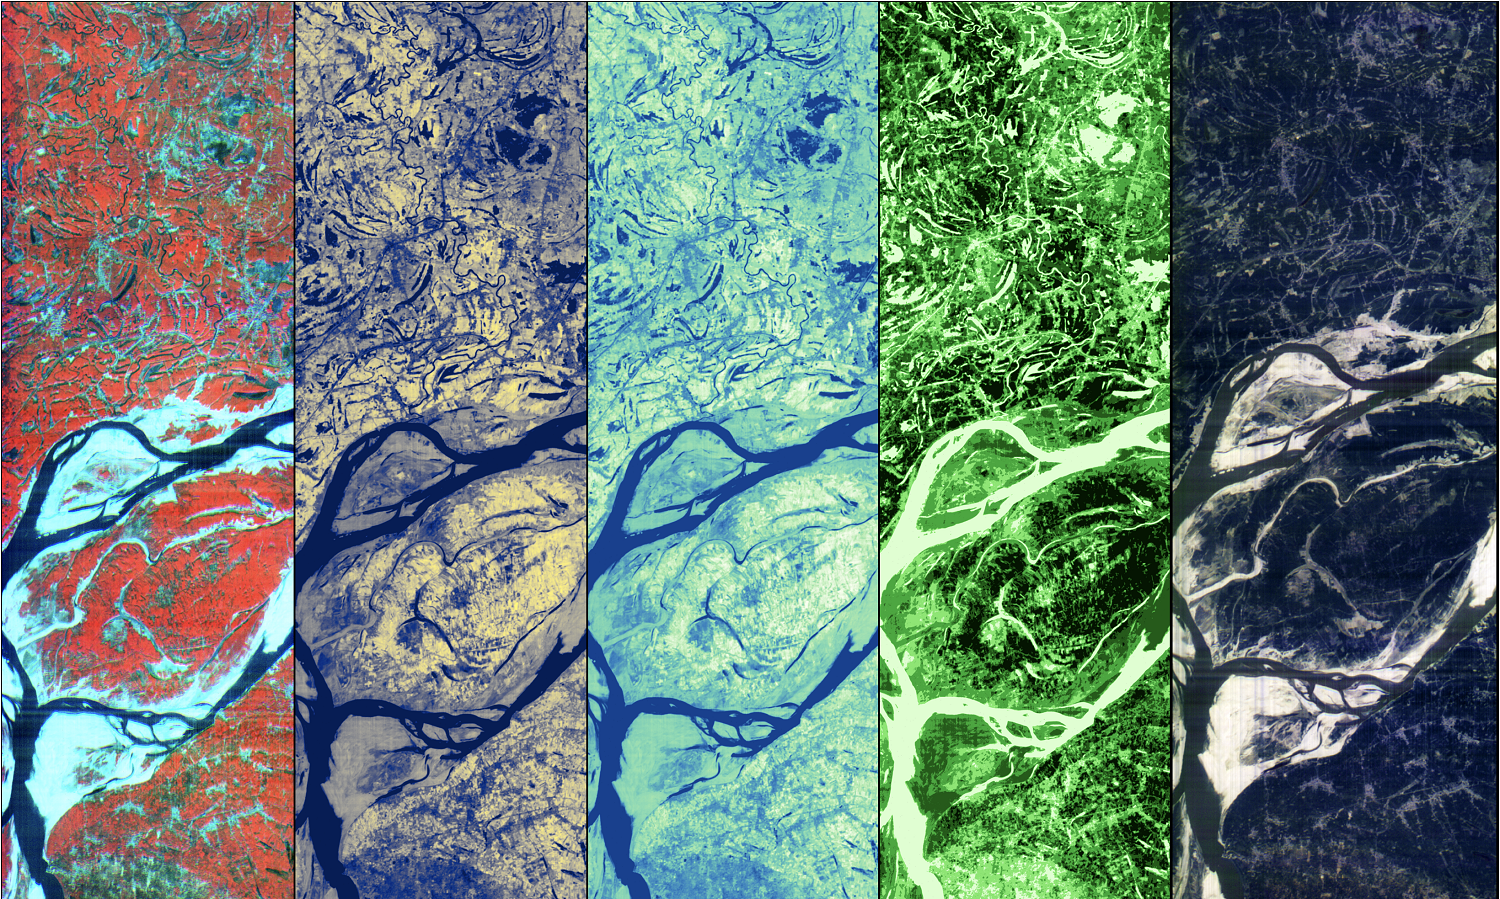
Vấn đề trở nên tệ hơn khi sensor chuyển từ RGB sang multispectral hoặc hyperspectral. Φsat-2 của ESA chỉ là một CubeSat 6U kích thước khoảng 22 × 10 × 33 cm nhưng camera đã thu đồng thời tám band, với ground sampling distance khoảng 5 mét. IMAGIN-e trên International Space Station còn mang cả cảm biến visible và hyperspectral.
Không phải mọi ảnh thu được đều đáng gửi. Với optical Earth observation, mây là ví dụ rõ nhất. Một scene bị che gần hết có thể chiếm gần bằng băng thông của scene trong trẻo nhưng mang ít giá trị cho nhiều ứng dụng. Nếu thuật toán biết điều đó ngay trên satellite, đường truyền có thể dành cho dữ liệu hữu ích hơn.
Đây là logic của space edge computing: đưa một phần computation đến nơi dữ liệu được tạo ra, tương tự camera an ninh chạy object detection ngay tại edge thay vì stream mọi frame lên cloud.
Φsat-2 đã đi từ “chụp rồi gửi” sang “chụp, phân tích rồi quyết định gửi gì”
ESA phóng Φsat-2 tháng 8/2024 và đưa satellite vào science phase năm 2025. Thay vì một model duy nhất, spacecraft chạy nhiều AI application chuyên biệt.
Một app phát hiện cloud để chọn ảnh rõ và loại những scene không sử dụng được. Một app khác nhận diện và phân loại tàu biển. Sat2Map biến imagery thành street map phục vụ disaster response. Các application khác tập trung vào wildfire, marine anomaly và deep image compression.
Điều này đã vượt khỏi việc “nén JPEG trên quỹ đạo”. Một satellite có thể nhìn một ảnh và gắn ý nghĩa operational cho nó: đây là đám cháy; đây có tàu; đây là đường có thể đi qua sau lũ. Trong disaster response, vài chục phút latency có thể quan trọng hơn việc giữ lại từng pixel nguyên bản.
Một paper IEEE tháng 8/2026 về cloud detection trên phần cứng đại diện cho satellite cho thấy pipeline AI có thể xử lý một full image trong khoảng 0,359 giây trên Jetson Xavier NX, nhanh hơn nhiều so với khoảng cách 12,11 giây giữa hai frame trong mô phỏng quỹ đạo của nghiên cứu. Tác giả báo cáo throughput của imagery hữu ích tăng khoảng 9 lần trong simulation. Đây là hardware-in-the-loop result chứ chưa phải một mission đã bay, nhưng nó cho thấy inference không nhất thiết phải là phần chậm của pipeline.
Bước khó hơn: thay sáu AI app bằng một foundation model có thể học nhiều việc
Kiến trúc kiểu Φsat-2 có một nhược điểm: mỗi nhiệm vụ mới thường cần một model mới. Muốn satellite ngày mai biết map flood thay vì chỉ detect cloud, operator có thể phải train, validate rồi uplink thêm network và runtime mới.
Foundation model đưa ra một cách khác. Prithvi-EO-2.0 được pretrain trên hàng triệu sequence từ dữ liệu Harmonized Landsat–Sentinel-2 và có các phiên bản 300 triệu, 600 triệu tham số. Sau pretraining, cùng một representation có thể được fine-tune cho flood mapping, burn scar, land cover, biomass và nhiều nhiệm vụ khác.
Nhưng một model 300 triệu tham số khoảng 1,2 GB là quá nặng cho nhiều computer trên satellite. Nhóm nghiên cứu vì thế dùng knowledge distillation để thu nhỏ Prithvi. Biến thể mang tên 256-MAE-D giảm embedding dimension từ 1024 xuống 256 và giảm footprint khoảng 16 lần, từ 1,2 GB xuống 73 MB.
Trong benchmark của preprint, phiên bản nhỏ vẫn gần bằng model gốc trên năm task gồm cloud classification, cloud segmentation, flood, landslide và above-ground biomass estimation. Sai khác ở cloud detection dưới một điểm phần trăm; biomass RMSE nằm trong khoảng 3% so với baseline.
Ý nghĩa quan trọng hơn kích thước file là cách cập nhật mission. Nếu backbone foundation model đã nằm trên satellite, một nhiệm vụ mới có thể chỉ cần uplink một task head nhỏ thay vì cả network. NASA nhấn mạnh đây là lợi thế lớn vì active satellite thường khó nhận những software package lớn qua đường uplink hạn chế.
“Foundation model đầu tiên trên quỹ đạo” vẫn là một demonstration có giới hạn
NASA tháng 5/2026 mô tả Prithvi là geospatial foundation model đầu tiên được triển khai trong môi trường quỹ đạo, với thử nghiệm gắn tới Kanyini của South Australia và payload IMAGIN-e trên ISS. Nhưng paper kỹ thuật cho thấy kết quả cần được đọc cẩn thận hơn headline.
Trên Kanyini, nhóm không thể chạy trực tiếp GeoFM trên spacecraft trong thử nghiệm vì một technical anomaly ở interface của Earth-observation payload. Họ thay vào đó xác nhận deployment trên HyperScout-2 engineering model có phần cứng tương đương flight unit.
Trên IMAGIN-e, model thực sự được chạy trên compute module ở ISS. Tuy nhiên camera gặp power fault trong cửa sổ thử nghiệm, nên nhóm phải uplink một curated test set thay vì lấy ảnh mới trực tiếp từ sensor. Inference trên quỹ đạo cho kết quả gần như giống ground validation, chứng minh runtime và model có thể hoạt động trong môi trường space, nhưng chưa phải một closed loop hoàn chỉnh sensor → foundation model → quyết định downlink trên imagery live.
Thử nghiệm cũng lộ ra một hạn chế rất thực tế: khi GeoFM dùng CPU quá nặng, compute module tiến gần thermal limit và tự shutdown. Nhóm phải giảm số CPU core đang hoạt động để giữ nhiệt độ ổn định. Đây là lời nhắc rằng “đưa AI lên satellite” không chỉ là bài toán model size; watt và nhiệt đôi khi quan trọng hơn TOPS.
Satellite có thể “hiểu” ảnh, nhưng không nên xóa mọi thứ nó cho là vô ích
Khái niệm satellite “tự hiểu mình đang nhìn gì” cũng cần đặt đúng nghĩa. Những hệ hiện nay không hiểu cảnh như một con người xem ảnh. Chúng thực hiện classification, segmentation, object detection hoặc anomaly detection trên những loại dữ liệu và task được định nghĩa trước.
Điều này tạo ra một trade-off mới. Nếu cloud detector nhầm một scene hiếm thành mây và xóa nó trước khi downlink, dữ liệu có thể mất vĩnh viễn. Nếu wildfire model bỏ sót đám cháy nhỏ, ground analyst không có raw image để sửa lại quyết định đó. Với science mission, một measurement tưởng vô dụng hôm nay có thể trở thành dữ liệu quan trọng cho nghiên cứu mười năm sau.
Vì vậy, kiến trúc hợp lý không nhất thiết là “AI quyết định rồi xóa mọi raw data”. Satellite có thể dùng AI để ưu tiên: gửi alert hoặc thumbnail trước, downlink full scene khi bandwidth cho phép, giữ raw data một khoảng thời gian trong onboard storage, hoặc chỉ loại những category có confidence rất cao.
Mission design còn phải xác định cost của false positive và false negative. Với cloud filtering, gửi thừa vài scene chỉ tốn bandwidth. Với wildfire detection, bỏ sót một event có thể đắt hơn nhiều. Cùng một model không thể dùng cùng threshold cho mọi application.
Domain gap là vấn đề khi model từng học Earth qua một camera khác
Một GeoFM được train trên Sentinel-2 không tự nhiên hiểu hoàn hảo sensor mới. Lens, spectral response, noise, spatial resolution và calibration đều khác nhau. Paper Prithvi gọi đây là domain gap.
Kanyini tạo 50 VNIR band, nhưng pipeline thử nghiệm chỉ dùng bốn band RGB + near-infrared để tương thích với model. Nhóm phải domain-adapt task head bằng imagery từ chính mission để cải thiện cloud và flood detection. Điều đó cho thấy foundation model giúp giảm lượng training cần thiết, chứ không xóa nhu cầu calibration và validation trên dữ liệu thật.
ESA năm 2026 thậm chí đang thử một hướng cực đoan hơn cho Φsat-2: pretrain một geospatial foundation model chỉ khoảng 200.000 tham số, được thiết kế từ đầu cho giới hạn compute trên spacecraft. Project chạy từ tháng 4 đến tháng 9/2026 và đánh giá land-use/land-cover, flood và cloud task trên dữ liệu Sentinel-2, simulated Φsat-2 và telemetry thật. Publication vẫn đang được chuẩn bị, nên đây chưa phải kết quả peer-reviewed, nhưng nó cho thấy “foundation model” trong space có thể nhỏ hơn model trên data center hàng nghìn lần.
Bước tiếp theo: satellite không chỉ phân tích ảnh, mà còn quyết định nên chụp gì tiếp
Nếu onboard AI chỉ lọc dữ liệu sau khi camera đã chụp, nó đã tiết kiệm downlink. Nhưng lợi ích lớn hơn xuất hiện khi inference quay ngược trở lại mission planning.
Một satellite phát hiện smoke có thể ưu tiên giữ các frame kế tiếp. Một constellation phát hiện flood trên một spacecraft có thể yêu cầu satellite khác chụp cùng vùng bằng sensor khác. AI có thể điều chỉnh compression, tasking hoặc downlink priority theo event thay vì chờ ground operator lập kế hoạch ở orbit sau.
ESA đang chuẩn bị EOCognitiveLab theo đúng hướng này: một môi trường hai satellite với onboard processing, inter-satellite links, cooperative sensing, event-based acquisition replanning và thử nghiệm onboard federated learning/fine-tuning. Đây vẫn là chương trình tương lai, không phải khả năng đang vận hành đại trà, nhưng nó cho thấy đích đến không chỉ là “AI trong camera”.
Satellite Earth observation vì thế đang trải qua thay đổi giống smartphone hai thập kỷ trước. Camera không còn chỉ tạo pixel; compute ngày càng nằm sát sensor để biến pixel thành thông tin trước khi mạng phải gánh dữ liệu.
Trong ngắn hạn, raw imagery sẽ không biến mất. Ground processing vẫn mạnh hơn, dễ cập nhật hơn và cần thiết cho scientific archive. Nhưng với wildfire, flood, maritime monitoring hay disaster response, thế hệ satellite mới có thể gửi xuống một thứ quan trọng trước file ảnh: câu trả lời về điều gì vừa xảy ra dưới mặt đất.
Nguồn: NASA – Prithvi becomes first geospatial foundation model in orbit; First On-Orbit Demonstration of a Geospatial Foundation Model; ESA – Φsat-2 science phase; ESA – Φsat-2 multispectral imager; Thales Alenia Space – IMAGIN-e; IEEE GRSL – Real-Time Onboard AI for Remote Sensing: Cloud Detection; ESA Φ-lab – onboard-constrained GeoFM for Φsat-2; ESA Φ-lab – EOCognitiveLab; IBM Research – Prithvi and NASA Earth imagery.