Camera hiện tạo hàng triệu pixel rồi AI mới đọc chúng: LightTok biến ánh sáng thẳng thành “token”, giảm mạnh năng lượng token hóa
Prototype LightTok 32×32 pixel dùng phototransistor MoS₂ vừa cảm quang, lưu trữ vừa tính toán để tạo patch embedding ngay trong cảm biến. Trên CIFAR-10, nhóm nghiên cứu báo cáo độ chính xác 87,3% và mức tiêu thụ năng lượng ở khâu token hóa thấp hơn 14,3 lần so với tokenizer số.

Một camera thông thường làm khá nhiều việc trước khi mô hình AI thực sự “nhìn” thấy thứ gì. Ánh sáng được cảm biến biến thành tín hiệu điện, tín hiệu được số hóa thành hàng loạt giá trị pixel, dữ liệu được lưu và chuyển sang bộ xử lý, rồi ảnh mới được chia thành các vùng nhỏ để biến thành những vector mà Vision Transformer có thể đọc.
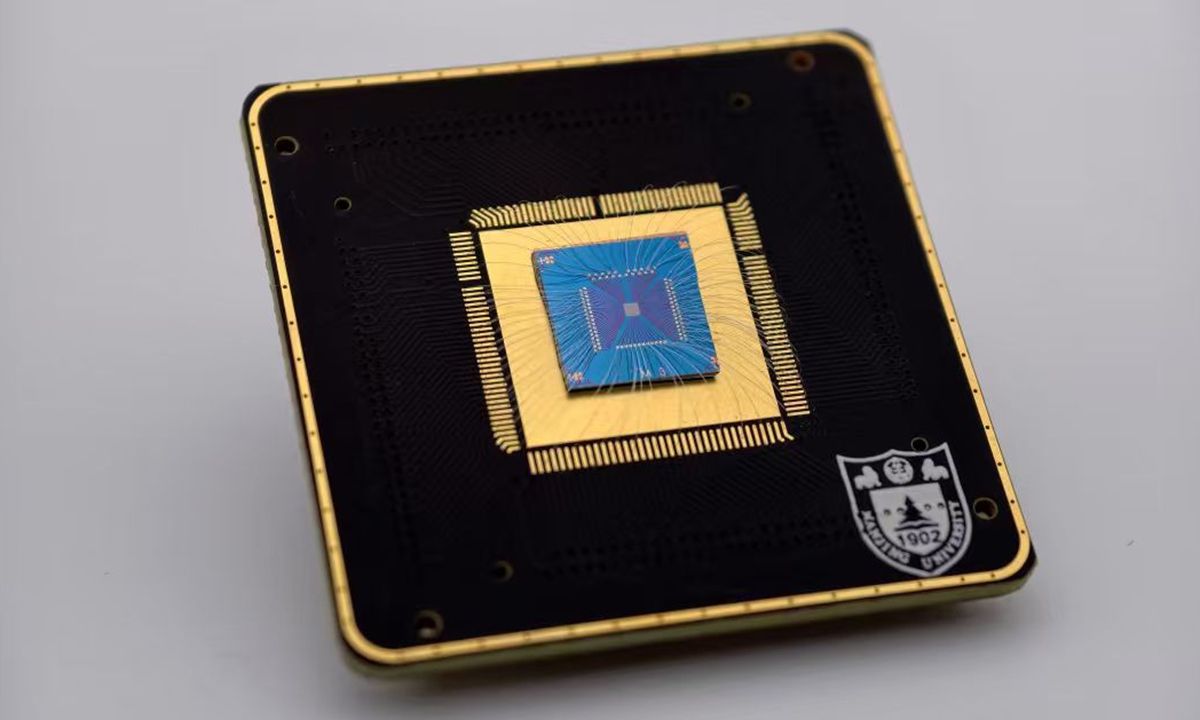
Một nhóm nghiên cứu do Đại học Nam Kinh dẫn dắt, phối hợp với Đại học Quốc gia Singapore và các đơn vị khác, vừa thử một cách khác: tạo ra các “token” ngay tại nơi ánh sáng chạm vào cảm biến. Prototype có tên LightTok được mô tả trong bài báo đăng trên Nature Sensors ngày 19/8/2026. Thay vì tách cảm quang, lưu trữ và tính toán thành nhiều khâu, thiết bị gộp cả ba chức năng vào một mảng phần tử quang điện.
Kết quả đáng chú ý nhất không phải là độ phân giải. LightTok hiện chỉ có 32×32 pixel, tức 1.024 điểm ảnh nhạy sáng. Điểm mới nằm ở cách dữ liệu đi qua hệ thống: nhóm nghiên cứu báo cáo rằng bộ “physical tokenizer” này tiêu thụ năng lượng thấp hơn 14,3 lần so với tokenizer số trong phép so sánh của họ, trong khi vẫn đạt độ chính xác gần mức của pipeline phần mềm trên CIFAR-10. Con số này chỉ áp dụng cho khâu token hóa, không có nghĩa toàn bộ camera hay toàn bộ hệ thống AI dùng ít điện hơn 14,3 lần.
Vì sao AI hiện phải đi đường vòng qua pixel?
Vision Transformer không xử lý ảnh theo đúng cách con người nhìn một tấm hình. Trước hết, ảnh số thường được chia thành các ô nhỏ, hay patch. Mỗi patch sau đó được biến đổi thành một vector số — patch embedding — và vector này trở thành một token đầu vào cho Transformer.
Nói cách khác, một hệ thống thị giác hiện đại thường tạo ra một ảnh số hoàn chỉnh trước, rồi mới chuyển ảnh đó sang biểu diễn phù hợp với mô hình. Quá trình này kéo theo nhiều bước: cảm biến ảnh, chuyển đổi analog-sang-digital, bộ đệm, truyền dữ liệu, chia patch và phép nhân ma trận để tạo embedding.
Vấn đề đặc biệt rõ ở thiết bị biên như drone, robot nhỏ hay cảm biến hoạt động bằng pin. Chúng có thể liên tục thu rất nhiều dữ liệu hình ảnh nhưng chỉ cần một phần thông tin đó cho nhiệm vụ nhận dạng. Việc số hóa và di chuyển toàn bộ dữ liệu pixel trước khi bắt đầu suy luận tạo ra chi phí năng lượng và băng thông mà bản thân mô hình không nhất thiết cần.
Các tác giả của nghiên cứu đặt câu hỏi theo hướng phần cứng: nếu mô hình cuối cùng cần token, tại sao cảm biến nhất thiết phải xuất ra ảnh RGB hoàn chỉnh?
Một pixel của LightTok làm ba việc cùng lúc
LightTok được xây dựng từ mảng bộ nhớ nhạy sáng 32×32 dựa trên phototransistor cổng nổi bằng molybdenum disulfide đơn lớp, hay MoS₂. Trong cấu trúc này, mỗi phần tử có thể cảm nhận ánh sáng, giữ trạng thái dưới dạng điện tích và tham gia tính toán analog.
Khi ánh sáng chiếu vào, thông tin quang học không chỉ được đo rồi gửi đi nơi khác. Nó có thể được lưu cục bộ dưới dạng trạng thái không bay hơi. Mạch địa chỉ ngoại vi sau đó chọn các vùng pixel tương ứng với từng patch. Với mỗi vùng được chọn, hệ thống áp dụng một chuỗi điện áp để kết hợp dữ liệu ánh sáng đã lưu với ma trận embedding ngay trong miền analog.
Dòng điện đầu ra của phép tính này đóng vai trò biểu diễn token cho Vision Transformer. Vì vậy, thiết bị không “hiểu” cảnh vật theo nghĩa nó đã hoàn thành toàn bộ bài toán AI trong cảm biến. Nó mới thay thế phần đầu của pipeline: từ ánh sáng tới patch embedding. Phần Transformer encoder và các lớp xử lý phía sau vẫn còn.
Đây cũng là lý do từ “token” cần được hiểu cẩn thận. Token ở đây không phải một nhãn ngữ nghĩa kiểu “con mèo” hay “chiếc xe”, và cũng không giống trực tiếp token văn bản trong mô hình ngôn ngữ. Nó là biểu diễn số của một vùng ảnh, được tạo ra ở định dạng mà Transformer có thể tiếp tục xử lý.
14,3 lần ít năng lượng hơn đang đo điều gì?
Theo phần tóm tắt của bài báo Nature Sensors, khi tích hợp physical tokenizer vào một pipeline Vision Transformer tiêu chuẩn, nhóm nghiên cứu ghi nhận mức tiêu thụ năng lượng thấp hơn 14,3 lần so với một tokenizer số. Báo cáo của Đại học Nam Kinh cho biết hệ thống đạt độ chính xác nhận dạng 87,3%, gần mức baseline của phần mềm truyền thống trong thử nghiệm.
Điểm cần giữ lại là phạm vi của phép đo. Nghiên cứu không chứng minh một chiếc drone hoàn chỉnh sẽ bay lâu hơn 14,3 lần, cũng không cho thấy mọi tác vụ thị giác sẽ có mức tiết kiệm tương tự. Phần năng lượng được so sánh là quá trình đưa dữ liệu ảnh sang token. Encoder, bộ nhớ hệ thống, điều khiển, truyền thông và các phần còn lại của thiết bị vẫn tiêu thụ điện.
Dù vậy, hướng tiếp cận có ý nghĩa vì chi phí di chuyển dữ liệu đang trở thành một nút thắt của phần cứng AI. Khi cảm biến, bộ nhớ và phép tính nằm ở các khối riêng biệt, dữ liệu phải liên tục được chuyển qua giao tiếp và bộ nhớ. LightTok cố giảm chính phần di chuyển đó bằng cách để dữ liệu được cảm nhận, giữ lại và biến đổi ngay tại cùng một vùng phần cứng.
Prototype 32×32 pixel còn cách camera thực tế rất xa
Giới hạn lớn nhất hiện tại rất dễ thấy: 32×32 pixel là một prototype nghiên cứu, không phải cảm biến hình ảnh sẵn sàng thay thế camera điện thoại hay camera công nghiệp. Một cảm biến thương mại có thể chứa hàng triệu hoặc hàng chục triệu pixel, kèm theo yêu cầu nghiêm ngặt về độ đồng đều, nhiễu, tốc độ đọc, yield, nhiệt độ hoạt động và độ bền.
Chính nhóm tác giả cũng mô tả quá trình scale mảng phần tử là một khó khăn cốt lõi. Trong bài viết “Behind the Paper” trên Springer Nature Research Communities, họ cho biết những vấn đề khó chỉ lộ rõ khi thiết bị đơn lẻ được ghép thành hệ thống lớn: yield của từng phần tử ảnh hưởng trực tiếp đến độ chính xác tính toán, còn mạch điều khiển ngoại vi phải được khớp chặt với đặc tính của thiết bị.
MoS₂ đơn lớp cũng đưa nghiên cứu sang bài toán sản xuất vật liệu hai chiều ở quy mô wafer. Đại học Nam Kinh cho rằng kiến trúc có thể tích hợp với công nghệ CMOS và về nguyên tắc mở rộng lên kích thước lớn hơn, nhưng đó vẫn là mục tiêu tiếp theo chứ chưa phải năng lực đã được chứng minh ở độ phân giải camera thương mại.
Câu hỏi lớn hơn: cảm biến trong kỷ nguyên AI nên xuất ra gì?
LightTok đáng chú ý vì nó thay đổi giao diện giữa thế giới vật lý và mô hình AI. Camera số được thiết kế để tạo ra ảnh mà máy tính có thể lưu, hiển thị và xử lý. Nhưng nếu một hệ thống chỉ cần đưa dữ liệu vào Transformer để nhận dạng hoặc điều khiển robot, ảnh RGB hoàn chỉnh có thể không phải lúc nào cũng là biểu diễn hiệu quả nhất.
Nhóm nghiên cứu cũng không cho rằng mọi camera tương lai nên bỏ pixel để chỉ xuất token. Ảnh truyền thống vẫn cần thiết cho con người quan sát, lưu trữ, chỉnh sửa và nhiều loại thuật toán khác. Ý tưởng thực tế hơn là một số cảm biến chuyên dụng có thể tạo trực tiếp biểu diễn mà tác vụ phía sau cần, đặc biệt ở hệ thống edge AI luôn phải cân bằng độ trễ, băng thông và pin.
Vì vậy, bước tiếp theo quan trọng không phải là chứng minh thêm rằng ánh sáng có thể được biến thành token — prototype đã làm được điều đó. Thách thức là tăng số pixel lên nhiều bậc mà vẫn giữ được độ đồng đều thiết bị, độ chính xác tính toán và lợi thế năng lượng. Chỉ khi vượt qua được phần sản xuất và tích hợp đó, “light-to-token” mới có cơ hội rời khỏi một mảng 1.024 pixel trong phòng lab để trở thành kiến trúc hữu ích cho drone, robot hay cảm biến tự hành ngoài thực tế.